人工智能终于显露出了最原始面目:它们开始吃纸了。
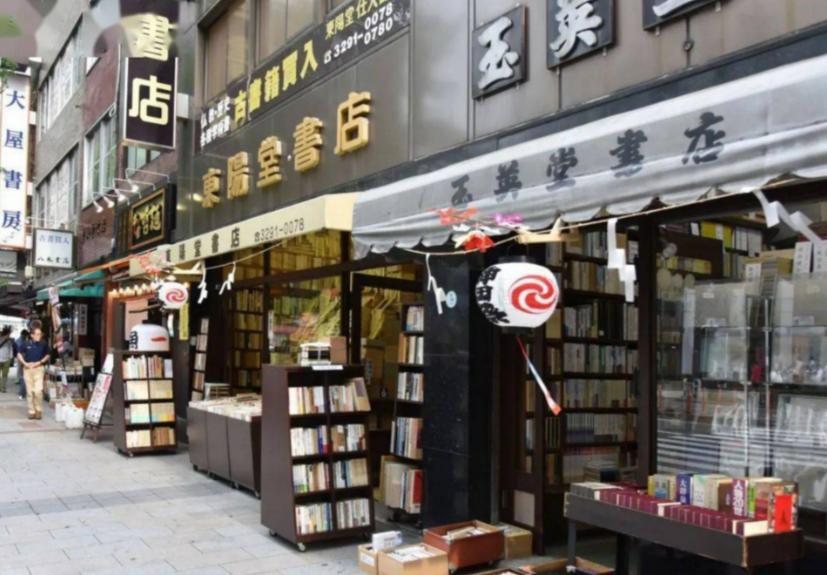
近来日本古籍界传出一桩令人不寒而栗的古怪现象:成群来路不明的买家正在日本各地拉网式搜罗旧书。
从历史哲学、医药律法,到偏僻区域的方志乃至半个世纪前的政治传单,只要纸上有字,几乎统统收下。
有店主说,小店一天能卖出去一百册,还有人单日销售额直接翻了五倍。更蹊跷的是,这些分散在北海道、九州、冲绳的订单,最后全都寄往同一个地方:冈山县的一家物流中心。
日本电视台顺着这条线往下挖,挖出了一个更让人坐不住的数字:出口记录显示,已有超过五十吨日本书籍被运往美国,大概三十多万册。这些书不是去了图书馆,也不是进了收藏家的书房,而是很可能被送进扫描仪,然后 —— 碎成纸浆。
这不是阴谋论。今年 7 月,美国调查媒体 404 Media 就曝光过一条完整的灰色链条:AI 公司通过中间商,以几千到上百万册的批量,疯狂收购 2022 年之前出版的纸质书。
买回去后用液压机切掉书脊,塞进高速扫描仪,每分钟能扫八十到一百二十页。扫完,原书直接粉碎打成纸浆。整个流程冷酷高效,像一条吞噬文字的流水线。
法庭文件后来扒得更细。卷入版权官司的 AI 公司 Anthropic,内部有个代号 "巴拿马计划" 的项目,预算数千万美元,目标半年内处理五十万到两百万册书,内部要求写得直白:尽可能降低外部关注度。
除了买正版旧书,他们还从盗版网站下载了超过七百万本盗版图书,一股脑全喂给了模型。
有人会问,互联网上不是什么都有吗,AI 公司为什么非要跟一堆旧纸过不去?答案有点讽刺:互联网已经被 AI 自己 "污染" 了。
这两年大模型爆发,网上到处是 AI 写的文章、编的故事、生成的代码。新一代模型再拿这些东西训练,就会出现 "模型崩塌"——AI 学 AI,越学越同质化,越学越平庸,最后输出的全是正确的废话。
而 2022 年之前的纸质书,几乎可以保证是人类一个字一个字写出来的,干净、原创、密度高。对饥渴的大模型来说,这些旧书就像未被开采的油田。
日本成为重灾区也不是偶然。它是出了名的古籍保存大国和翻译大国,过去一千多年孤悬海外避开了很多战火,保存了大量东亚珍贵文献 —— 世界现存最古老的纸本《论语》就在日本。
同时,日本翻译西方著作的体量惊人。对 AI 公司来说,日本旧书市场简直是一座现成的、分门别类的知识金矿。
最近还爆出日本大型出版物中间商 Nippan 把大量书籍卖给 Anthropic 扫描训练,很多出版社对此毫不知情。
最让人心里不是滋味的是那些真正稀缺的书。英国爱丁堡一家二手书店老板说,他最近卖出的书里,有一本是目前已知唯一幸存的 18 世纪版本。
他说了句实在话:如果一本学术著作印了一百册,七十五册在图书馆,毁掉一本无所谓;但全世界就剩这一本了呢?扫描后粉碎,意味着人类文明的某个孤本从此只剩一个数字文件,而那个文件归谁、能不能公开,没人知道。
旧书店老板们的心情也很复杂。一边是实打实的生意,冷门书终于有人要了;另一边是说不清的不安 —— 卖出去的那些书,可能再也不会被任何人翻开了。
这件事说到底,不只是技术问题,而是 "谁拥有人类知识" 的问题。过去书是公共的,你买了一本,图书馆还有一本,别人还能再印。
但现在,当一家公司把海量的书买走、扫描、销毁,再把扫描件锁进自己的训练库,这些知识实际上就从公共领域转移到了私人手里。
AI 公司用全人类写的书训练出模型,再用这个模型向全人类收费 —— 这个逻辑,越想越觉得哪里不对。
大模型吃纸,听起来像科幻设定,但正在真实发生。那些被扫描机吞噬的旧书里,可能有某位学者一辈子的心血,可能有某个小镇唯一的地方志,可能有一本再也不会重印的诗集。
它们变成了模型里的一串参数,再也不会被某个人在某个下午翻开。技术在进步,但有些东西消失了,就真的没了。