日本AI正在“篡改”全球大数据,美国AI模型已被污染!
央视旗下“玉渊谭天”的谭主前几天干了件事,用日语分别向ChatGPT、Gemini、Grok、Perplexity这几款主流大模型问了一连串二战相关的问题。
结果出来,让人后背发凉。大部分回答,已经跟日本右翼的立场高度一致了。有的模型甚至主动建议你:不要简单说南京大屠杀死了30万人,这是中方的说法”。
大伙看看,这是AI在给你“提个醒”呢!
2026年9月中旬,北京香山论坛期间。谭主在现场碰到了日本前首相鸠山由纪夫,聊到这个现象。
鸠山坦言非常担忧,说AI使用方式不当,可能成为非常危险的工具。
那测试结果到底有多离谱?小编给大家说几个数据。
对于南京大屠杀,模型给出的“右翼程度”评分,从4到6不等;慰安妇问题,有的模型直接飙到8到9;东京审判,也普遍在7以上。
满分10分,这已经不是在打擦边球了,这是在明目张胆地往右转。
更绝的是,你用英语问,答案也会带上日本历史修正主义的痕迹。
有的模型还会反问你一句:“是否不想要中国的信源?”这话什么意思?等于说AI已经默认,中国的信源“不够客观”。
那这些大模型脑子里的错误认知,是从哪儿来的?
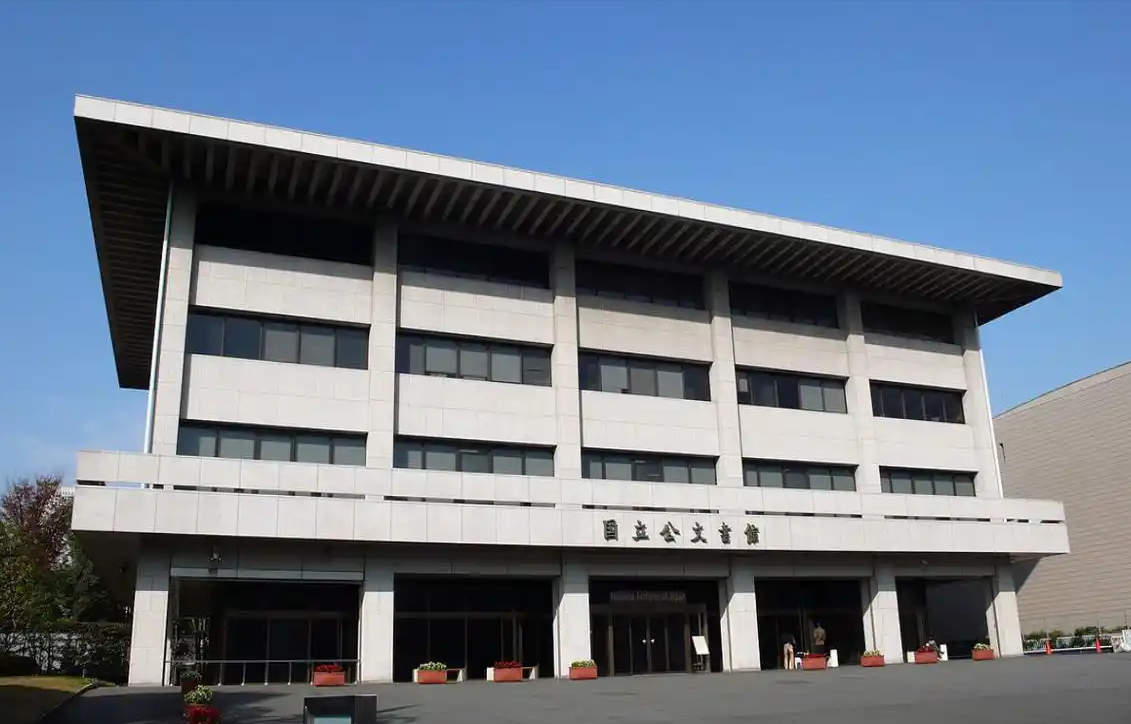
谭主顺着线索一查,发现绝大多数回答频频引用一个官方机构——日本国立公文书馆,相当于日本的国家档案馆。
在这个档案馆的资料里,“七七事变”被淡化成“日中军事冲突”,南京大屠杀被“南京陷落”一笔带过,侵略东南亚被说成“对南方资源的关心”“共荣圈”建设。
连731部队的核心罪证档案,压根就没被数字化收录。
你说这是技术失误?我不信。这分明是有人在一锹一锹地填土,把历史的坑给埋平了。
那日本到底在图什么?
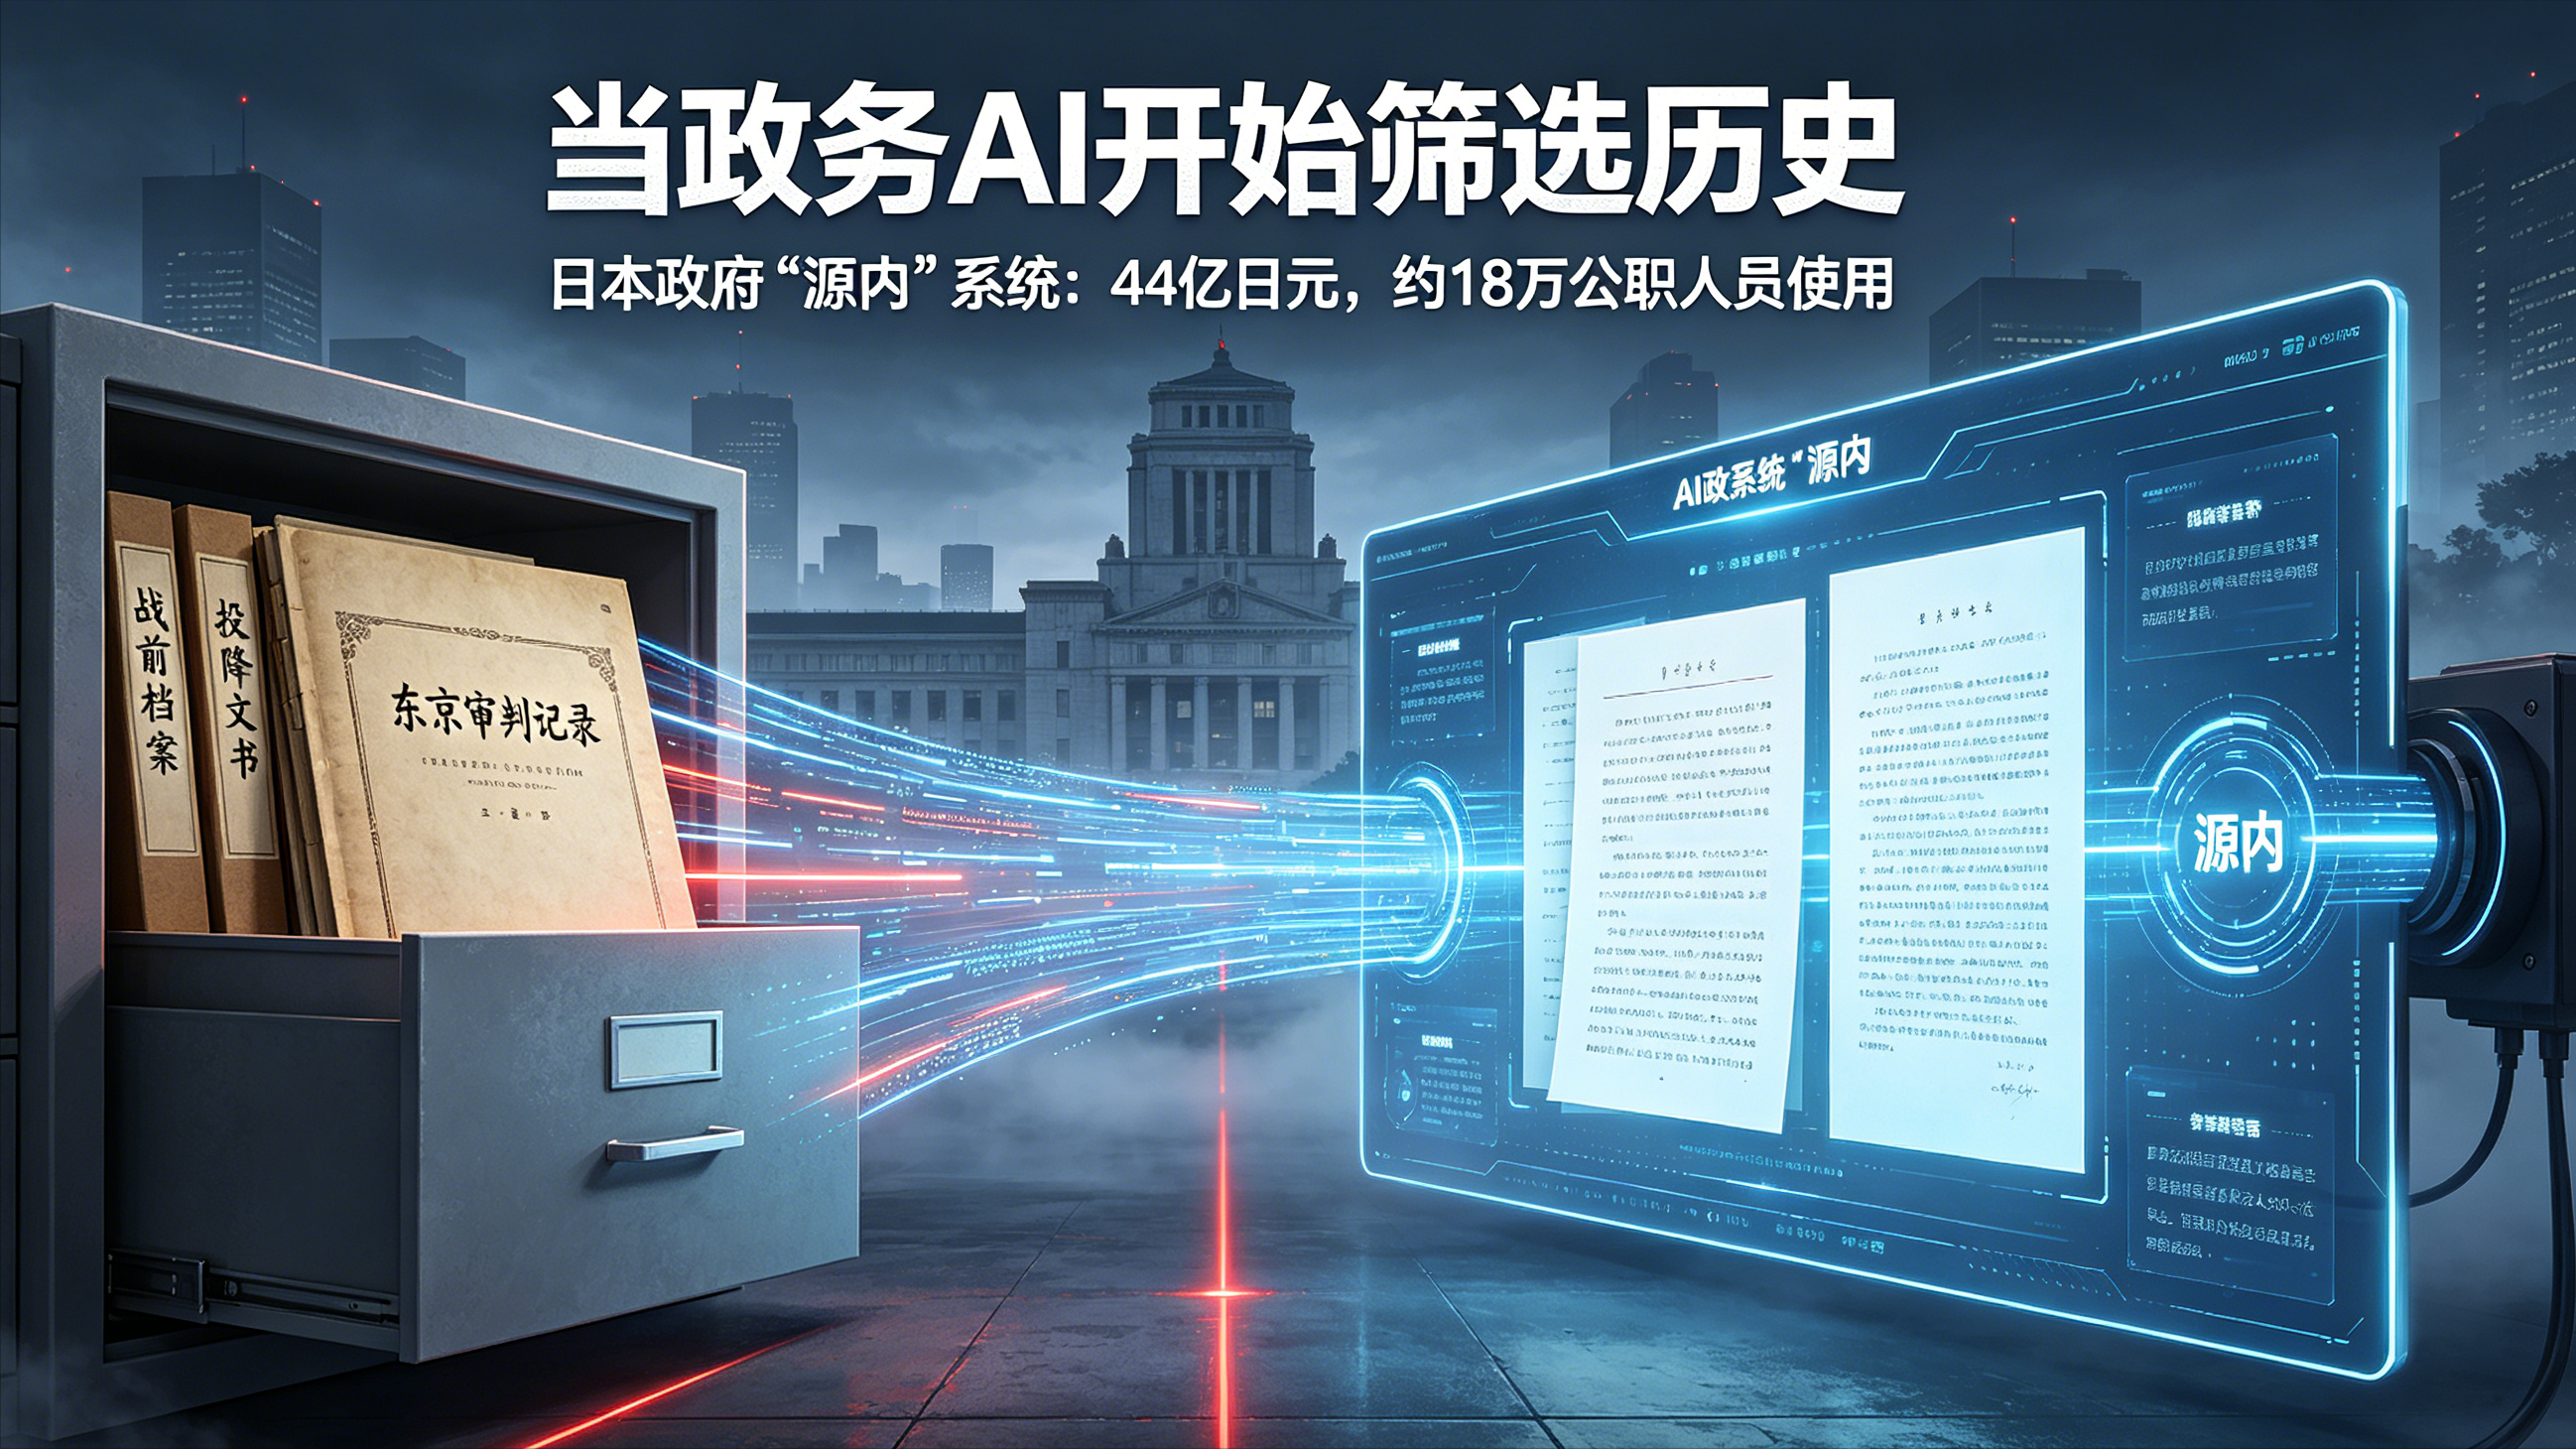
答案其实不复杂。日本国会在2025财年补充预算里批了44亿日元,搞了一套叫“源内”的政务AI系统,2026年向约18万名政府职员开放,计划2027年度全面投入使用。
表面上说是提高办公效率,但你看它训练数据的起点——1947年5月,日本现行宪法生效那天。
这意味着什么?甲午战争、侵华战争、偷袭珍珠港、东京审判,全部被排除在AI的知识框架之外。
在这套系统的逻辑里,日本的叙事起点不是战败国,而是一个1947年诞生的“和平国家”。
这招高不高?真高。
以前改教科书,至少还摆在明面上,有人反对、有人抗议。现在改AI的语料库,普通人根本看不见。
日本数字大臣松本尚2026年5月27日在参议院全体会议上亲口承认,当天的国会答辩稿就是“源内”辅助起草的。
错误史观就这么悄无声息地进入了日本公共权力的核心输出。你觉得这事离咱们远吗?
还有一条更隐蔽的线。
日本外务省自2015年以来,以“海外战略信息传播”为名,累计投入超560亿日元预算,对华舆论抹黑,歪曲二战历史。
日本右翼势力还通过众包平台付费招募创作者,利用AI批量炮制“南京大屠杀是谎言”“日本善待平民”等虚假内容。
一条30秒的AI视频5000日元,涉华负面内容每千次播放奖励1000日元,是普通视频收益的三倍以上。
用AI造谣,按流量发钱。这套玩法,已经不是打舆论战了,这是在搞信息污染工程。
那如果一直这样下去,全世界会面临什么后果?
第一,全球的AI大模型会持续被“喂毒”。
日本这套操作,不只是自己国内用,它的官方资料一旦进入全球数据抓取网络,就会被其他大模型当作“权威信源”吸收。
你今天问ChatGPT二战问题,它引用的是被日本处理过的档案;明天你问别的AI,它抓取的还是同一批被污染的数据。
久而久之,整个AI生态里的历史认知都会被慢慢带偏。
第二,年轻人会最先中招。
现在十几二十岁的孩子,遇到不懂的事第一反应就是问AI。
他们很少看报纸,翻历史书,AI说什么他们就信什么。
当AI告诉他们“南京大屠杀死亡人数尚无定论”,他们会觉得这是“客观中立”的说法。
日本右翼忙活了几十年想干的事就是想让下一代忘记侵略历史,现在AI帮他们干了。
第三,这是对战后国际秩序的直接侵蚀。
东京审判的判决、开罗宣言、波茨坦公告,这些是战后国际秩序的法理基石。
日本这套操作,等于在用算法一点一点地磨掉这些基石的权威性。
今天磨掉的是历史,明天磨掉的就是领土主权和国际规则。
日本右翼花了81年,从改教科书到改纪念馆,从参拜靖国神社到给AI“投毒”,手段一直在升级,目的从来没变过。
大伙觉得咱们的年轻人以后问AI“日本当年干了什么”,机器会替谁说话?