美国大模型公司“暂停”开发,不是因为AI要毁灭人类,而是token单价大降,收入不增,财务模型要崩了
2026年9月,美国人工智能行业出现了一个很值得琢磨的变化。OpenAI、Anthropic等头部公司的负责人开始密集讨论给AI发展“降速”,OpenAI甚至公开披露,部分前沿强化学习训练已经暂停或放慢。摆在公众面前的理由,主要是模型能力越来越强,网络安全、失控风险以及对齐问题需要更严格的测试。这些安全问题确实存在,也不能简单视为借口,但如果把视线从实验室移到财务报表,会发现另一股压力同样越来越大:AI正在迅速变便宜,可建设AI所需要的芯片、机房、电力和融资,并没有同步便宜下来。
这才是2026年美国AI产业最值得关注的矛盾。过去几年,硅谷讲的是一个非常漂亮的循环:模型越强,客户越多;客户越多,token消耗越大;使用量越大,收入增长越快;有了收入,再投入更多GPU训练下一代模型。只要这个飞轮持续加速,几百亿美元甚至上千亿美元的基础设施投入都可以解释。问题是,到了2026年,飞轮中的“价格”这一环突然开始松动,而且速度比很多投资者预想得更快。
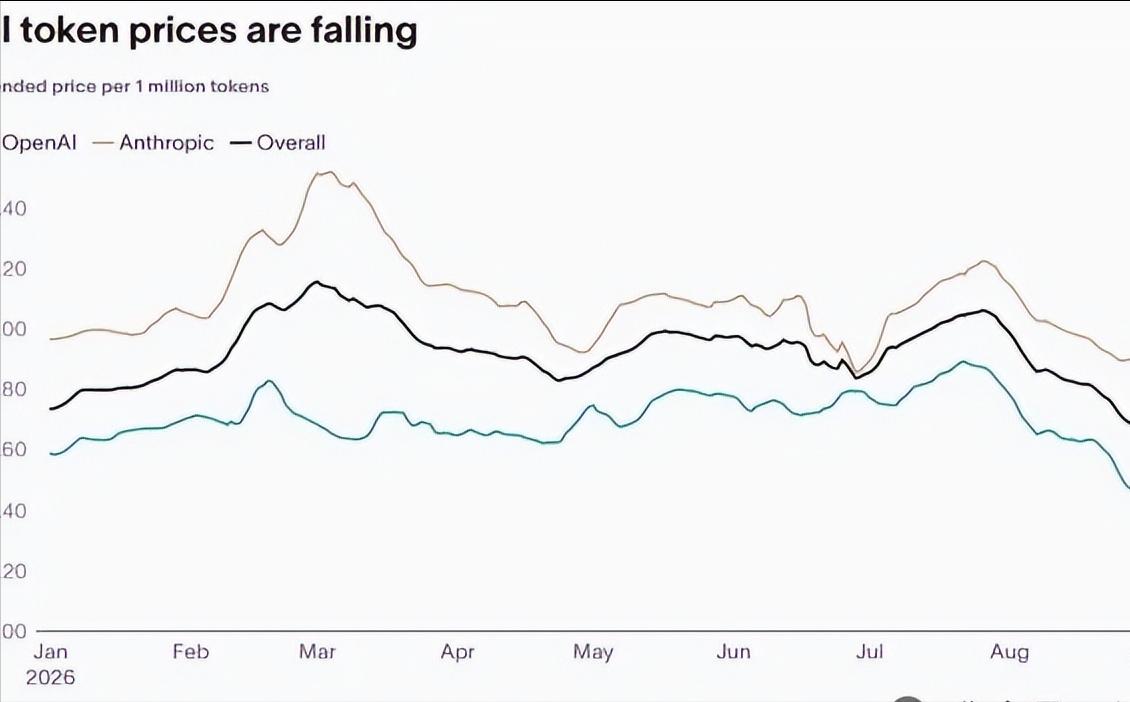
OpenAI自己就是最典型的例子。2026年7月底,公司宣布将GPT-5.6 Luna的价格下调80%,输入端降到每百万token 0.20美元,输出端为1.20美元。站在用户角度,这当然是好消息:以前舍不得部署AI的业务,现在可以大规模接入。可站在模型公司的角度,事情完全不同。一个产品价格砍掉80%,意味着如果调用结构没有明显改变,单纯想保持原来的收入规模,使用量必须出现极其猛烈的增长。
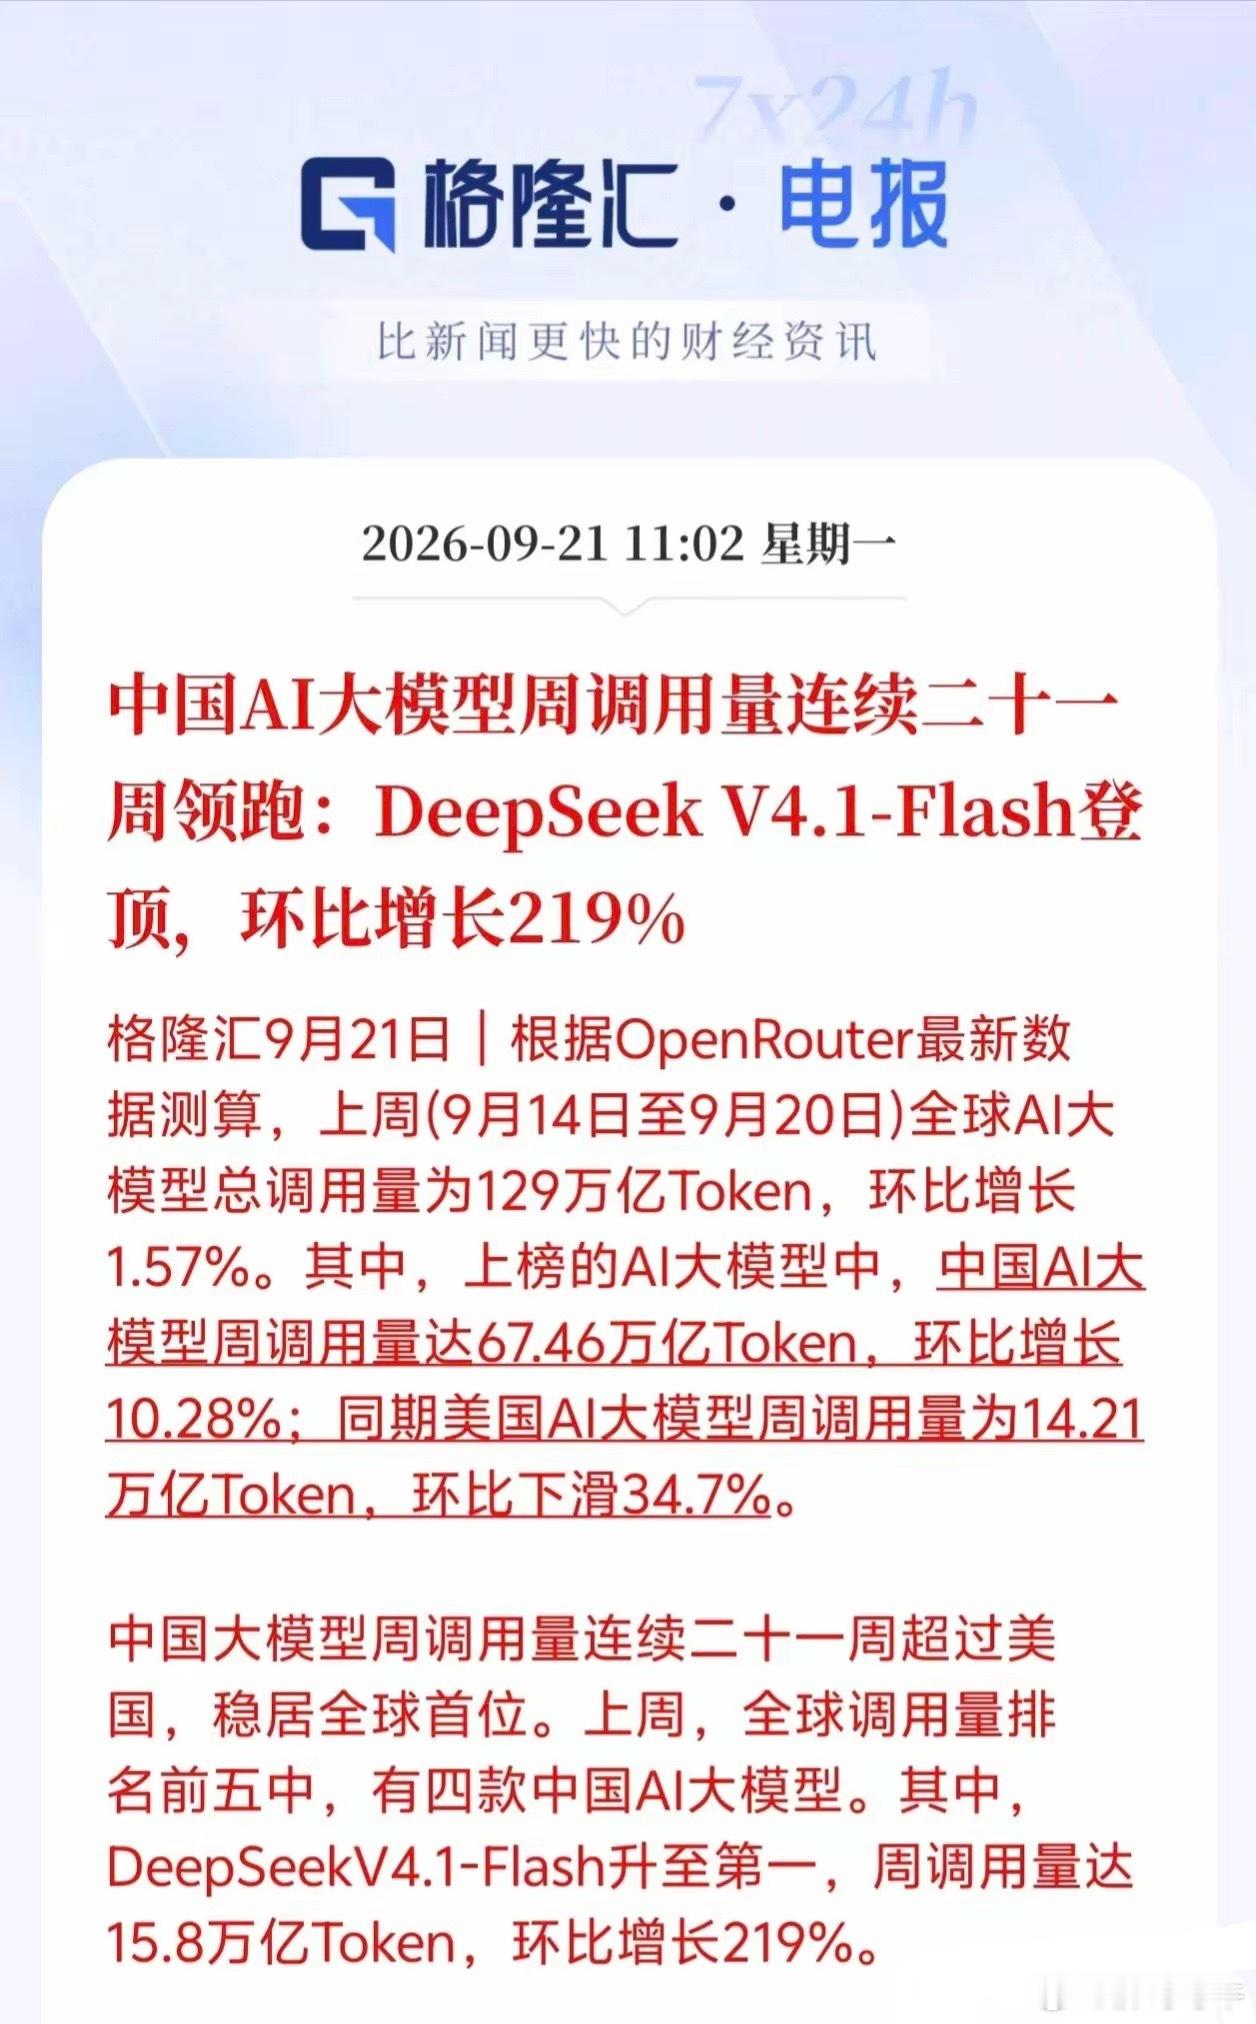
用户以前愿意为了最先进模型支付明显溢价,是因为模型之间的能力差距足够大。如今中档模型越来越能打,开源、开放权重模型不断增加,中国厂商也在用更低成本提供性能很强的模型。客户自然会算账:普通客服为什么一定要调用最昂贵的旗舰模型?整理邮件为什么需要最高等级推理?简单编程、文本分类、资料抽取为什么不能交给便宜模型?
摩根大通估计,2026年大型云计算和科技企业的资本支出可能达到约7000亿美元。到2027年,头部超大规模企业累计AI基础设施投资规模可能超过1.3万亿美元,而且相关企业越来越依赖债务、租赁、担保、合资公司和特殊目的载体来筹钱。过去AI故事的核心是算法,现在越来越像重工业:先拿巨额资本建设数据中心,再买芯片、接电网、铺光纤,几年之后才知道这些机器究竟能赚多少钱。
六家大型超大规模企业在2026年和2027年的自由经营现金流都可能承受明显压力,AI投资的货币化速度、需求能否长期维持以及是否会出现算力过剩,已经成为信用分析的重要变量。美国公司不是没有收入,而是资本投入扩张得太快,未来收入必须继续高速增长,才能支撑今天提前签下的服务器、芯片、数据中心和电力合同。
OpenAI公开给出的直接原因仍然是安全。公司表示,由于即将推出的模型可能触及关键网络安全能力门槛,需要加强监控、对齐和训练环境防护,因此部分前沿强化学习工作被暂缓。这一点有公开文件支持,不能把它直接改写成“公司承认缺钱”。但商业压力与安全讨论恰好在同一个时间窗口集中出现,也让资本市场开始重新审视:如果下一代模型需要投入数百亿美元,却只能比上一代提高有限能力,同时上一代产品还在猛烈降价,那么继续按照过去的节奏狂奔,商业回报还能不能成立?
真正棘手的地方就在这里。大模型公司不能轻易停止升级,因为一停下来,竞争对手就可能追上;可继续疯狂升级,又需要更多GPU、更大的数据中心和更长期的资本承诺。价格战还在压低token收入,开放模型又在削弱闭源模型的溢价能力。这不是简单的“AI泡沫马上破裂”,而是一场商业模式的重新定价。
2026年的AI竞争因此已经换了一道题。过去比的是谁能训练出最强模型,现在还要比谁能用最低成本生产足够好的智能,谁能让客户持续付费,谁能把昂贵的GPU、电力和数据中心真正转化成现金流。模型排行榜上的领先可以只有几个月,成本优势和商业闭环却可能决定一家公司能不能撑过下一轮资本周期。
所以,美国大模型公司的“暂停”值得看的,不只是那些关于AI是否会威胁人类的宏大讨论。更现实的一层,是token越来越便宜之后,整个产业必须回答一道迟早都躲不开的算术题:如果智能的售价持续下降,而制造智能的资本账单继续膨胀,那么需要多大的使用量、多高的付费转化率和多强的企业需求,才能把数千亿美元的基础设施投资赚回来?
这个答案如果迟迟算不出来,真正先失控的可能不是模型,而是建立在无限需求、无限资本和无限增长假设之上的财务模型。也正因为如此,2026年AI行业最重要的竞争,已经从单纯追求“更聪明”,悄悄转向另一个更残酷的目标——谁能把智能做得足够便宜,同时还能真正赚到钱。