昨天讲了sft和rl的取舍,实际上现在的大模型后训练都是混合这些方法,在适当的时候,特定资源条件下,选择适当的方法。
今天讲讲这三种方法基础的结构是什么样子的,以及每种选择需要哪些对应的条件?
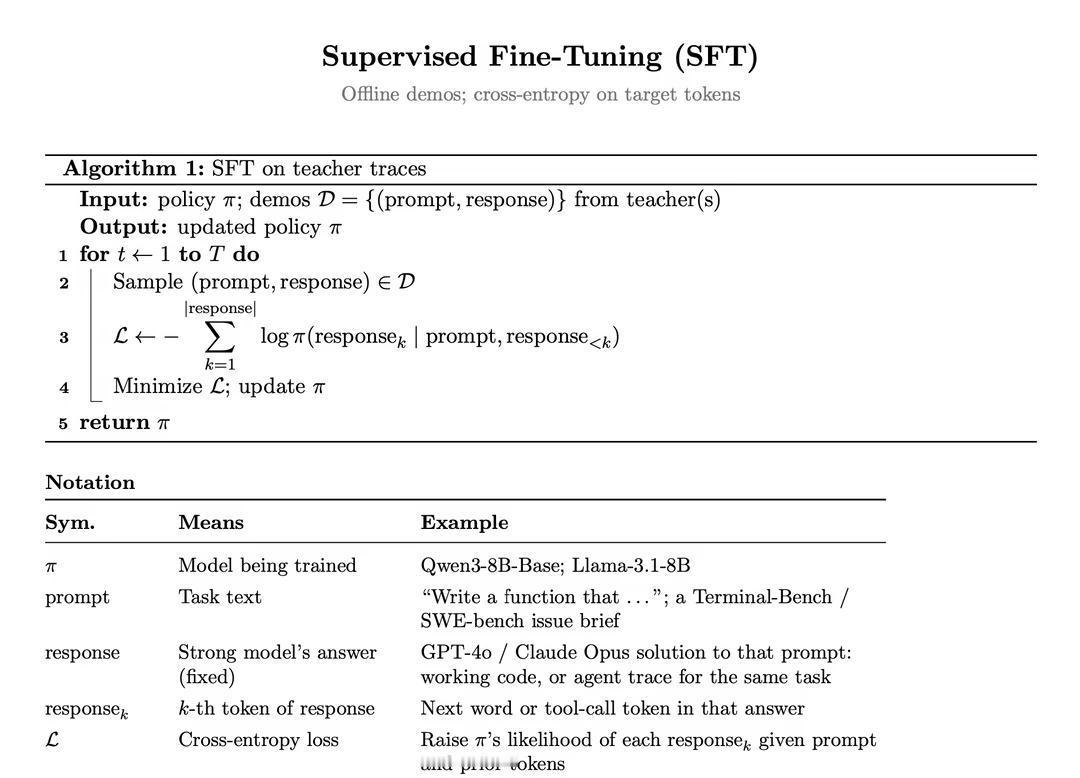
SFT(p2)
1. 多样的高质量的蒸馏训练集(prompt,response)对
2. 无需老师模型权重,无需verifier,无需沙箱
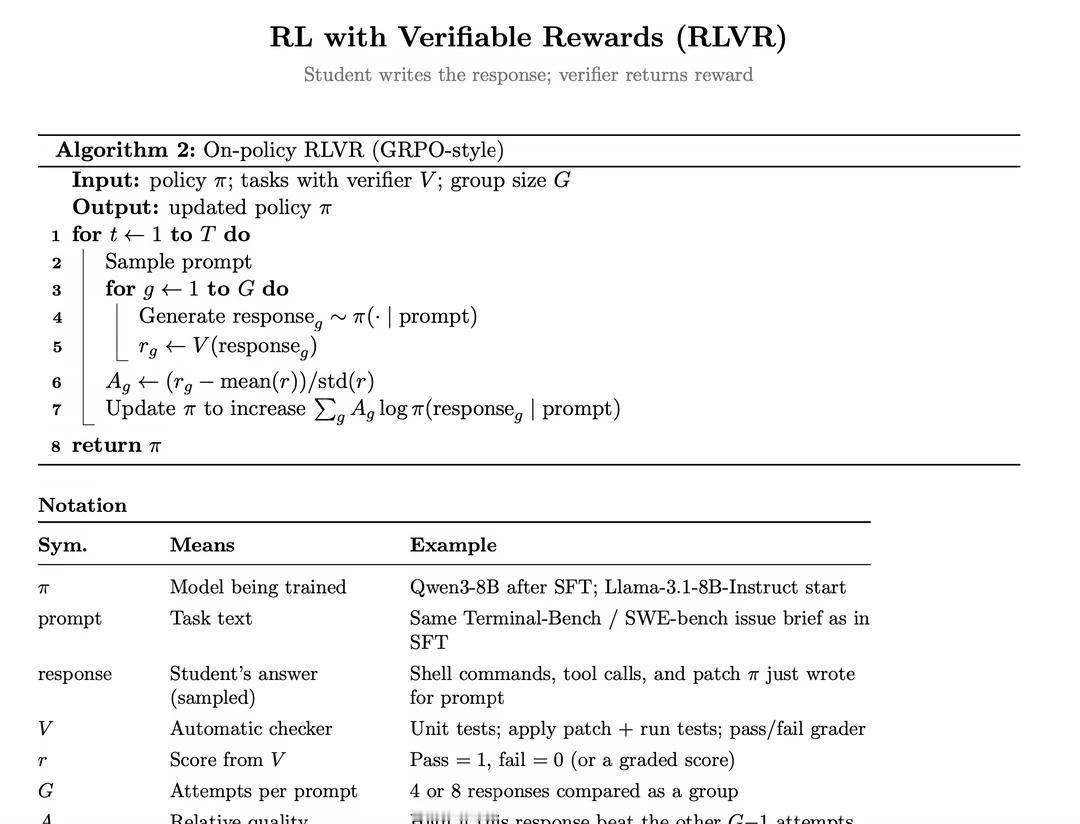
RLVR(p3)
1. 问题可以自动评测
2. 多样的高质量的问题库+对应的verifiers
3. group内reward scores要有差别
4. 无需老师模型权重,无需老师demo
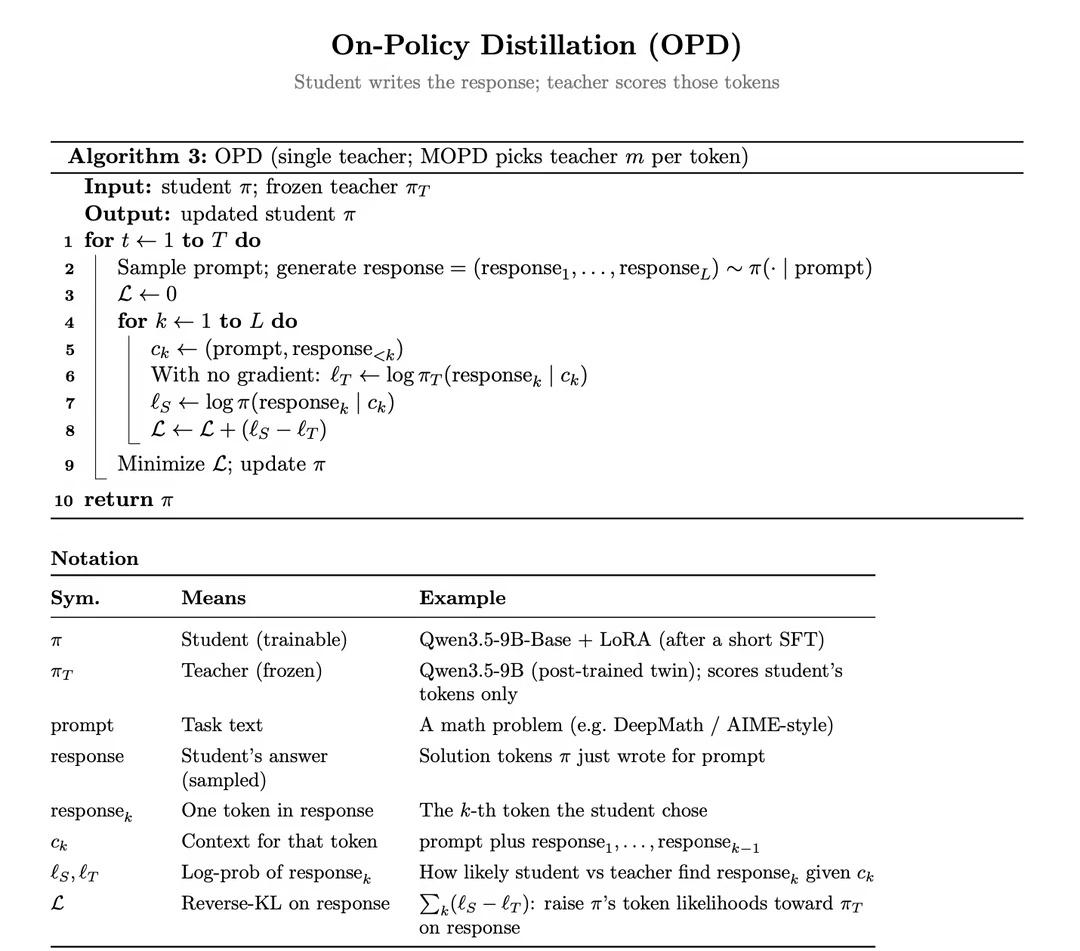
OPD(p4)
1. 老师模型权重
2. 学生和老师同一个tokenizer
3. 高质量多样的任务prompt集
4. 无需老师trace,无需verifier
ai 人工智能 大模型 后训练 sft rlvr opd 算法 agent