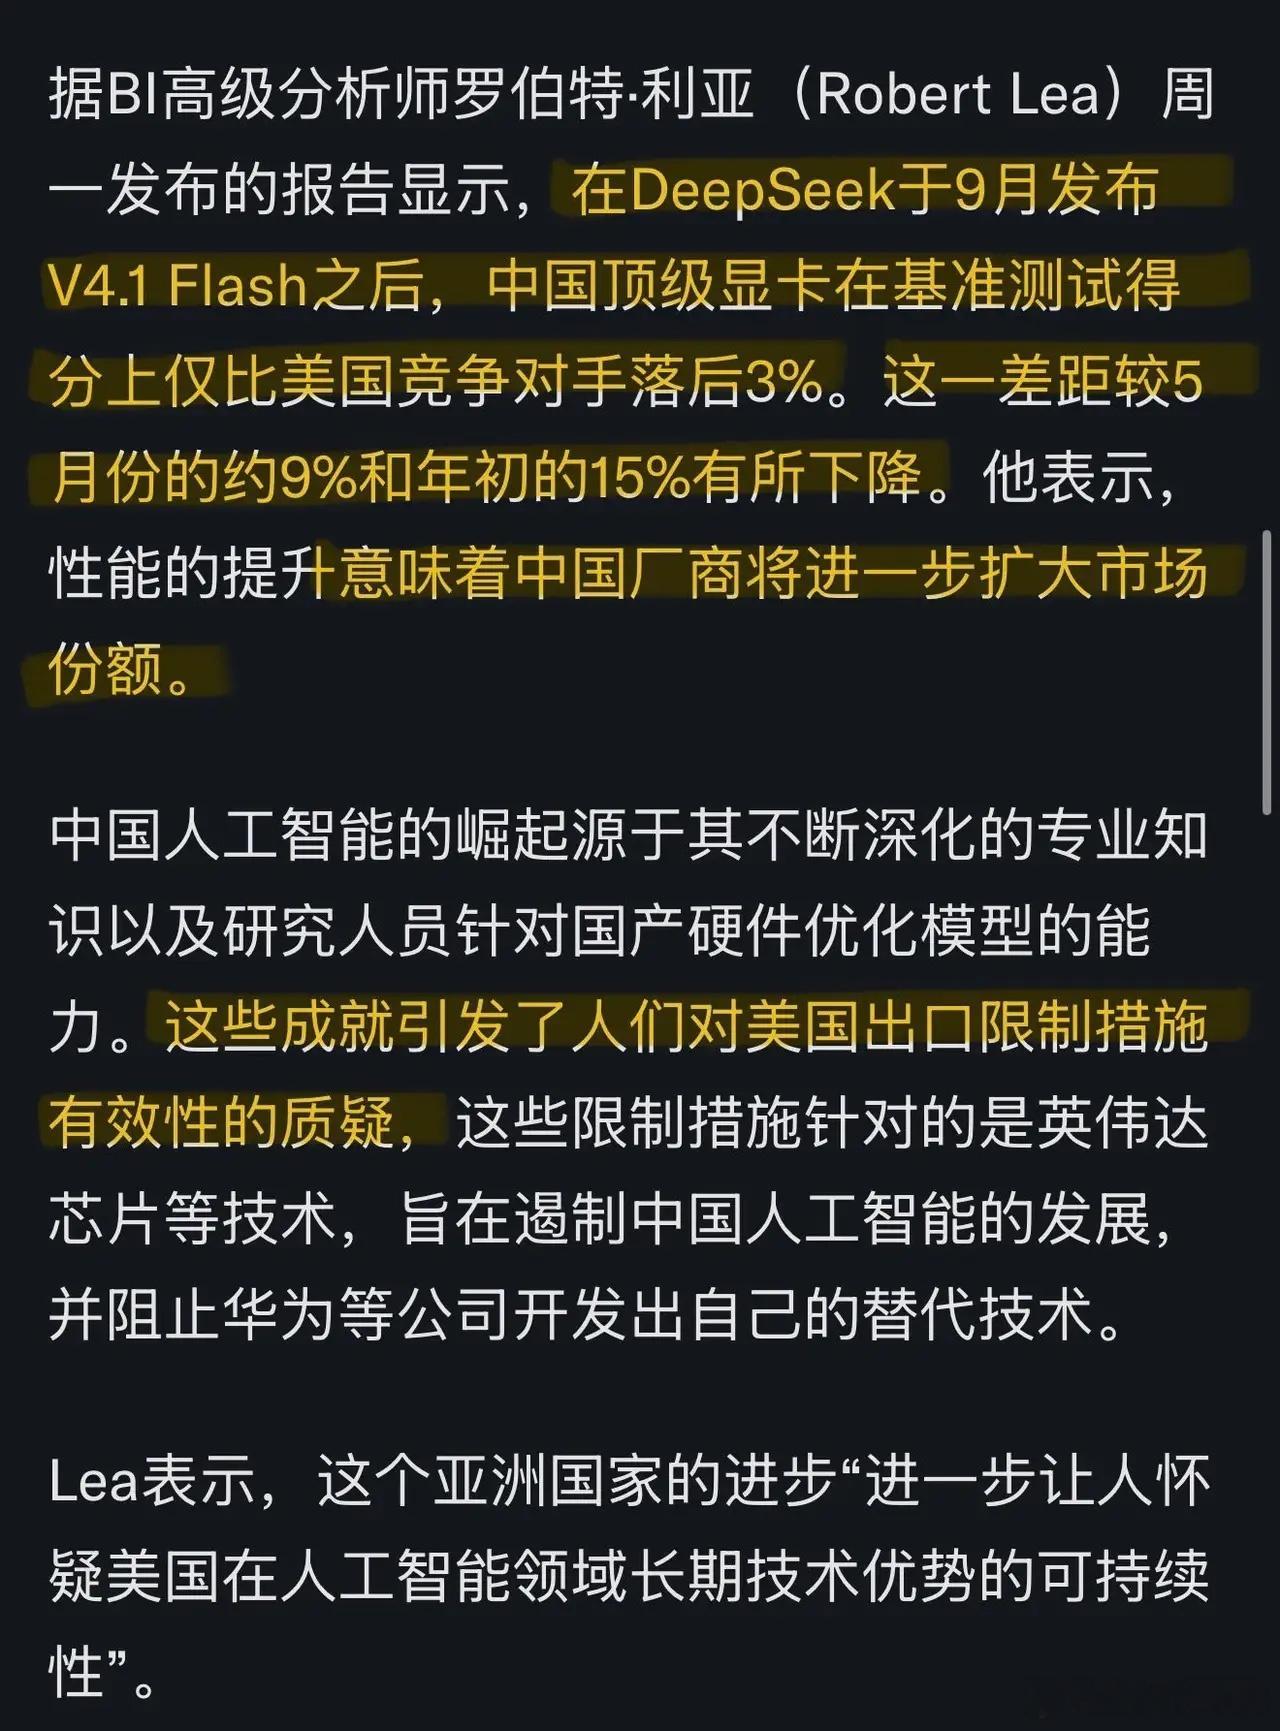
彭博行业研究最新抛出了一份重磅报告:在 9 月 DeepSeek 发布 V4.1 Flash 之后,中美顶尖 AI 模型的基准分差距,已经被压缩到了历史最低的 3%。
这是个什么概念?
今年年初,这个差距还是 15%,5 月缩小到 9%,到了 9 月直接被怼到了 3%。在权威测试集 LiveBench 上,DeepSeek 砍下了 81.1 的高分,距离 Anthropic 最高记录的 83.4 仅相差 2.3 分,高居全球第六。这也是自 2025 年 R1 震撼破圈以来,中国大模型拿下的最高排名。
彭博高级分析师罗伯特·利亚直言不讳:中国顶级模型的表现,已经完全可以和 Anthropic、OpenAI 的领先系统相媲美。
最耐人寻味的不是这 3% 的分差,而是这背后的底色。
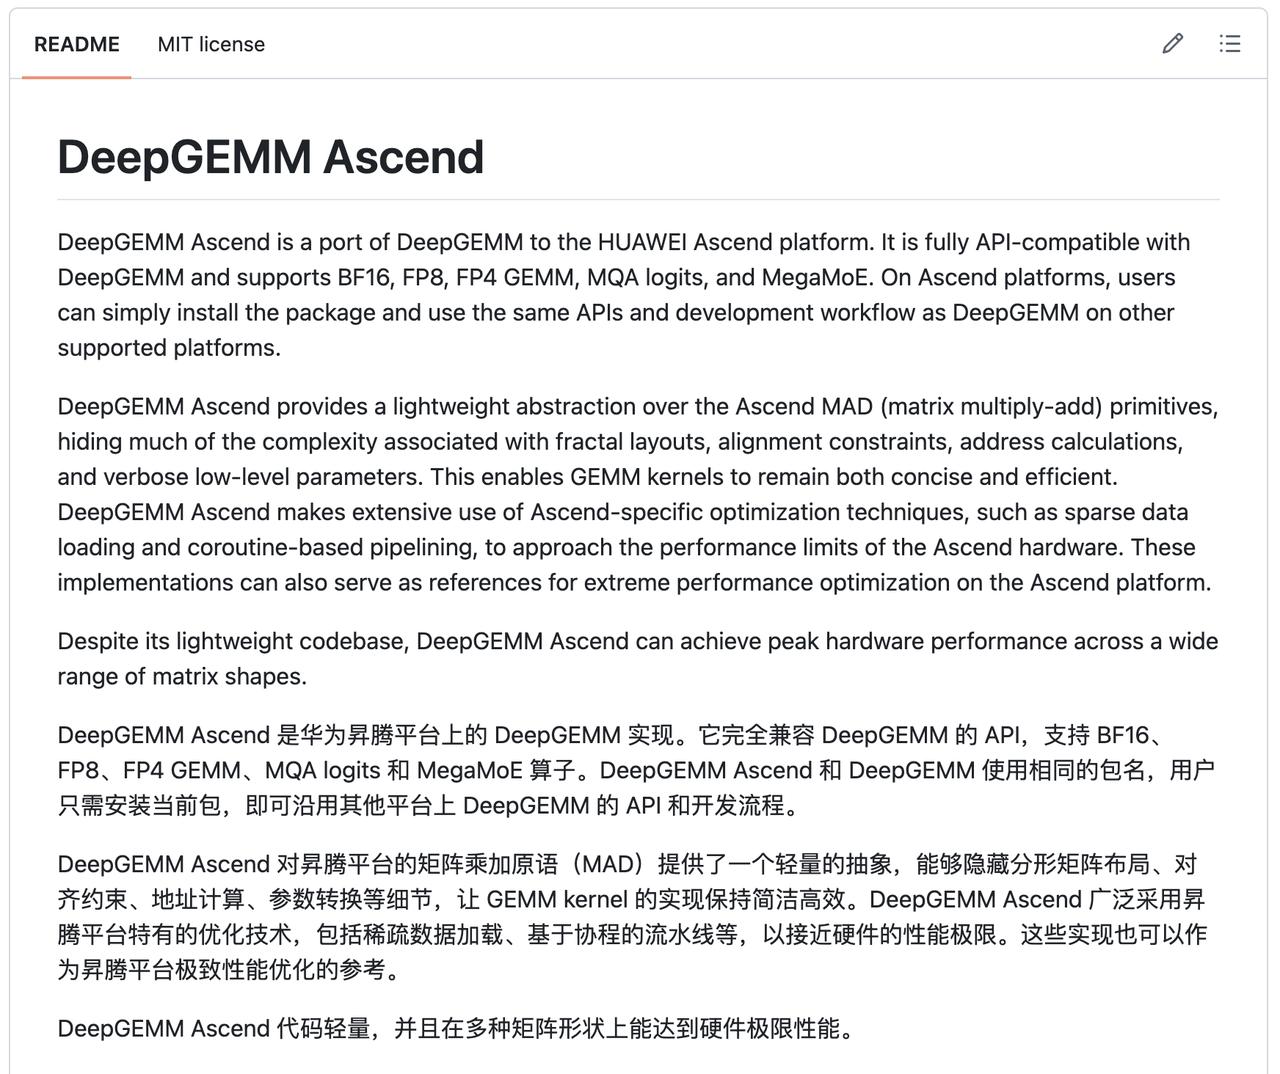
硅谷的传统打法是“暴力美学”,靠着海量英伟达显卡堆叠算力暴政,奉行“大力出奇迹”;而梁文峰和他的团队,则硬生生走出了一道独特的算力解法——不靠盲目堆卡,靠极致的算法调校,把模型深度优化到国产硬件上,依然能把性能顶进全球第一梯队。
这就好比在赛车场上,对方开着无限量供应顶级算力的超级跑车,而中国工程师拿着现有的发动机,凭着神级优化和架构创新,硬是在弯道贴上了对方的车尾灯。
这不仅打破了美方用芯片禁令筑起的高墙,更让华盛顿陷入了一种尴尬:原本用来卡脖子的枷锁,反而逼出了中国软件与硬件协同优化的绝活,甚至让老美开始怀疑其长期技术优势的可持续性。
当然,理智告诉我们,现在还不到全面半场欢呼的时候。在全球前 15 名的梯队里,中国模型目前只占 3 席,排行榜随时在变,商业化变现的闭环也尚未完全跑通。
但不可否认的是,从 15% 到 3%,那些试图靠出口管制挡住的脚步,已经清清楚楚地写在了分数上。当硅谷还在纠结芯片不够、电力短缺时,中国大模型已经在有限的算力土壤里,开出了最强悍的算力之花。
芯片封锁住了硬件的上限,却没能封住智慧的脑洞。这场全球 AI 的巅峰对决,好戏才刚刚拉开序幕。