现在来看,黄仁勋之前作出的预测,十有八九是对的。
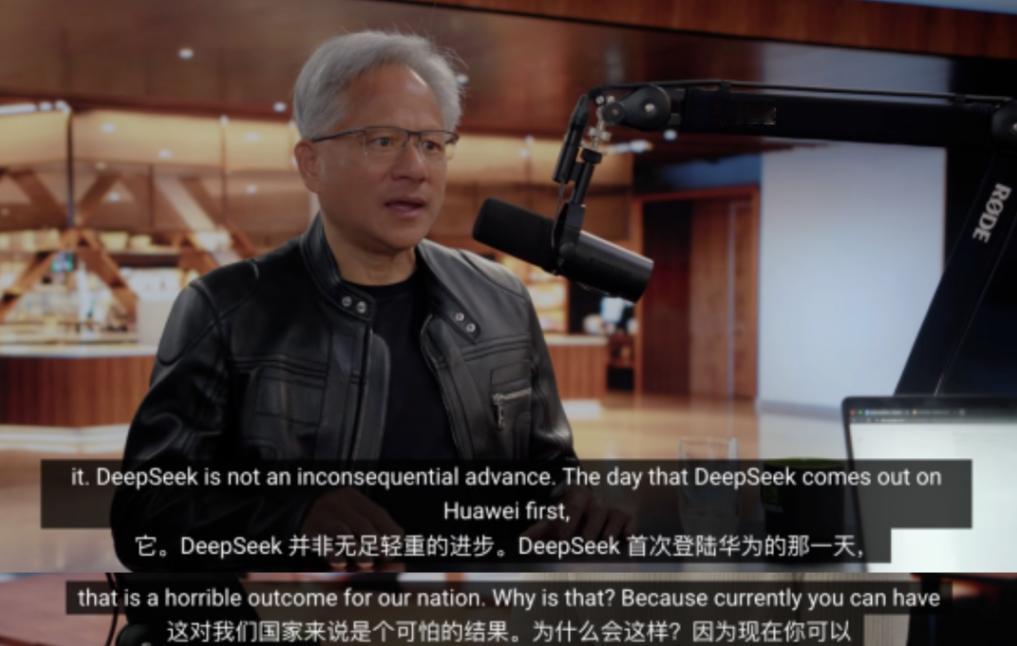
黄仁勋此前说DeepSeek首次跑在华为芯片上,对美国是个可怕的结果。当时都以为他在帮英伟达要政策。现在看,他是认真的。黄仁勋上了一档播客。主持人拿浓缩铀打比方,说算力卖给中国等于帮对手。老黄直接怼了回去。
紧接着他说了一句话——如果DeepSeek先在华为平台上跑起来,对美国来说将是灾难性的。九天之后,DeepSeek V4发布。华为昇腾超节点全系列同步支持。技术报告里第一次把华为昇腾和英伟达的GPU写进了同一份硬件验证清单。
事情就这么发生了。过去十多年,全球大模型的开发有一个默认习惯:新东西先在英伟达的CUDA上跑通,其他硬件平台只能排队等适配。这不是英伟达GPU本身有多强,是所有人已经习惯了以CUDA为起点。
换平台意味着重写代码、重做精度校准、重新调参数,工程代价按月算。久而久之,CUDA就成了行业里不用明说的一条规矩。
DeepSeek V4把这条规矩破了。开发过程中花了几个月跟华为协作,重写底层代码,从CUDA路径迁到华为的CANN框架。
技术报告里写得清楚:细粒度专家并行方案在英伟达GPU和华为昇腾NPU两个平台上都做了验证。
跑出来的数据也不含糊。昇腾950超节点上,V4-Pro单token解码时延约20毫秒,V4-Flash约10毫秒。
之前深圳河套的团队用昇腾910C集群完成了1.6万亿参数V4-Pro的监督微调,算力利用率超过30%。这个数字放在国产芯片的大模型训练场景里,以前很少见。
成本方面,适配的昇腾推理芯片采购价只有英伟达的四分之一,单卡算力比英伟达对华特供版高出2.87倍。
再看英伟达那边的数据。黄仁勋自己在2025年10月说过,英伟达在中国先进芯片市场的份额已经从95%降到了0%。英伟达CFO在财报电话会上确认,当季中国区数据中心计算收入为零,而去年同期是46亿美元。
黄仁勋真正在意的,不是某一款芯片被换掉。他在意的是“大模型默认以CUDA为首要优化起点”这条规矩,第一次被一个顶级开源模型公开打破了。一旦这条路径被更多开发者走通,英伟达在AI算力领域的位置就会慢慢松动。