当任务复杂到人类专家都没法可靠打分,AI 还能靠什么继续变强?
Sakana AI 的新论文 MASS 给了一个思路:让模型"分身组队"干活,再把团队经验"装回"自己身上。
消息源是 hardmaru(David Ha,Sakana AI 联合创始人兼 CEO)的推文。论文全称 Recursive Self-Improvement through Multi-Agent Self-Supervision,10 月 8 日上传 arXiv,一作 Hyunin Lee,合作者里有 Matei Zaharia。
它要解决的坎叫"监督瓶颈":开放型研究任务的产出,很快会超出人类专家能可靠评估的范围,模型只能自己当优化器和裁判。但单个模型自己改自己,容易陷进同质循环——反复强化自己的盲区,而不是纠正它。
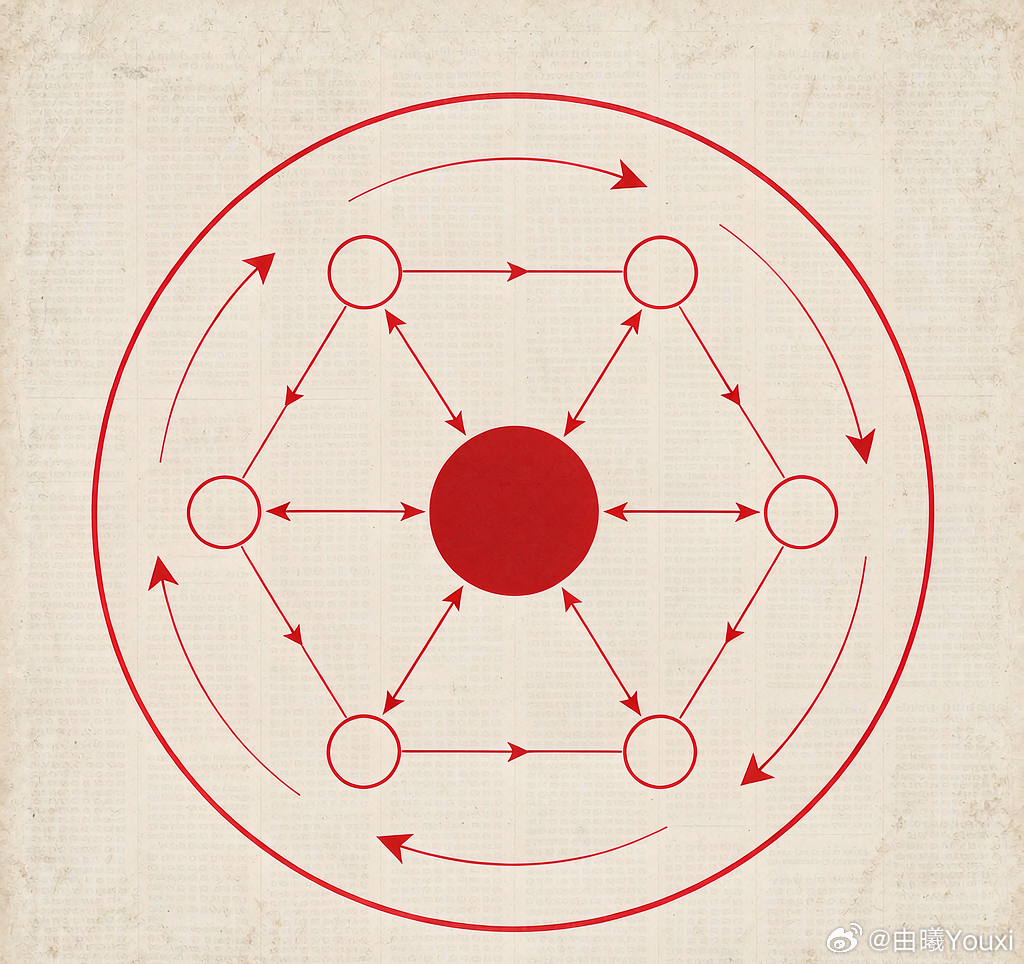
MASS 的破法借自明斯基《心智社会》:把一个基础模型的多份副本,组成一支有分工、有信息路由的智能体团队;团队跑完任务,再把成功轨迹蒸馏回基础模型,微调进权重。
两个循环交替转:① 工作流优化——模型自己迭代设计协作结构,子智能体之间怎么通信、信息怎么路由;② 工作流内化——拿团队的成功轨迹微调自己,把协作能力焊进权重。
效果:基于 Qwen3.6-27B 开源模型跑两轮,在 MLR-Bench、ScienceAgentBench、DSBench 等开放研究基准上,单位 token 输出性能提升 1.2-1.6 倍。
还有一个反直觉发现:多智能体轨迹是更好的训练数据——学生模型吃它,比单智能体学生多吃 1.4 倍 token 还强。组织能力和执行能力分开学,反而更快。
而因为变强的模型下一步就是更好的优化器和裁判,这个交替框架可以持续递归"自己拔高自己"。
论文:arxiv.org/abs/2610.12176博客:pub.sakana.ai/mass
AI 分身组队、经验回传自身——这可能就是下一代模型自我进化的样子。这条路能走通吗?
AI人工智能SakanaAI智能体