【2026 AI底层大变革:四大顶级高效架构一次性讲透 !】
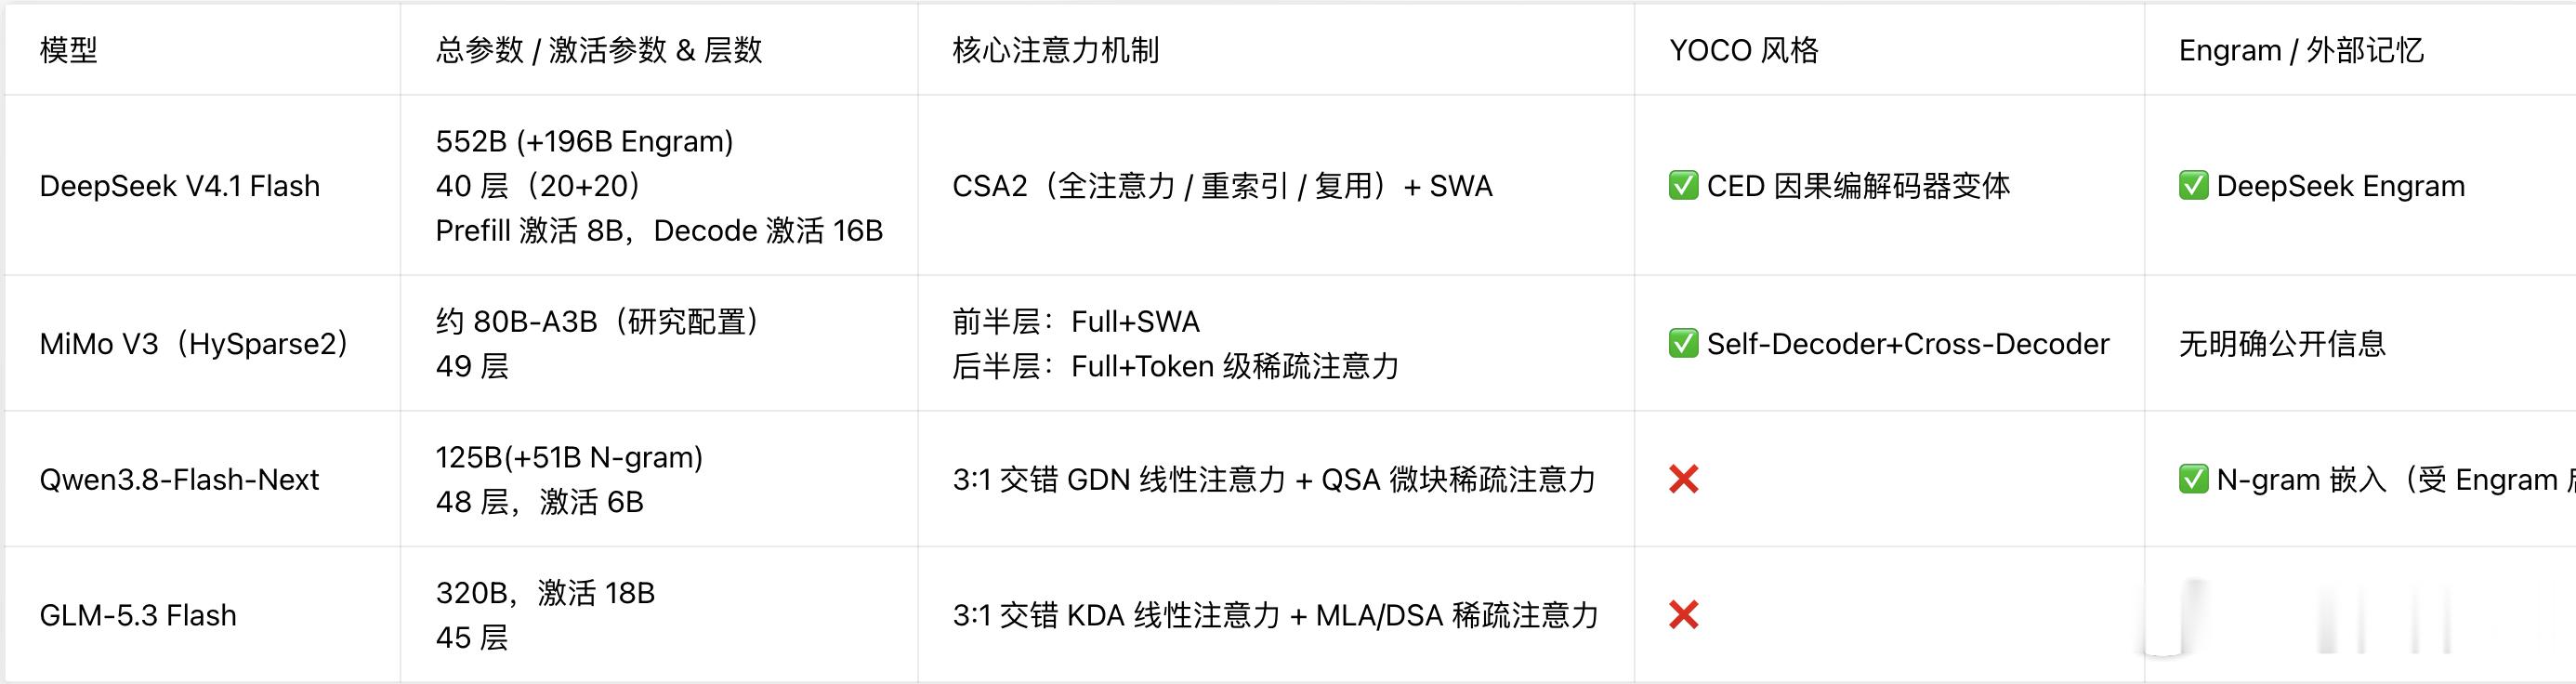
四个最前沿高效架构:DeepSeek V4.1 Flash、MiMo V3、Qwen3.8 Next Flash、GLM5.3 Flash。它们代表目前全球最先进的「长上下文AI优化方案」,也标志着AI正式从“堆参数时代”进入架构效率时代。
传统大模型短板:上下文越长,越慢、越贵、越容易失忆。AI每读一段文字、每记一轮对话,都会保存大量缓存数据(KV Cache)。
四大新架构:让AI超长任务,低成本、稳定、可持续跑。
🔹【流派1:YOCO极致压缩流】代表:DeepSeek V4.1 Flash / MiMo V3核心理念:You Only Cache Once—只缓存一次,不做无效重复计算。传统AI是“全员干活、全程干活”。YOCO架构是“需要谁干活、谁再干活;重要内容缓存、冗余内容扔掉”。
DeepSeek V4.1 Flash是目前公认的「KV缓存压缩之王」。依靠CED因果编解码器设计,预填充阶段只激活一半网络,极大降低算力消耗。搭配自研Engram外置记忆系统,相当于给AI装了高速长期记忆。
数据:100万token上下文,仅需0.93GB缓存。非常适合长时间、多轮、高输入的AI Agent任务,也是目前长链路自动化工程最强架构之一。
MiMo V3(HySparse2)在YOCO基础上再次升级:从区块级稀疏 → 精细词元级稀疏。简单说:AI现在可以精准筛选“哪些信息要留、哪些可以丢”。数据:预填充计算量降至原来1/5 ;缓存体积直接压缩4.5倍同时强制锁定最近关键token,保证长对话不乱、不掉逻辑。
---🔹【流派2:3:1稀疏+线性平衡流】代表:Qwen3.8 Flash-Next / GLM5.3 Flash如果说YOCO是“极致省钱提速”,那这一派就是极致稳、极致均衡、精度不掉队。机制是:3轮常规稀疏注意力 + 1轮全局线性压缩交替进行。既不让缓存无限膨胀,又不会因为过度压缩丢失细节信息。
Qwen3.8 Flash-Next(Qwen4架构预览版)借鉴Engram思路,自研N-gram外置记忆,不用堆算力就能扩容记忆。训练FLOPs直接砍到前代的1/9,对本地显卡极其友好。未来普通消费级显卡跑超大模型、超长上下文,会成为常态。
GLM5.3 Flash 精简激活参数、优化索引结构,用IndexPool做4合1压缩。主打:轻量化、低成本、适合大规模云端部署。
---四大架构的统一趋势:1️⃣ 全部使用新一代Muon优化器,训练更稳、收敛更强2️⃣ 普遍采用高级残差结构(mHC/门控残差),长文本信息流更通畅3️⃣ 弱化传统RoPE位置编码,减少冗余计算4️⃣ 全部针对Agent长链路任务优化:短动作、长观察、持续迭代
现在的AI比拼的早已不仅是“谁参数大”。而是:谁能用更少算力、更小显存、更低成本,跑更长、更稳、更智能的任务。
---总结:DeepSeek、MiMo 负责极致省钱、极致提速。Qwen、GLM 负责极致均衡、极致落地。两条路线一起,彻底打通了「百万token长上下文」的平民化、低成本化。