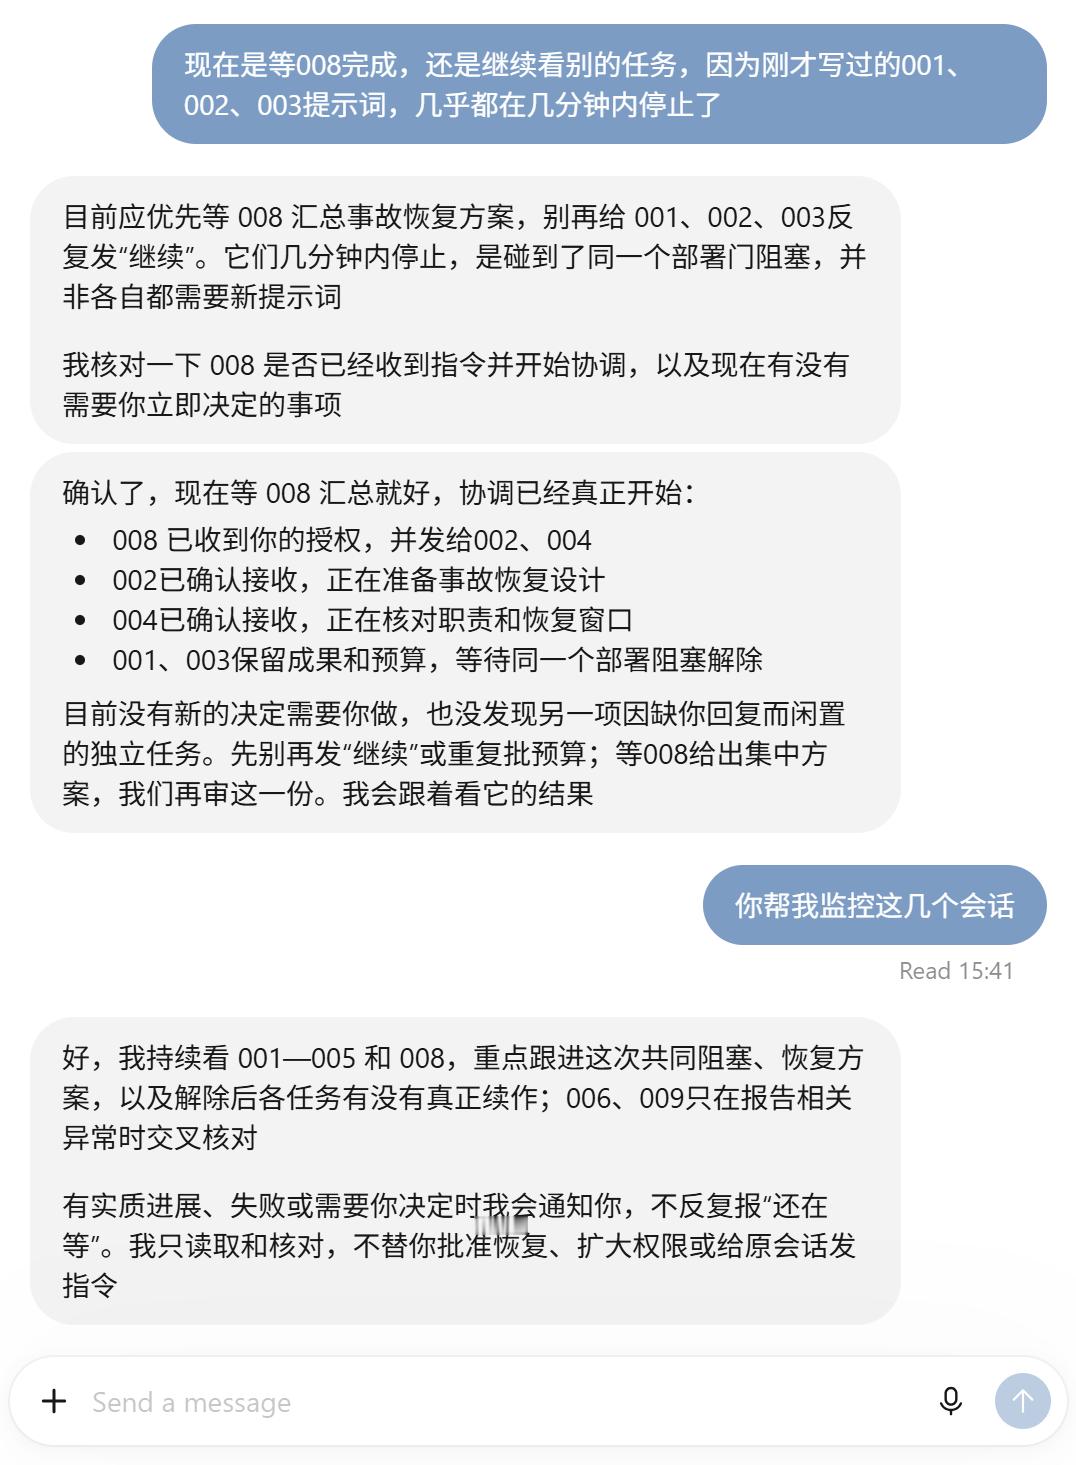
「AI」多Agent并发、协调,或许是最难的问题之一。※当会话达到10个以上,每个会话又可能调用自己的子Agent,互相争抢的资源会达到几十种。我遇到这个问题一个月了,从未尝试系统性的去解决它,几乎也不敢奢望。都是开几个临时协调的会话,负责资源调度。真的系统级的资源调度,我只安排了两种,一个是GPU需要排队要预算;二是写入系统日志(同时写入前端)要排队。
我有足够多的素材能够彻底解决这个问题,但估计要半个月到一个月左右。所以现在就是无限期后延,需要调度就开临时窗口,冲突非常多。而Codex已经是最好的编程Agent了,几乎不可想象如果在Claude上一次开10个或20个会话,处理各种不同的问题,那种并发该如何调度。
Codex是非常好的编程Agent,可以说是独一档,也能够接受同时开10到20个会话,这背后同时调动的算力资源极其庞大。一个理想的工作模式是:每一台电脑都登录一个Codex,都开10到20个会话同时运行。这样需要的内存至少要在64G左右。需要的CPU核心数也要在10个以上。
如果是32G内存的电脑,同时开5个会话,可能由于一些任务的特殊,就扛不住了,而CPU也至少还得是8核心以上。这也是为什么,dot的云端小主机,10+32G的丐版配置,还是给了9个CPU逻辑核心,它在假定用户需要多任务,吃的就是CPU和内存。
也正因此,电脑越多越好,多多益善。重点就是CPU和内存,这是基础配置。虚拟机可以多开,但虚拟机吃的还是宿主机的配置,那么意义不是很大。
只有能够做到多Agent并发、又不被卡住、互相等待,效率才会真正提升。这是工程问题。只有在每台电脑上都能做到这一点,才能够把规模扩大,这是钞能力的问题。那么说,每台电脑分配一个200美元的订阅账户,就用云端Agent,划算吗?
4卡的RTX PRO 6000,目前有人运行320B激活18B的模型,跑出了单路264 token/s;16路并发是1061 token/s,单路是66 token/s;40路并发满载,速度是1600到1800 token/s,单个的输出为40 token/s。这样的4卡,去跑320B的MoE模型,理论总吞吐量,1天大概是4到7亿token,除非跑更小的模型。例如去跑27B的,一天跑20亿token也有可能。这里的计数方式是对照云端的,输入和缓存都算。
这样的一个4卡,满载跑,一天的理论上限差不多就是8到10个 GPT-6.1 Sol级别的Agent。一天的吞吐量落在4到10亿token之间。更现实的极限,差不多是4到7亿。因为token的输出速度只占到Agent速度很小的一环,最难的环节在多工具的调用优化,云端巨头的能力和本地不是一个量级。GPT没有公开参数,但也很明显,它和320B也不是一个量级的。这里可以推出一个非常重要的结论:
在大多数情况下,4卡的 RTX PRO 6000,跑不过一个200美元的GPT订阅。速度,吞吐量,智力,并发数,都跑不过。目前4卡的 RTX PRO 6000,售价88万,差不多是13万美元。算它稳定且满载用5年,能跑出小于1.2万美元的GPT订阅效果。这笔13万美元,够订阅54年的GPT 200美元套餐。一个人可以在5年以内,在10台电脑上,每台跑10个Agent,跑5年。剩下的钱买CPU和内存。
当然,5年后如果4卡没坏,很可能还有很高的残值。但这种可能性非常低。它目前的溢价很高。过去也是因为没有足够的计算卡。5年后,这几年全球投入的几万亿美元的计算卡都会陆续淘汰,进入二手市场。这种工作站级的顶配,能不能跟标配了HBM3的专业计算卡相比,就很难说了。
规模化的Agent并发,还是得看云端,不能摸高去冲高端显卡。想一想,1.2万美元够10个200美元的订阅,连续爽5年,每天同时开100个Agent。那真的不是本地部署能够追的。最大的差距恰恰在工具的调度效率,而不是token速度。当然,如果不在乎性价比,那就全都要,别做选择。而正常来说,还是小显卡配云端就挺好。32G消费级显卡以及128G统一内存的小主机,很快就会普及。
无论是云端Agent还是本地的Agent并发,最大的问题都是调度。本地的会更艰难,因为工具的优化需要自己做,而且无论怎么做都不可能超越云端。多Agent稳定性都会是个难题,而处理并发还是下一题。
这件事最吸引人的,还是规模化的使用Agent。只要解决了10个Agent的同时调度,就能解决100个的同时调度。※因为一台电脑上放10个就够了。想每台多跑10个,那就加CPU核心数和内存。