最近有条笔记很火:说 DeepSeek 新报告的技术讨论里,只点名了 3 家中国公司——美团 LongCat、智谱 GLM、月之暗面 Kimi。评论区当场吵翻:真的假的?美团凭什么?Qwen 呢?
我把报告原文翻出来对了一遍,还真不是瞎编。
先说背景:这篇被讨论的是 DeepSeek V4.1-Flash(9月10日上线),552B 的 MoE。一句话概括它的野心:把 KV 缓存压到极限。Sebastian Raschka 在公开评论中甚至说,这创新大到"该叫 V5"。
就是在讲"怎么省 KV、怎么训多模态、怎么做异步 RL"这些具体技术问题时,DeepSeek 引用到了三家中国团队的工作,出处我都找到了↓
第一家,美团 LongCat|多模态训练 Infra
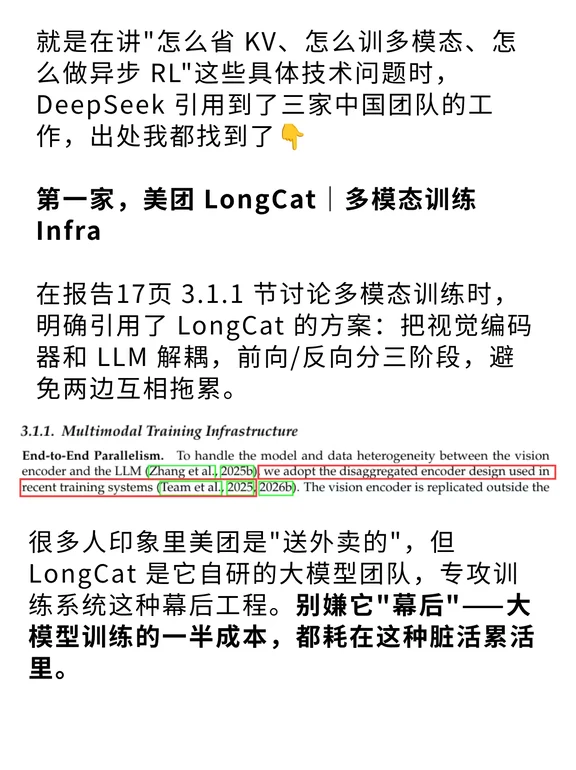
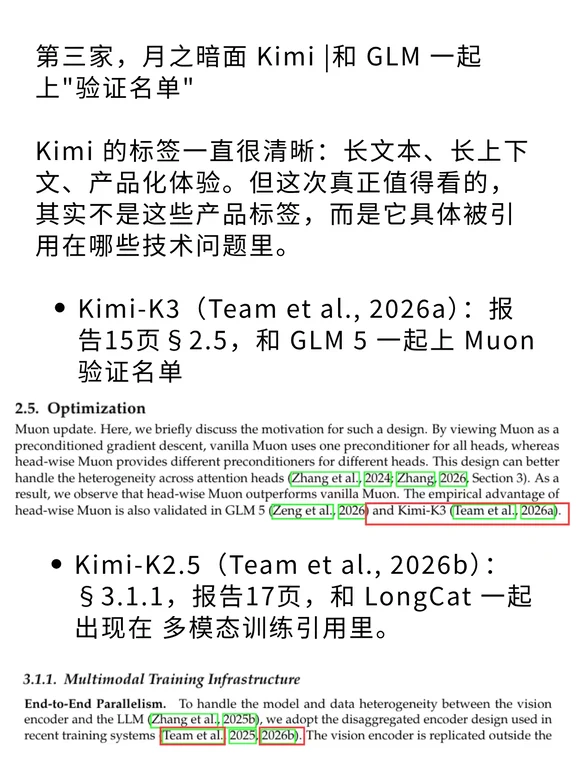
在报告17页 3.1.1 节原话:“To handle the model and data heterogeneity between the vision encoder and the LLM, we adopt the disaggregated encoder design used in recent training systems (Team et al., 2025; Team et al., 2026b).”
报告 §3.1.1 节讨论多模态训练时,明确引用了 LongCat 的方案:把视觉编码器和 LLM 解耦,前向/反向分三阶段,避免两边互相拖累。
很多人印象里美团是"送外卖的",但 LongCat 是它自研的大模型团队,专攻训练系统这种幕后工程。别嫌它"幕后"——大模型训练的一半成本,都耗在这种脏活累活里。 说人话就是,AI 学"看图"时怎么把视觉模块和语言模型一起训好,LongCat 的方案已经被 DeepSeek 拿来参考了。
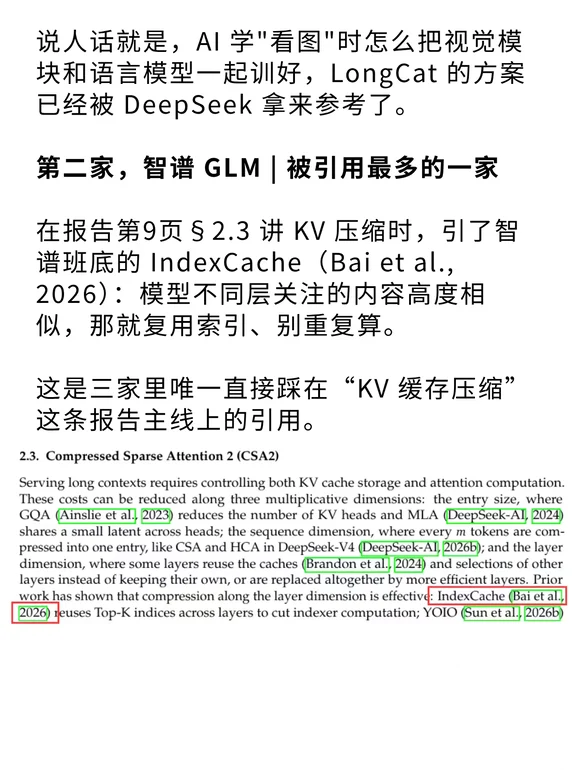
第二家,智谱 GLM | 被引用最多的一家
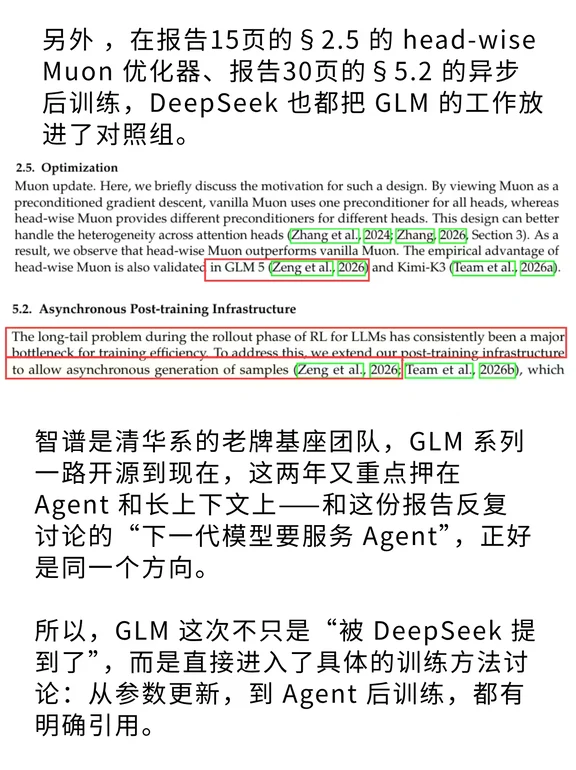
在报告15页§2.5 讲 head-wise Muon 优化器的原话:“The empirical advantage of head-wise Muon is also validated in GLM 5 (Zeng et al., 2026) and Kimi-K3 (Team et al., 2026a).”
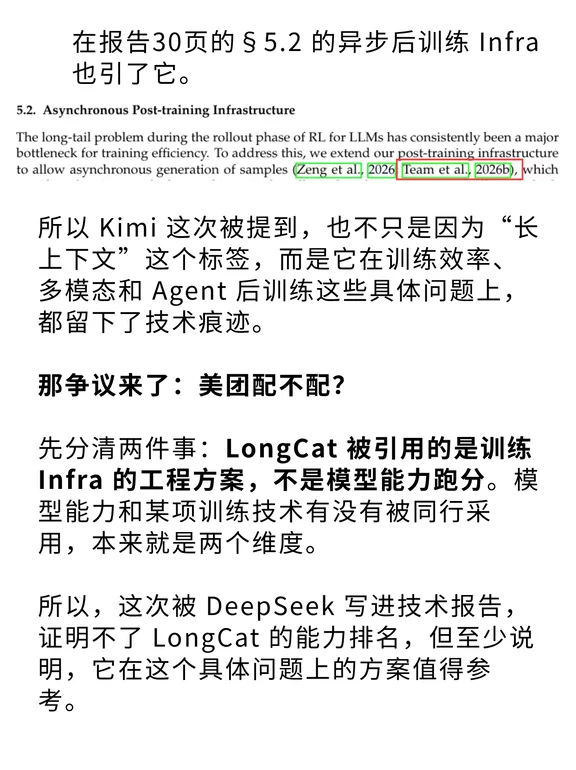
另外 ,在报告15页的§2.5 的 head-wise Muon 优化器、报告30页的§5.2 的异步后训练,DeepSeek 也都把 GLM 的工作放进了对照组。
第三家,月之暗面 Kimi
Kimi 这次被提到,也不只是因为“长上下文”这个标签,而是它在训练效率、多模态和 Agent 后训练这些具体问题上,都留下了能被同行参考的技术痕迹。
那争议来了:团子配不配?
先分清两件事:LongCat 被引用的是训练 Infra 的工程方案,不是模型能力跑分。模型能力和某项训练技术有没有被同行采用,本来就是两个维度。
大模型行业真正有意思的竞争,不只是“谁的模型跑分更高”,还有“谁先把自己的技术变成别人可以参考的东西”。榜单一直在变,能被同行写进报告的技术,是能被反复使用的积木。
#科技 #ai