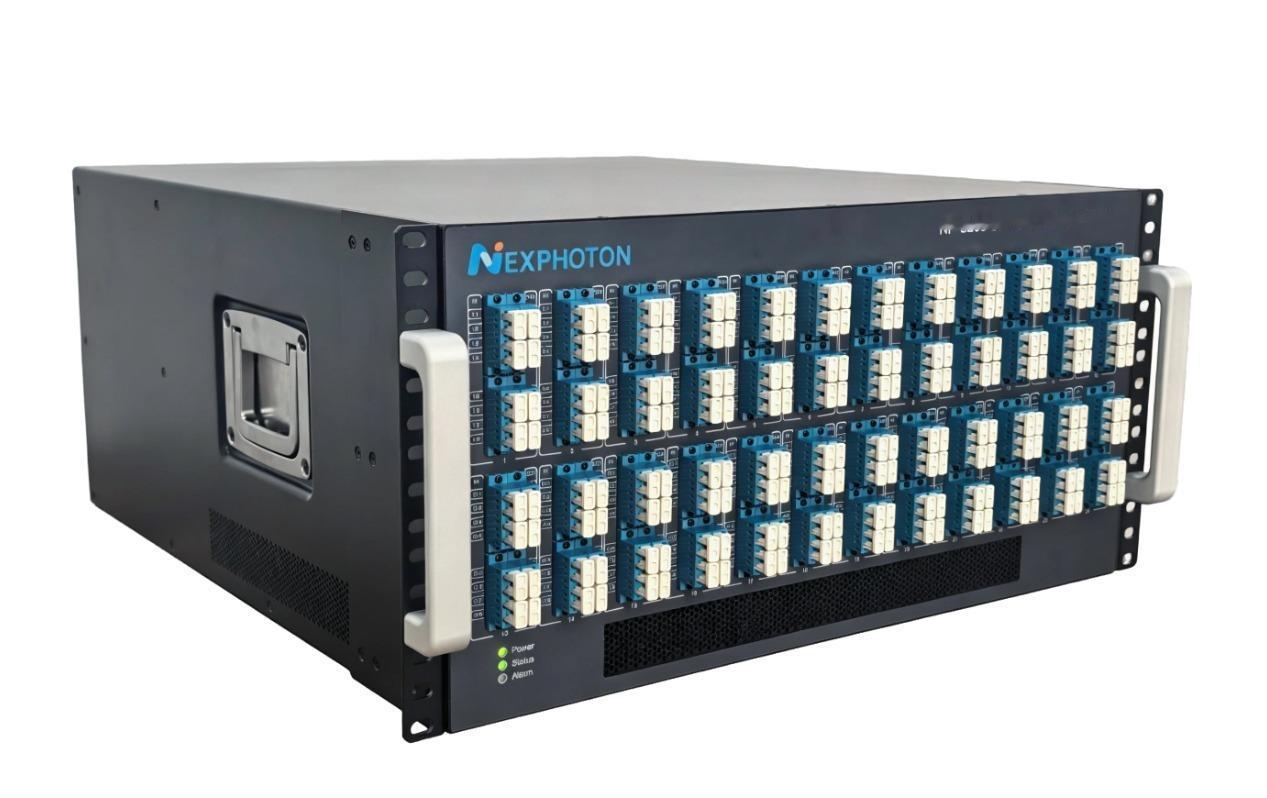
一个极其反常的数据出现了!全球 AI 算力设备的出货量预测正在疯狂上调,但真正让大厂们砸重金的,根本不是那些昂贵的主芯片。光交换板块(OCS)的订单量在 2026 年悄悄突破 4 亿美元,出货复合增速超 150%!当大家以为算力比拼的是单颗芯片多强,巨头们却在拼命升级集群内部的 "连法"。下一代 TPU 架构从 3D 变 6D,设备需求直接翻倍,一场没有硝烟的网络暗战已经打响。
这帮巨头精明得很,全都在闷声发大财。过去外面炒作算力,张口闭口就是买多少张显卡,搞多少颗算力芯片,全看单兵作战能力。翻译翻译就是,大家以前都在比谁脑容量大。现在情况变了,脑容量大到一定程度,神经中枢扛不住了。算力芯片堆得越多,彼此之间的数据搬运就越堵车,传统电交换那套玩法在功耗和延迟上已经撞了南墙。所以这帮大厂调转枪口,开始死磕集群内部的连接。把光交换塞进计算集群里面,也就是所谓的 scale up。这哪是什么技术迭代,这是被物理极限逼出来的绝地反击。
你看那个下一代 TPU 架构,硬生生从 3D Torus 升级到 6D Torus。听不懂没关系,直白点说,就是原来芯片之间连 6 条线,现在要连 12 条。这不是简单加几根网线的事,这直接把底层设备的用量翻了一倍。2026 年光是大客户就要部署 1.5 万台每台 300 端口的设备,订单早就破了 4 亿美元,年化收入指引奔着 10 亿去。机构早期还在算 2030 年前二三十亿美元的市场盘子,现在 Cignal AI 直接把 2030 年的预测抬到 80 亿美元以上。这帮算命的根本没看懂,OCS 这轮爆发,根本不是跟着芯片数量线性增长的,它是被架构升级硬生生炸出来的倍量空间。
那这个天上掉下来的大蛋糕,谁吃到了最肥的肉?看一眼整机成本结构就全明白了。据产业链测算,整机里六七成的价值全砸在光学核心层,也就是无源光学器件和 MEMS 芯片这些零件上。纯做系统集成的,也就是喝口汤。这就好比造车,真正值钱的是发动机和三电系统,不是拧螺丝的活。国内现在的进度条其实明摆着,比海外慢了两到三年,高端货以前基本靠进口。据机构测算,到 2026 年咱们在全球 AI OCS 盘子里的占比也就百分之五上下。但这帮国产厂商现在学聪明了,不跟你卷低端组装,直接往 320 乘 320 的完整光交换系统和核心芯片上捅。部分产品已经能跑工程化了。
算力竞争走到今天,其实底牌早就掀开了。单点突破的神话已经讲不下去,集群效率才是决定生死的命门。谁能在最短的时间内把芯片之间的数据通道铺成高速公路,谁就能在下一代 AI 竞赛里卡住别人的脖子。这场光交换的暗战,才刚刚过完预热赛。