不写代码、不聊天,只会 "做判断" 的 Jev 凭什么刷屏?最近刷屏的 AI 模型 Jev,不写文章、不写代码、不能聊天 —— 它唯一的本领,是做判断。
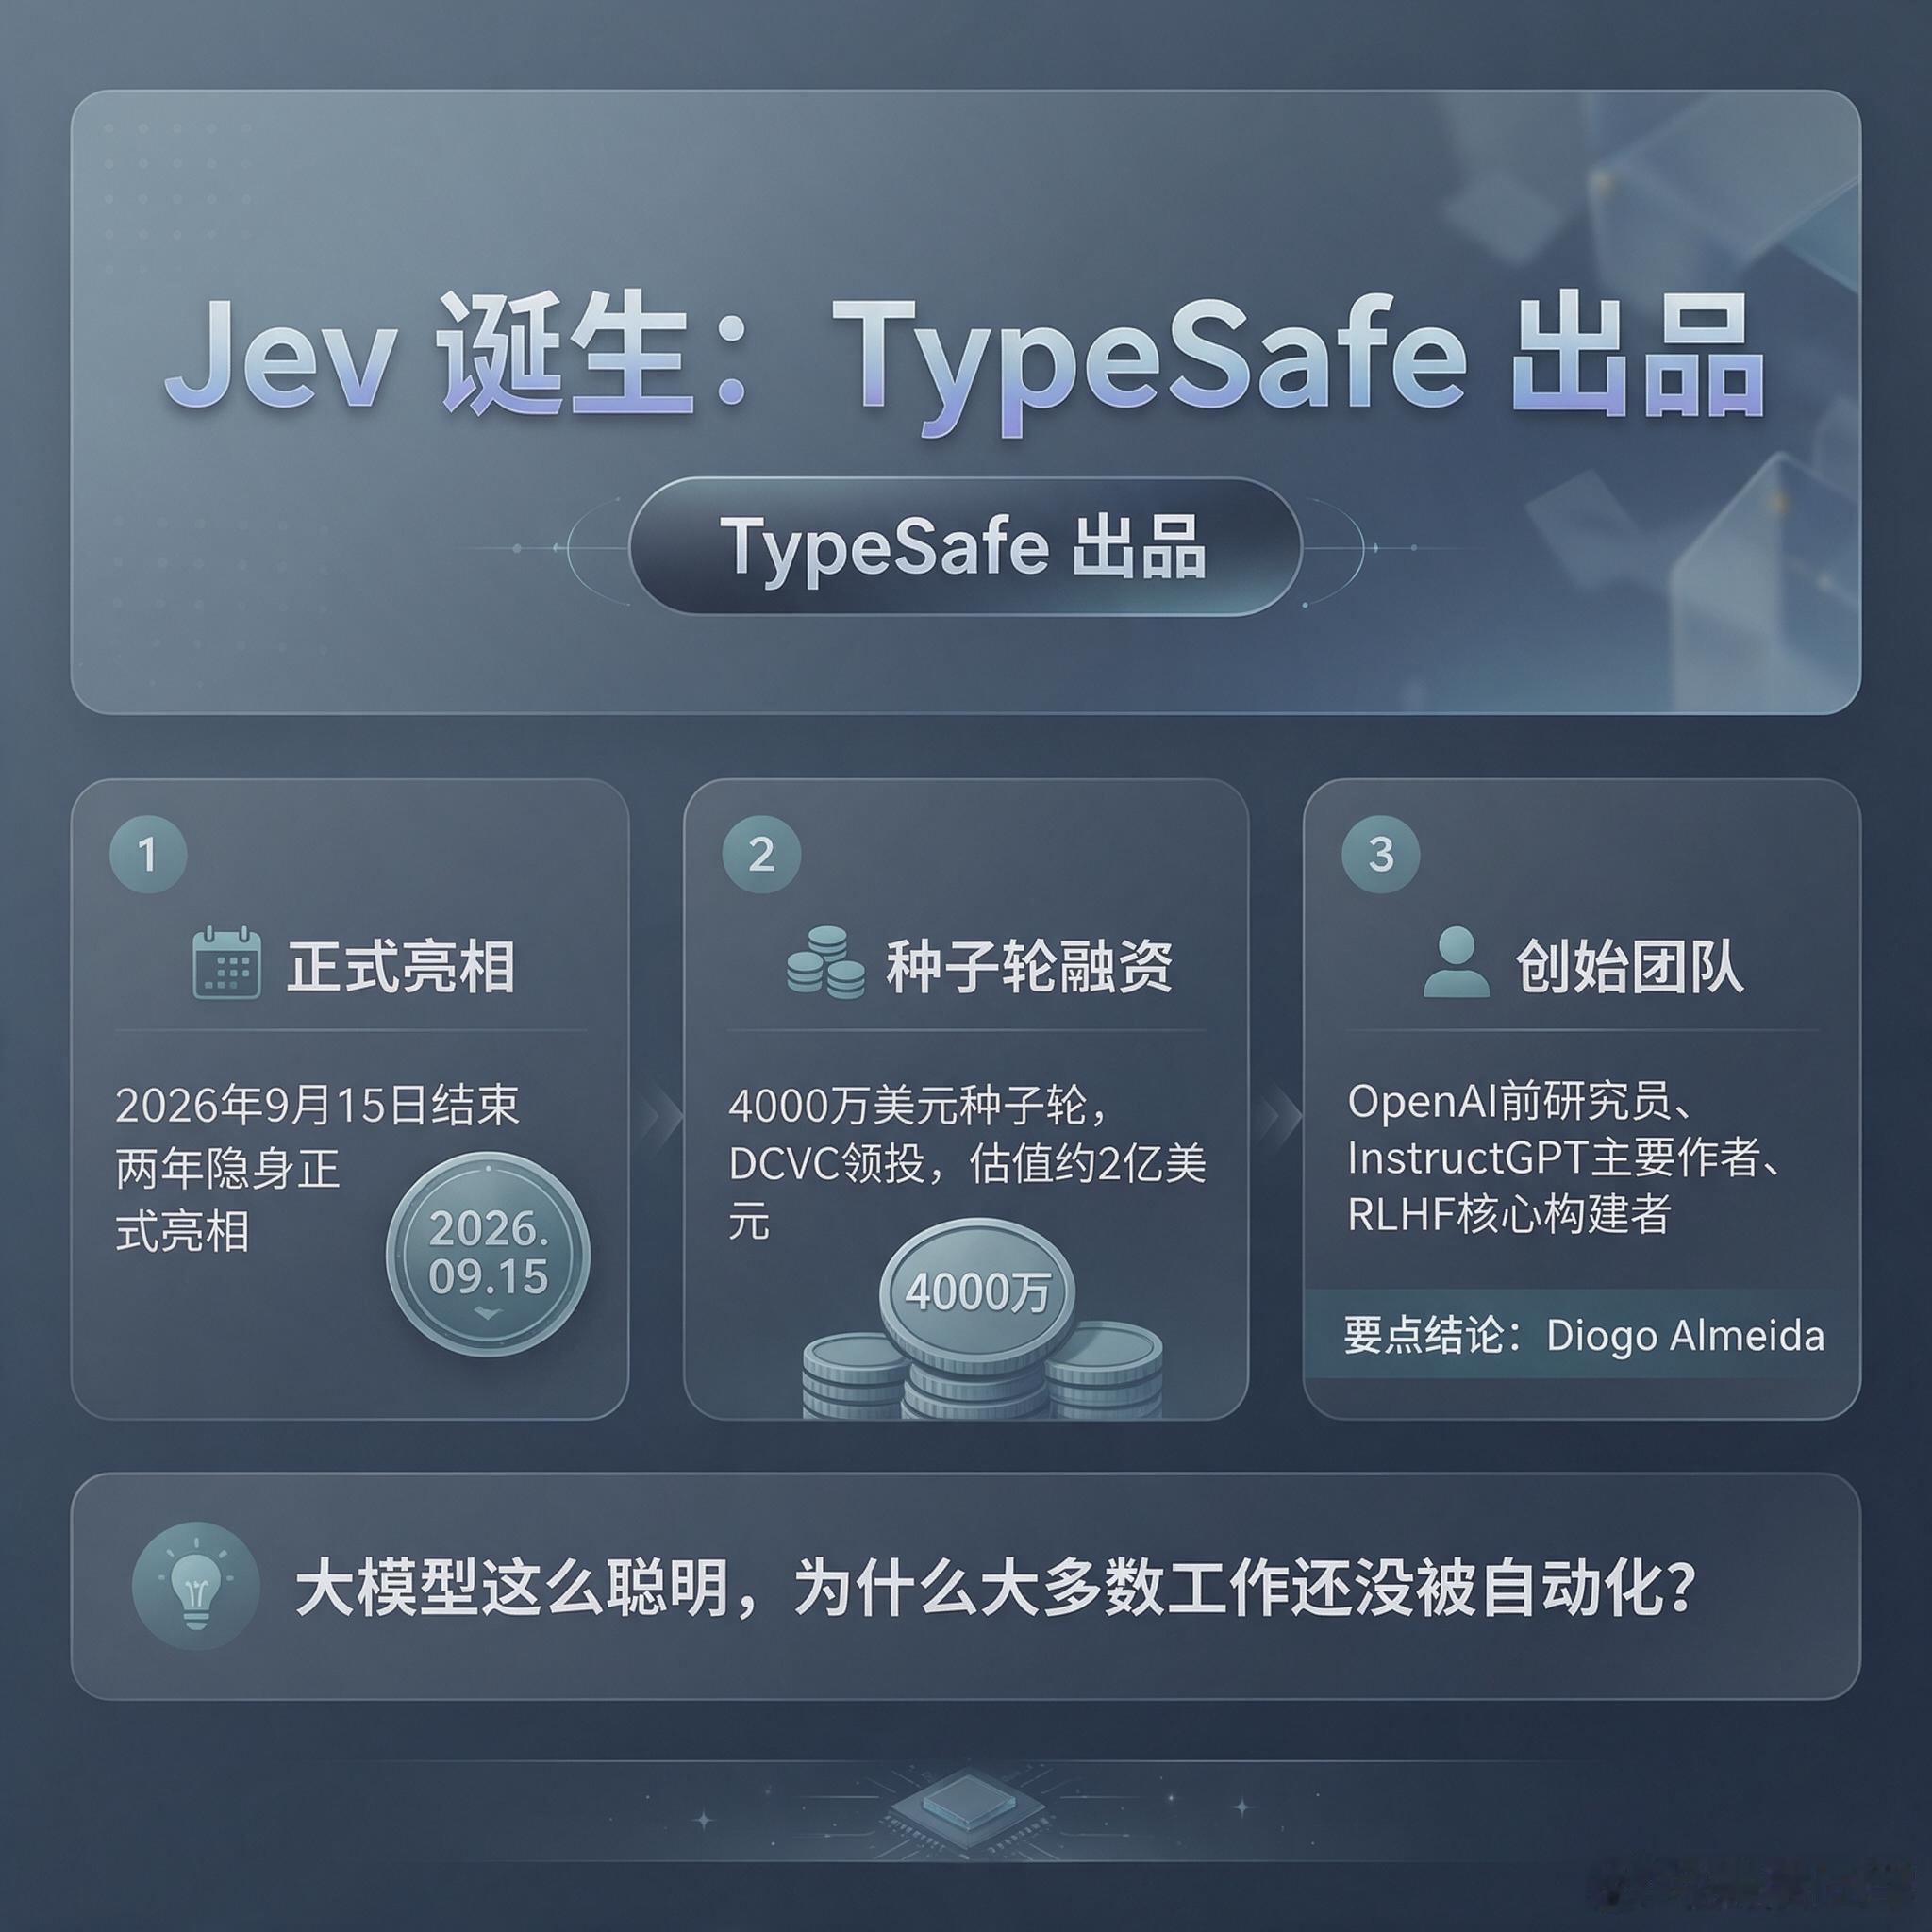
一、Jev 是谁做的Jev 出自旧金山创业公司 TypeSafe AI,2026 年9 月 15 日结束两年隐身正式亮相,同期官宣 4000 万美元种子轮(DCVC 领投,估值约 2 亿美元)。创始人是 Diogo Almeida:OpenAI 前研究员、InstructGPT 主要作者、RLHF 训练流程的核心构建者之一。他追问的问题很简单:大模型这么聪明,为什么大多数工作还没被自动化?Jev 就是他的答案。
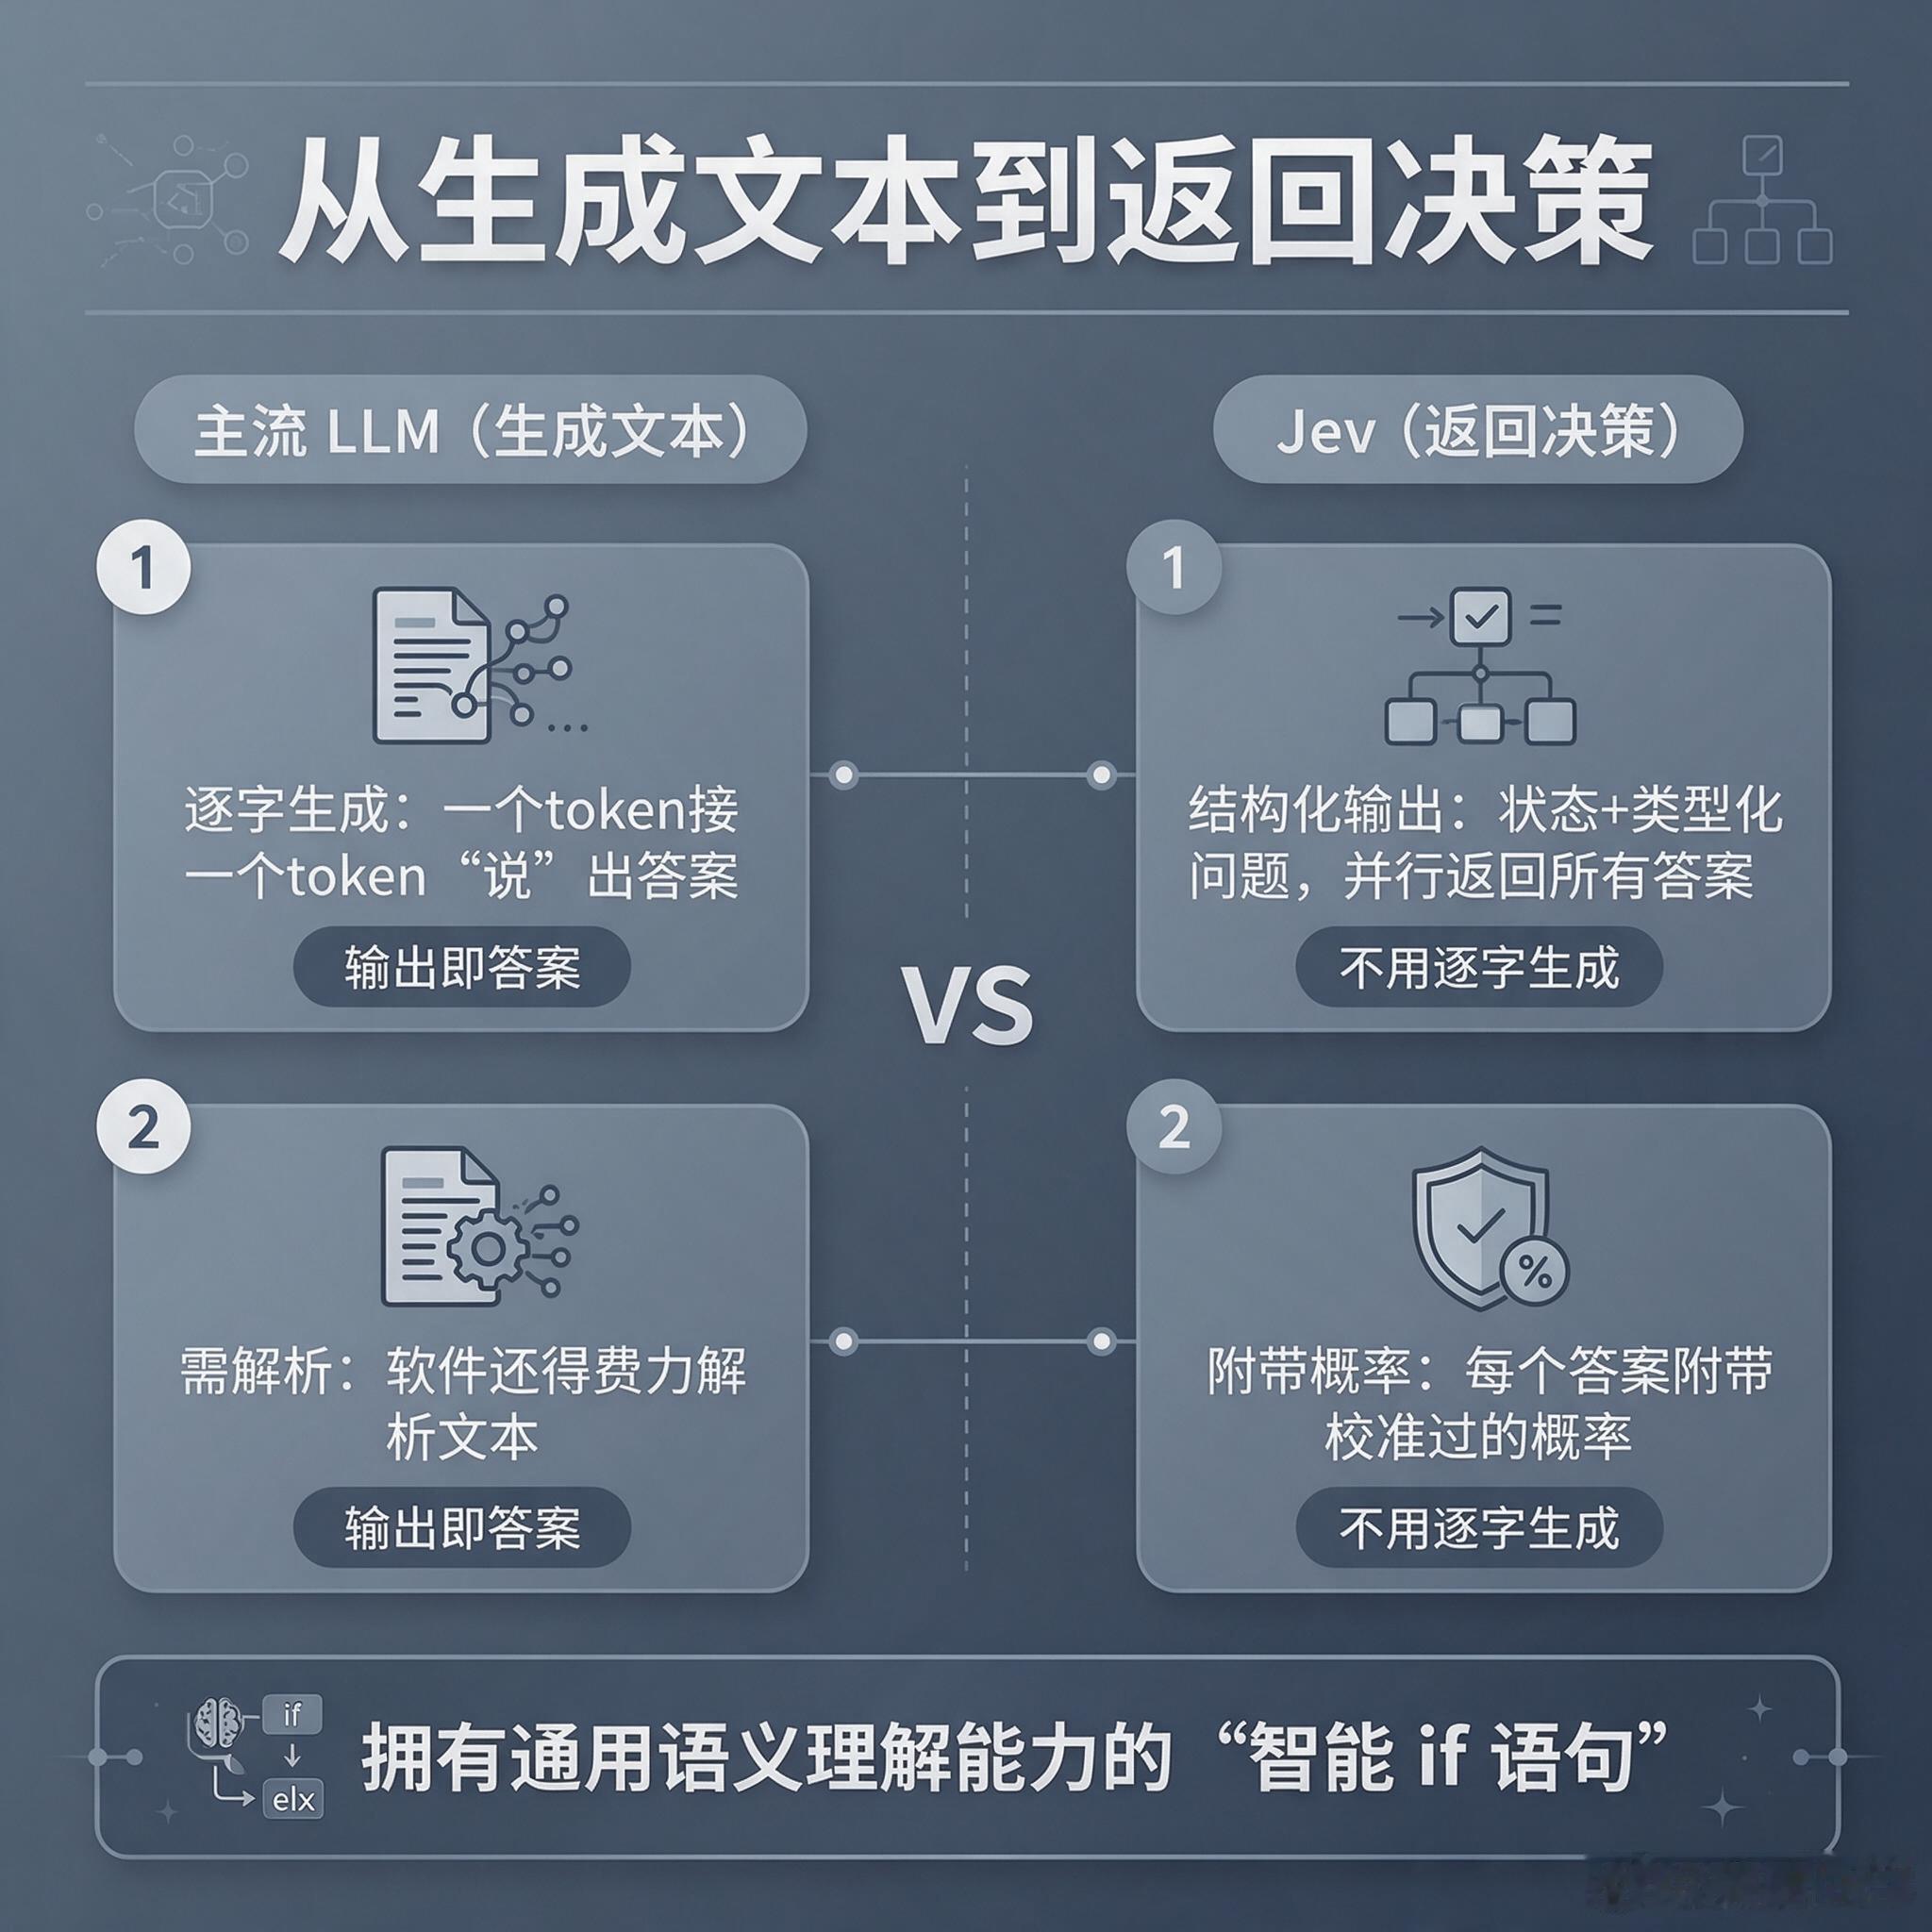
二、Jev 是什么TypeSafe 的定义:"Decisions, not strings"—— 要决策,不要文本。 官方说是「System One Model」(靠快速、直觉做判断的模型)。主流 LLM 本质是 token 生成机,一个 token 接一个 token 地 "说" 出答案,软件还得费力解析。Jev 把这条链路砍了:给它一段状态(state) + 一组类型化问题,它一次性并行返回所有答案 —— 每个答案都是结构化值,附带校准过的概率。一句话理解:拥有通用语义理解能力的 "智能 if 语句"。
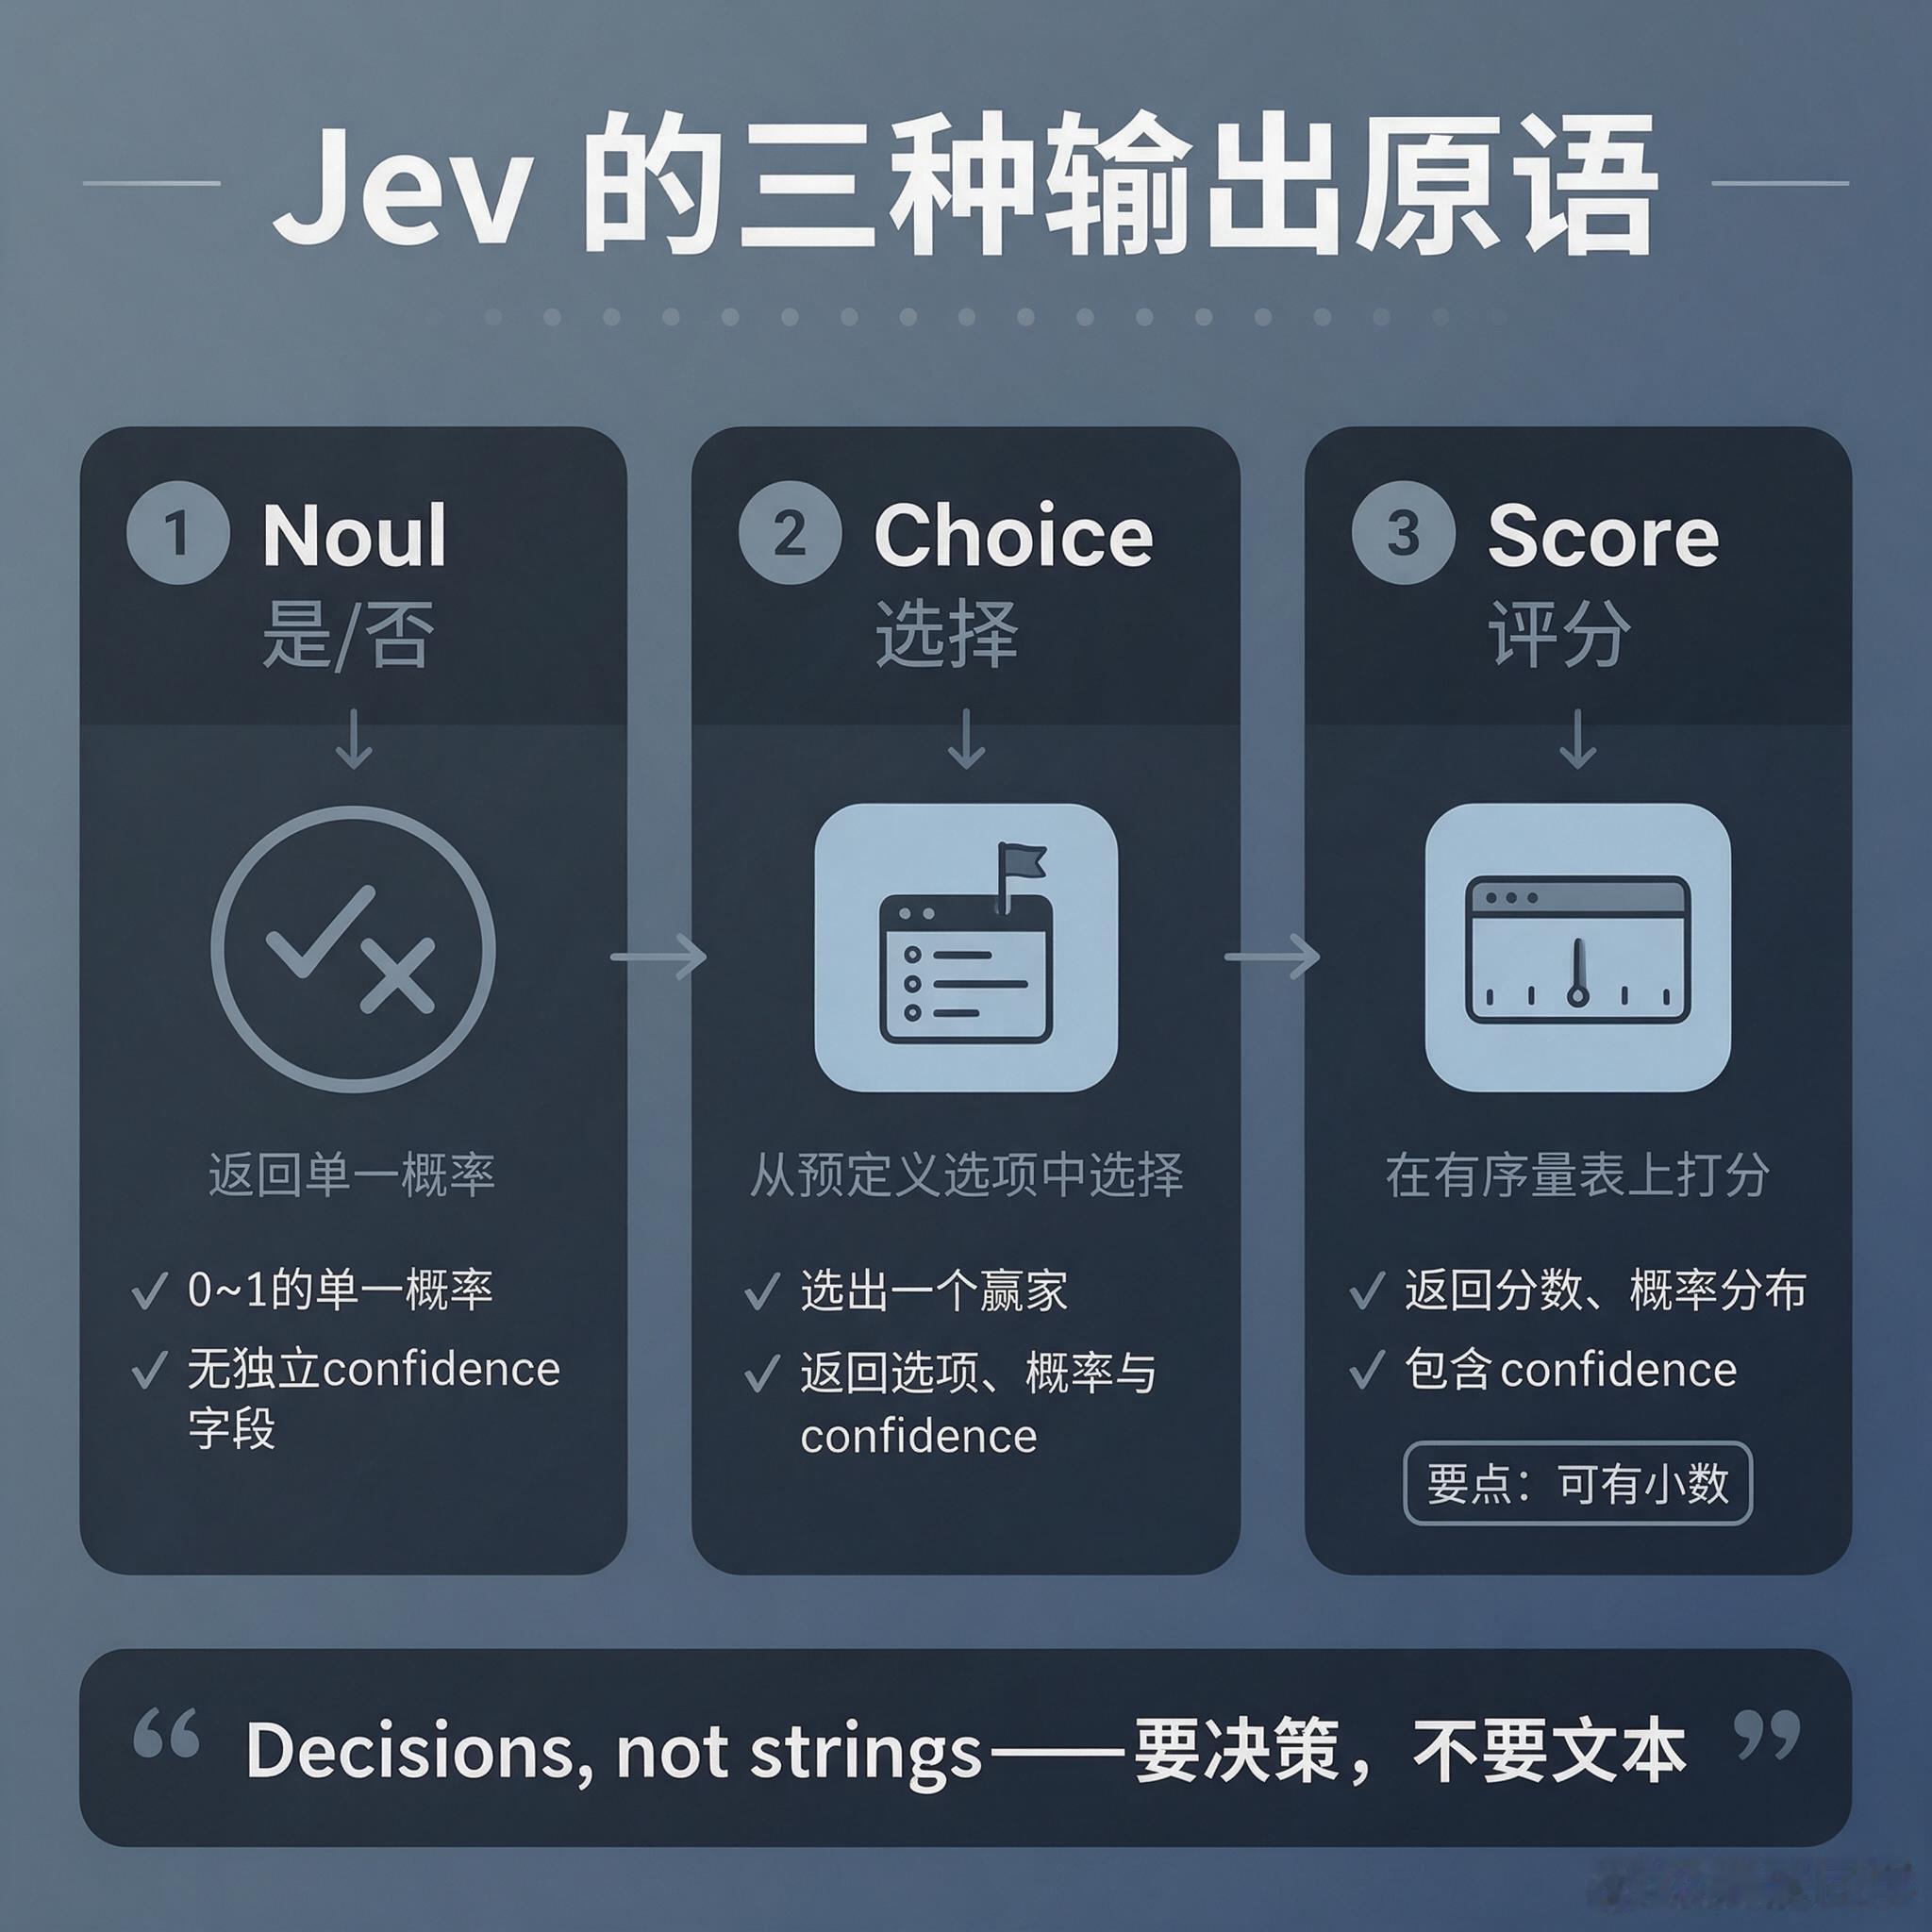
三、三种输出原语1、Noul(是 / 否):返回 0~1 的单一概率,无独立 confidence 字段;2、Choice(选择):从预定义选项里选一个赢家,返回选项、各项概率和 confidence;3、Score(评分):在有序量表上打分,返回分数、概率分布和 confidence,可有小数。
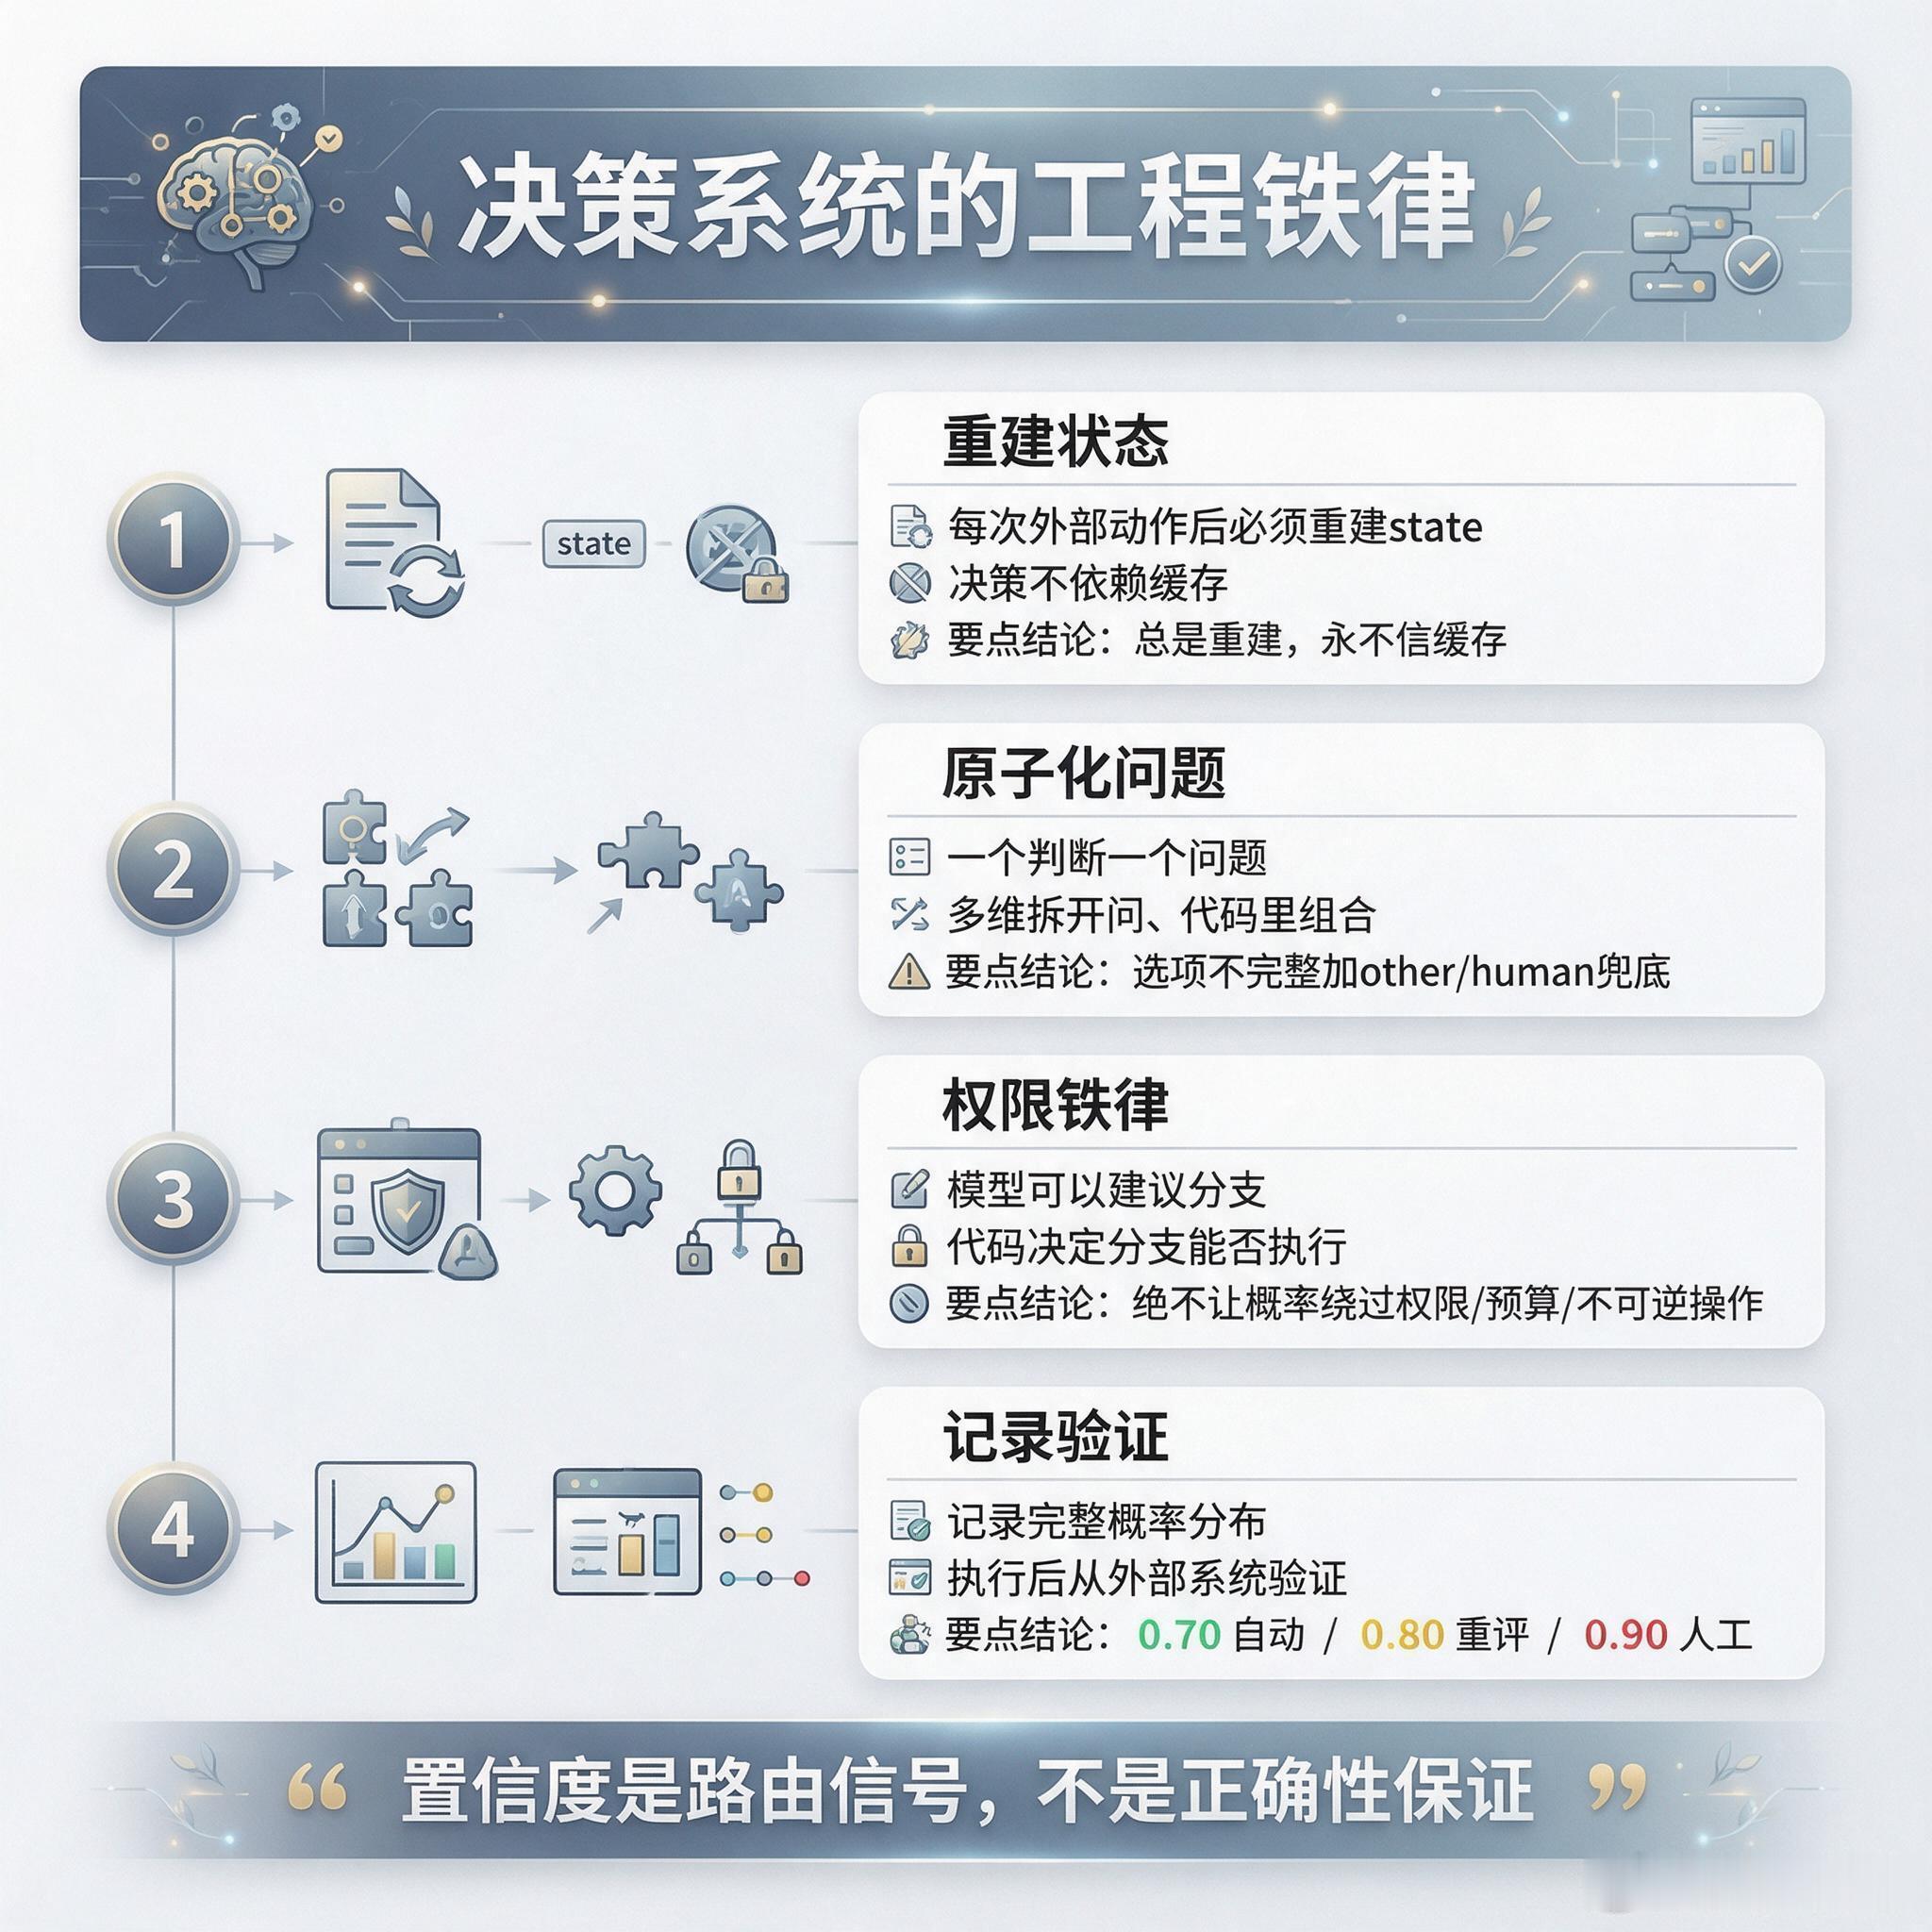
四、工程要点(结论)1、每次外部动作后必须重建 state,决策要基于最新状态,而不是缓存;2、问题要原子化:一个判断一个问题,多个维度拆开问、在代码里组合;3、选项不完整时加 other / human 兜底,资格规则放代码里,让模型看不到不可能的动作;4、置信度是路由信号,不是正确性保证:内部标签 0.70 可直接自动处理,Agent 交接 0.80 重新评估,浏览器 / 工具动作 0.90 问人工,发布 / 支付 / 删除必须政策加人工;5、铁律:模型可以建议分支,代码决定分支能否执行 —— 绝不让概率绕过权限、预算或不可逆操作控制;6、记录完整概率分布而非只记赢家标签,执行后从外部系统验证效果。
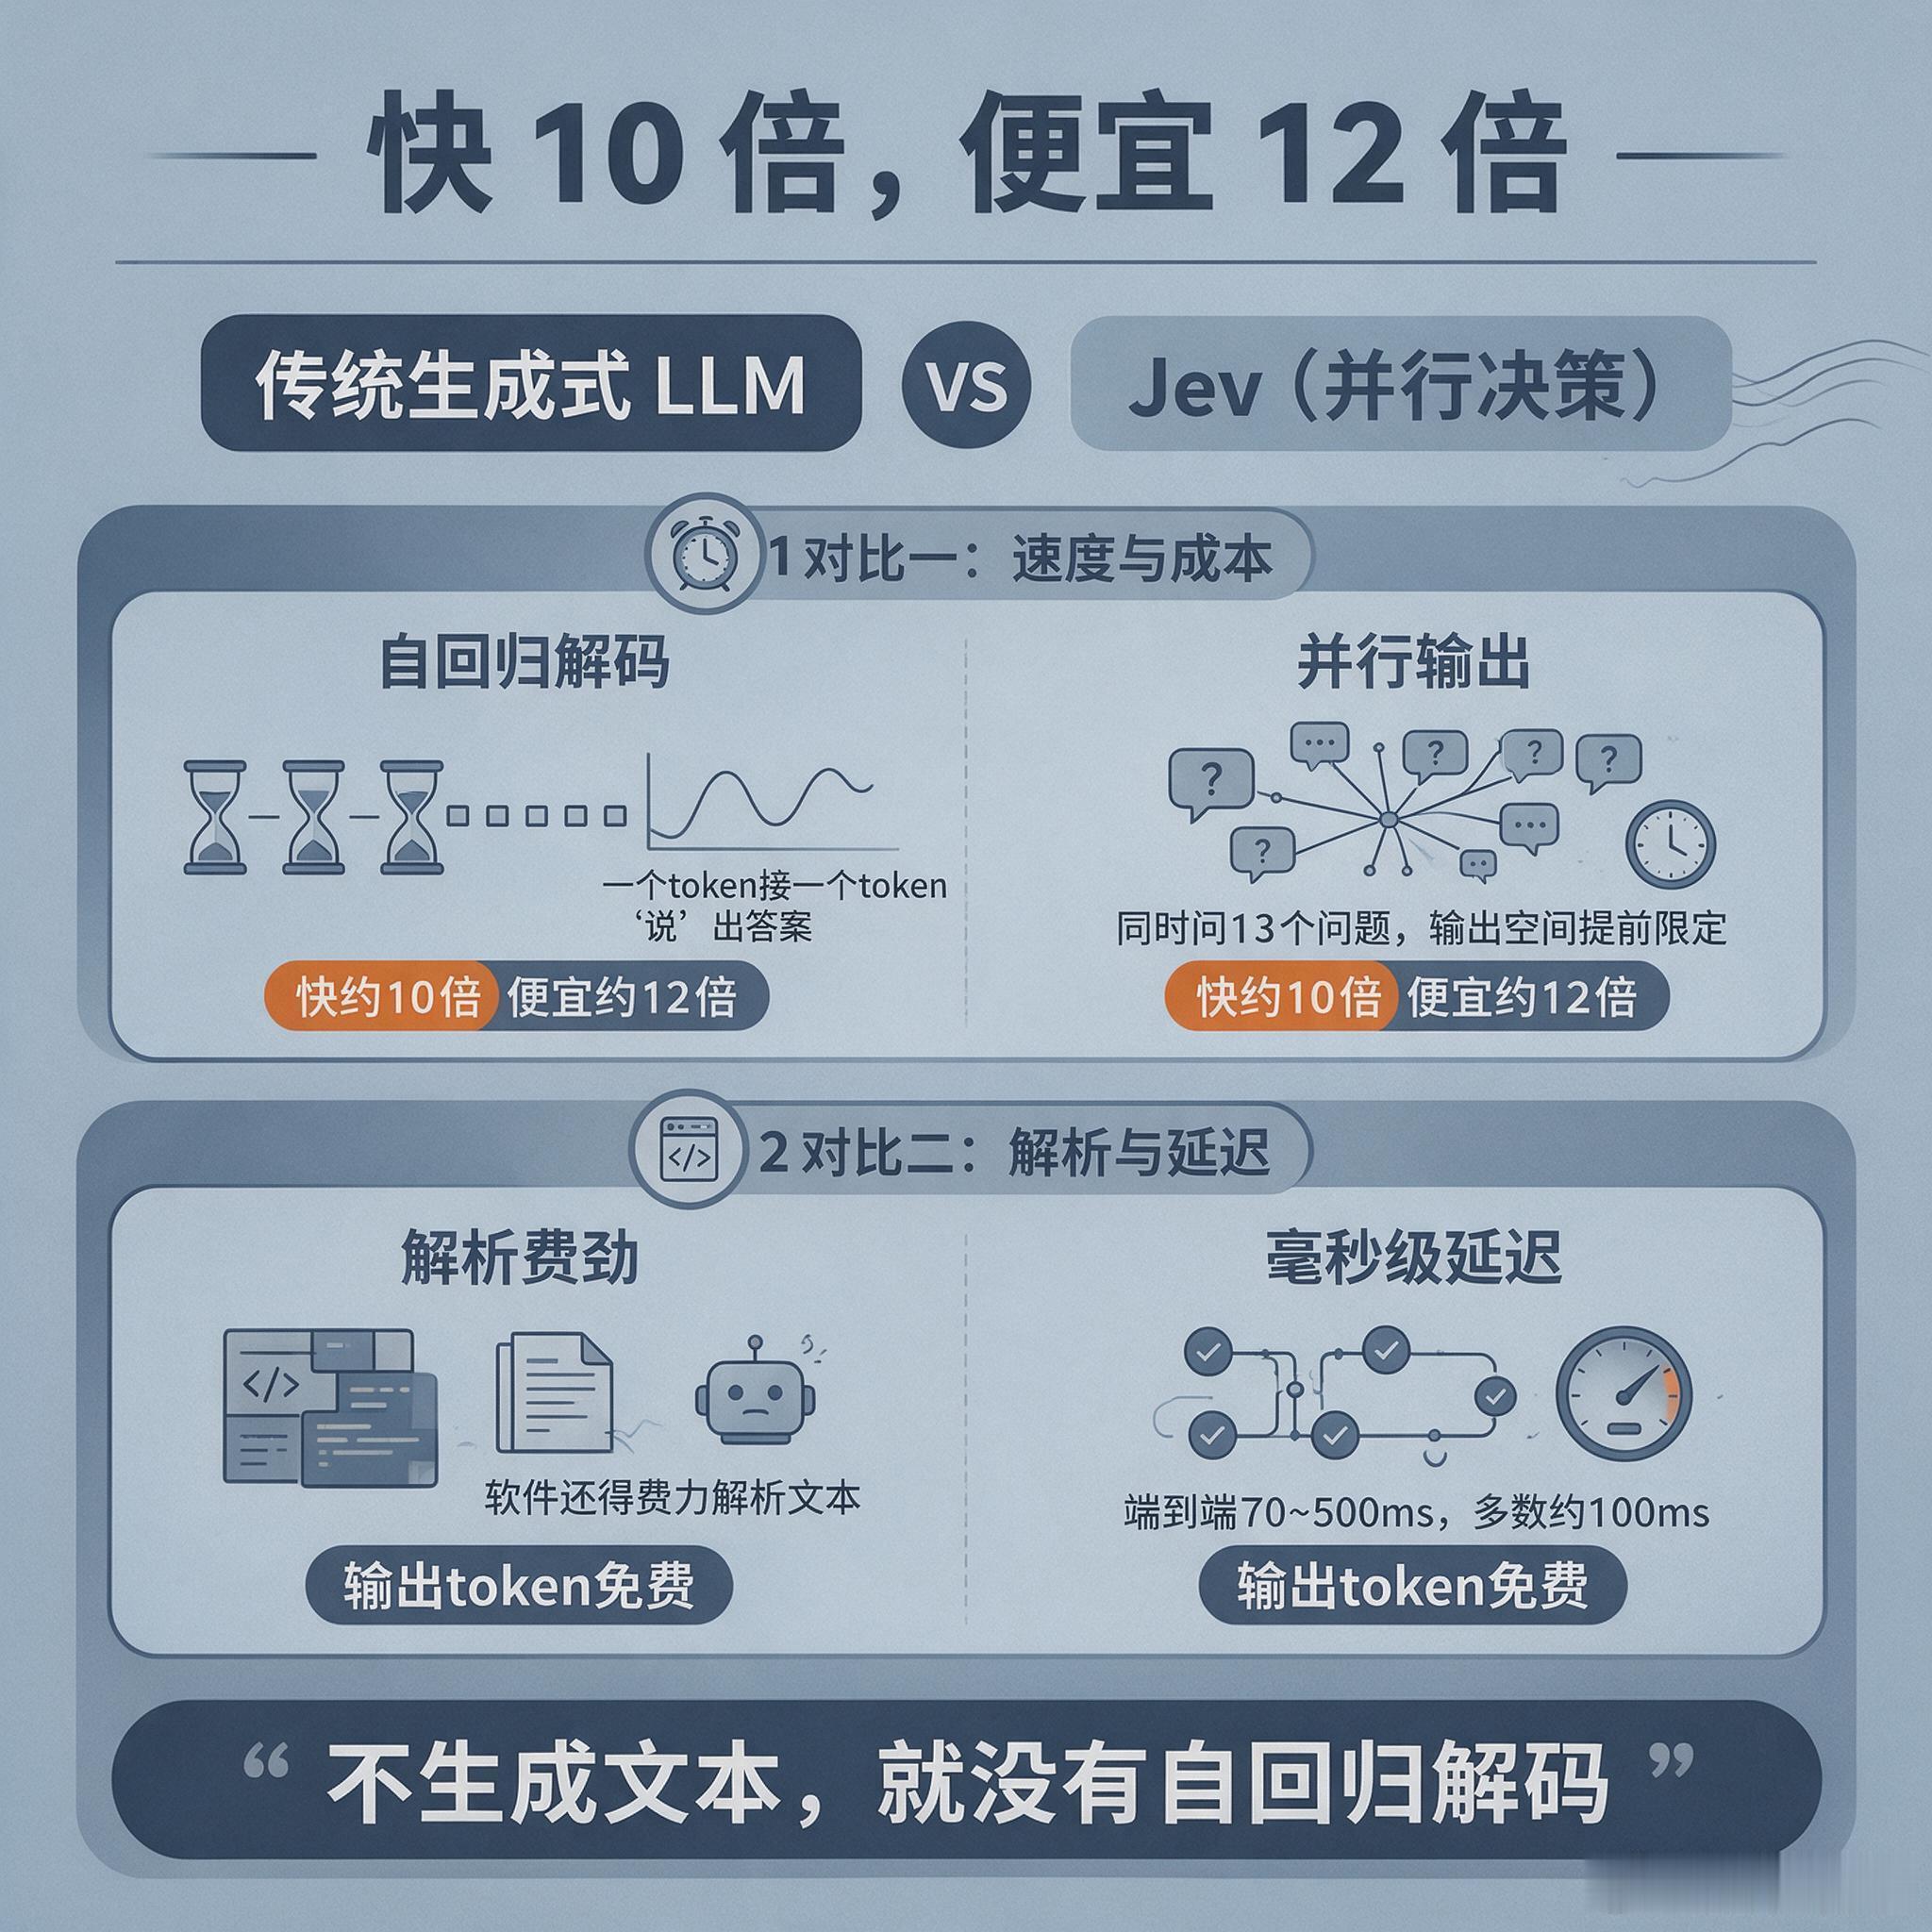
五、为什么快不生成文本 = 没有自回归解码,输出空间被提前限定,还能并行回答多个独立问题。一次调用同时问 13 个问题,比分开问 13 次快约 10 倍、便宜约 12 倍。定价:输入 0.042 美元 / 百万 token(约 0.28 元人民币),输出 token 免费;端到端延迟 70~500ms,多数约 100ms。
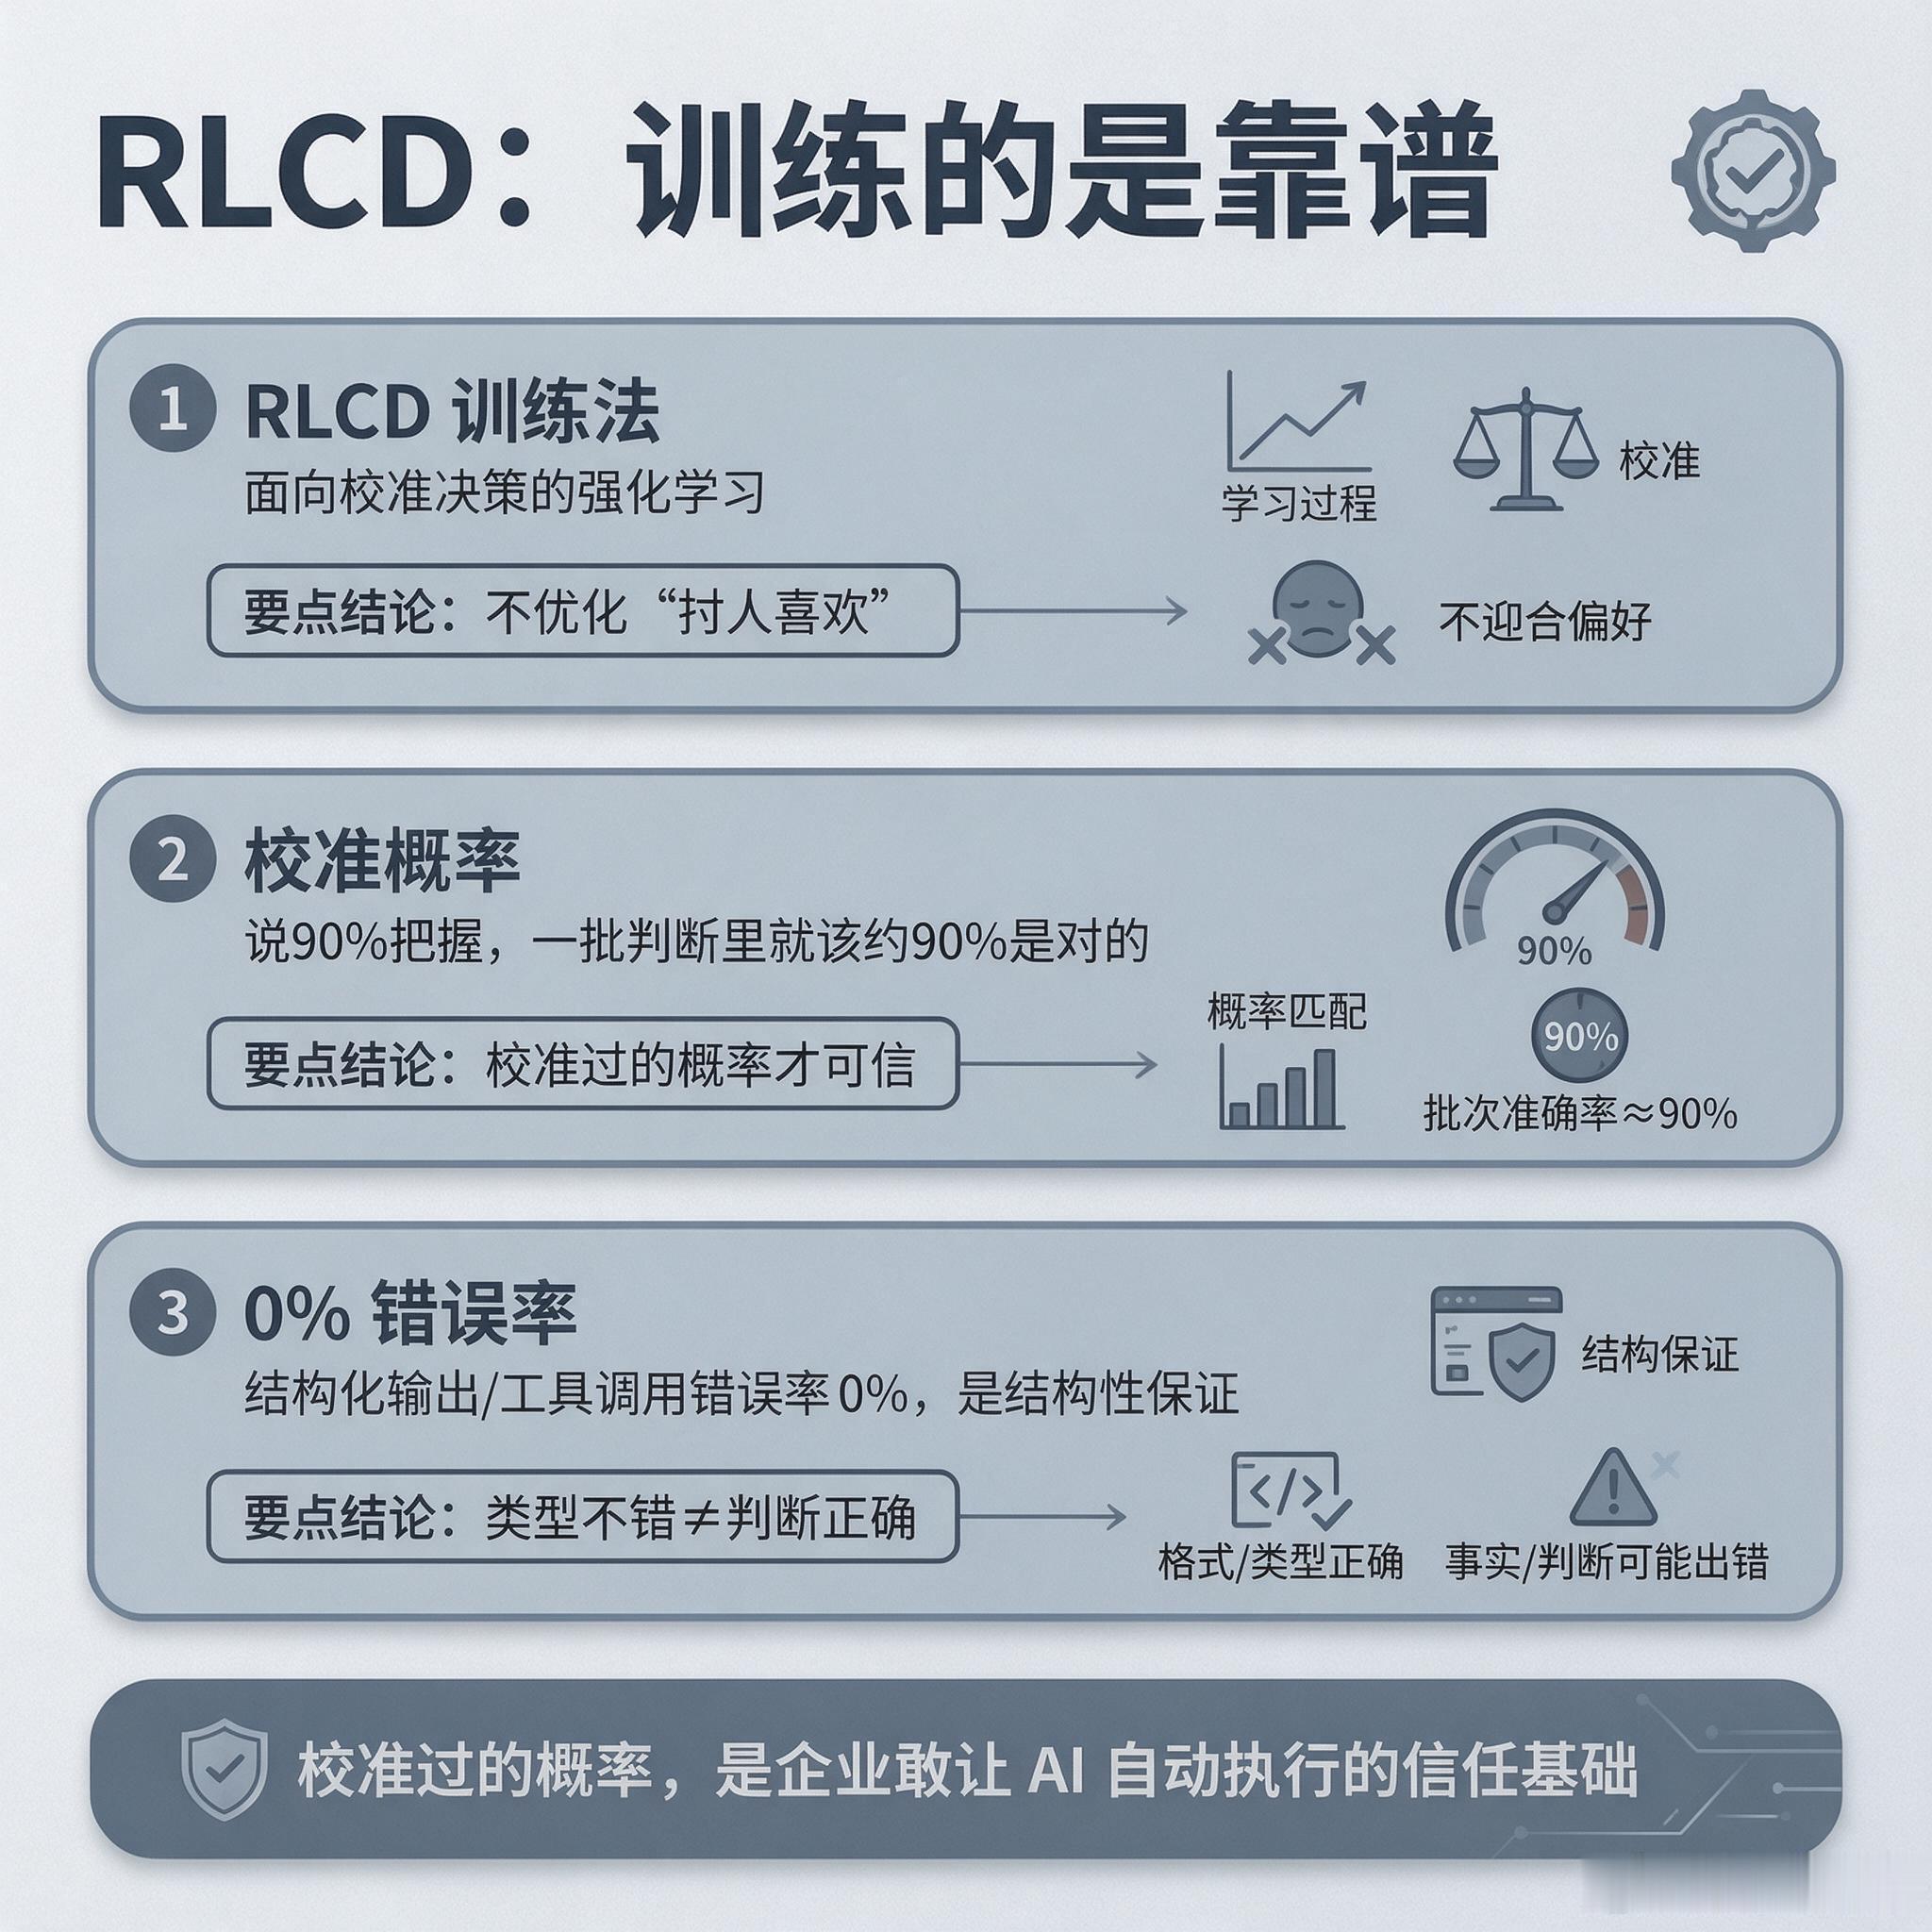
六、RLCD:训练的是 "靠谱"Jev 的训练方法叫 RLCD(面向校准决策的强化学习):不优化 "回答讨不讨人喜欢",而是优化概率校准—— 模型说 90% 把握,一批判断里就该约 90% 是对的。校准过的概率,是企业敢让 AI 自动执行的信任基础。它宣称结构化输出 / 工具调用错误率 0%,这是结构性保证(输出被 schema 限定,不可能返回选项之外的值),但类型不错 ≠ 判断正确,它完全可能自信地选错。
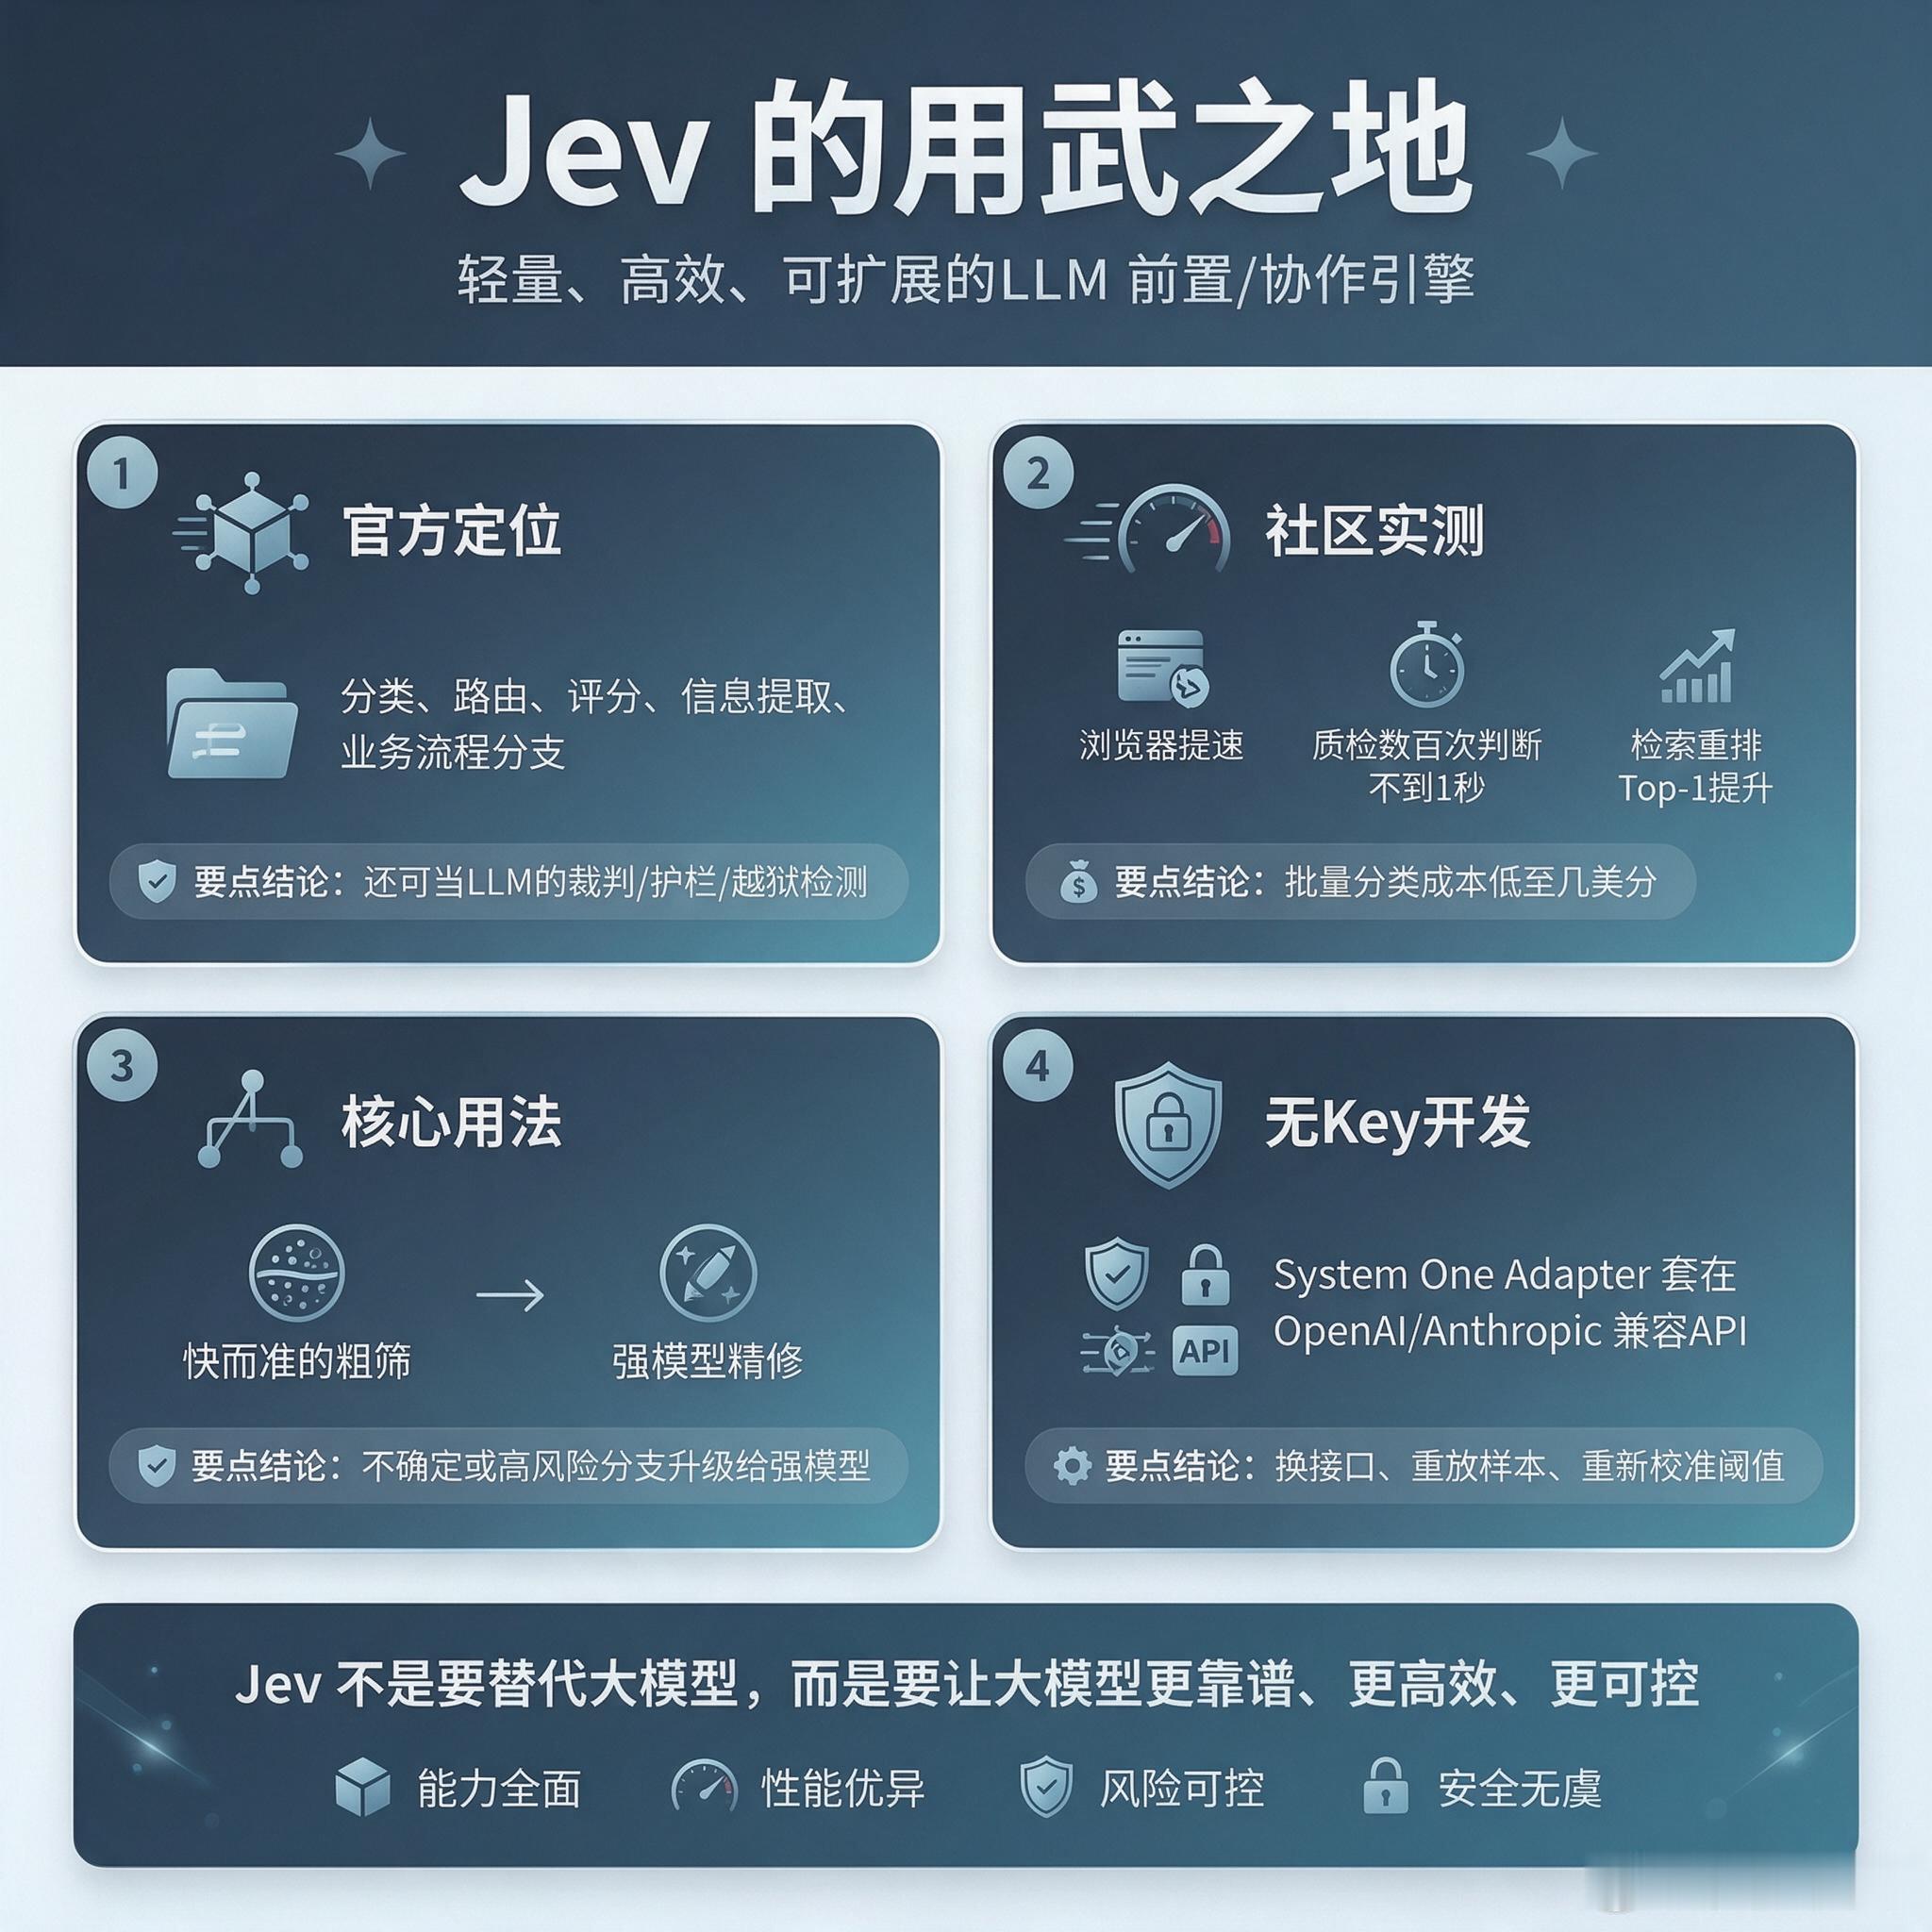
七、能干什么官方定位:分类、路由、评分、信息提取、业务流程分支,以及给 LLM 当裁判、护栏、越狱检测。社区实测已验证的结论:浏览器任务提速、写作质检数百次判断不到 1 秒、检索重排 Top-1 大幅提升、批量邮件 / 论文分类成本低至几美分。核心用法是 "快而准的粗筛 + 强模型精修":不确定或高风险的分支升级给更强模型。
没 Key 也能先开发:官方提供 System One Adapter,套在 OpenAI/Anthropic 兼容 API 上返回同样的类型化结果,先做完系统,拿到 Key 只换接口、重放样本、重新校准阈值。
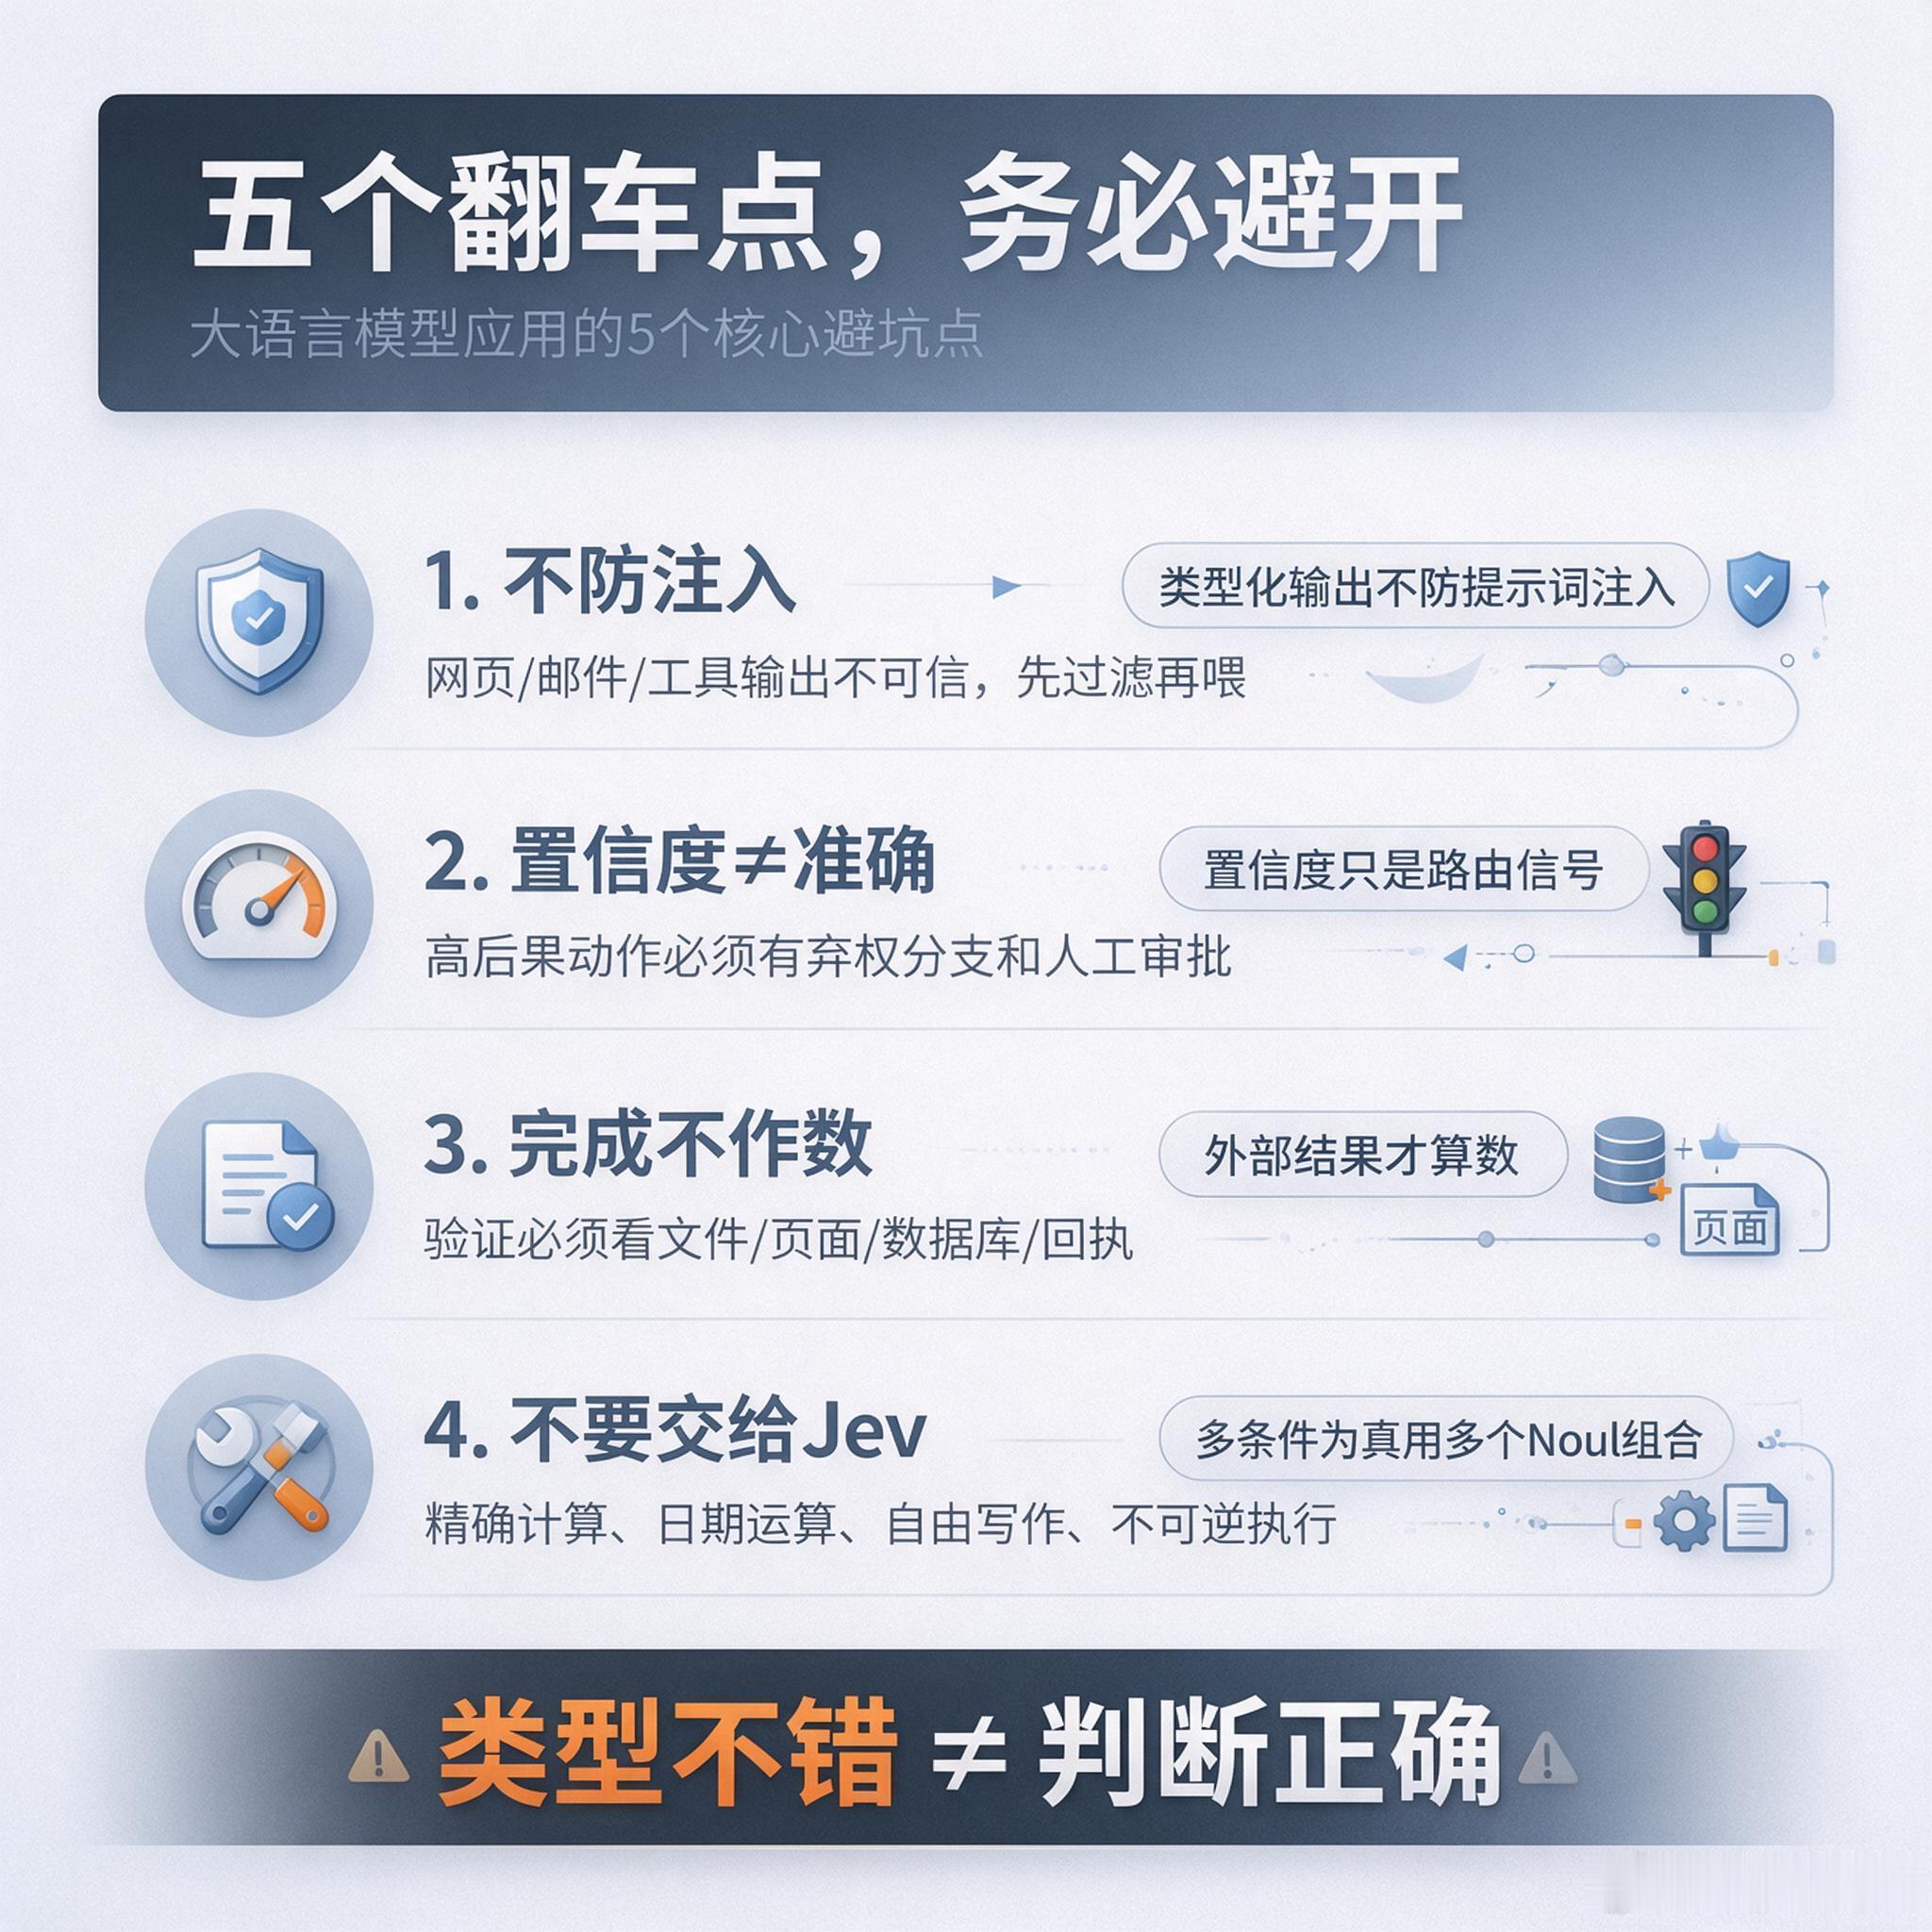
八、会翻车的地方1、类型化输出不防提示词注入:网页、邮件、工具输出都是不可信数据,要先过滤再喂给 Jev;2、置信度 ≠ 准确率:高后果动作必须有弃权分支和人工审批;3、"完成" 标签不作数:验证必须看文件、页面、数据库、回执等外部结果;4、Choice 不能当多标签用:多个条件可能同时为真时,用多个独立 Noul 再在代码里组合;5、精确计算、日期运算、自由写作、不可逆执行不要交给 Jev。
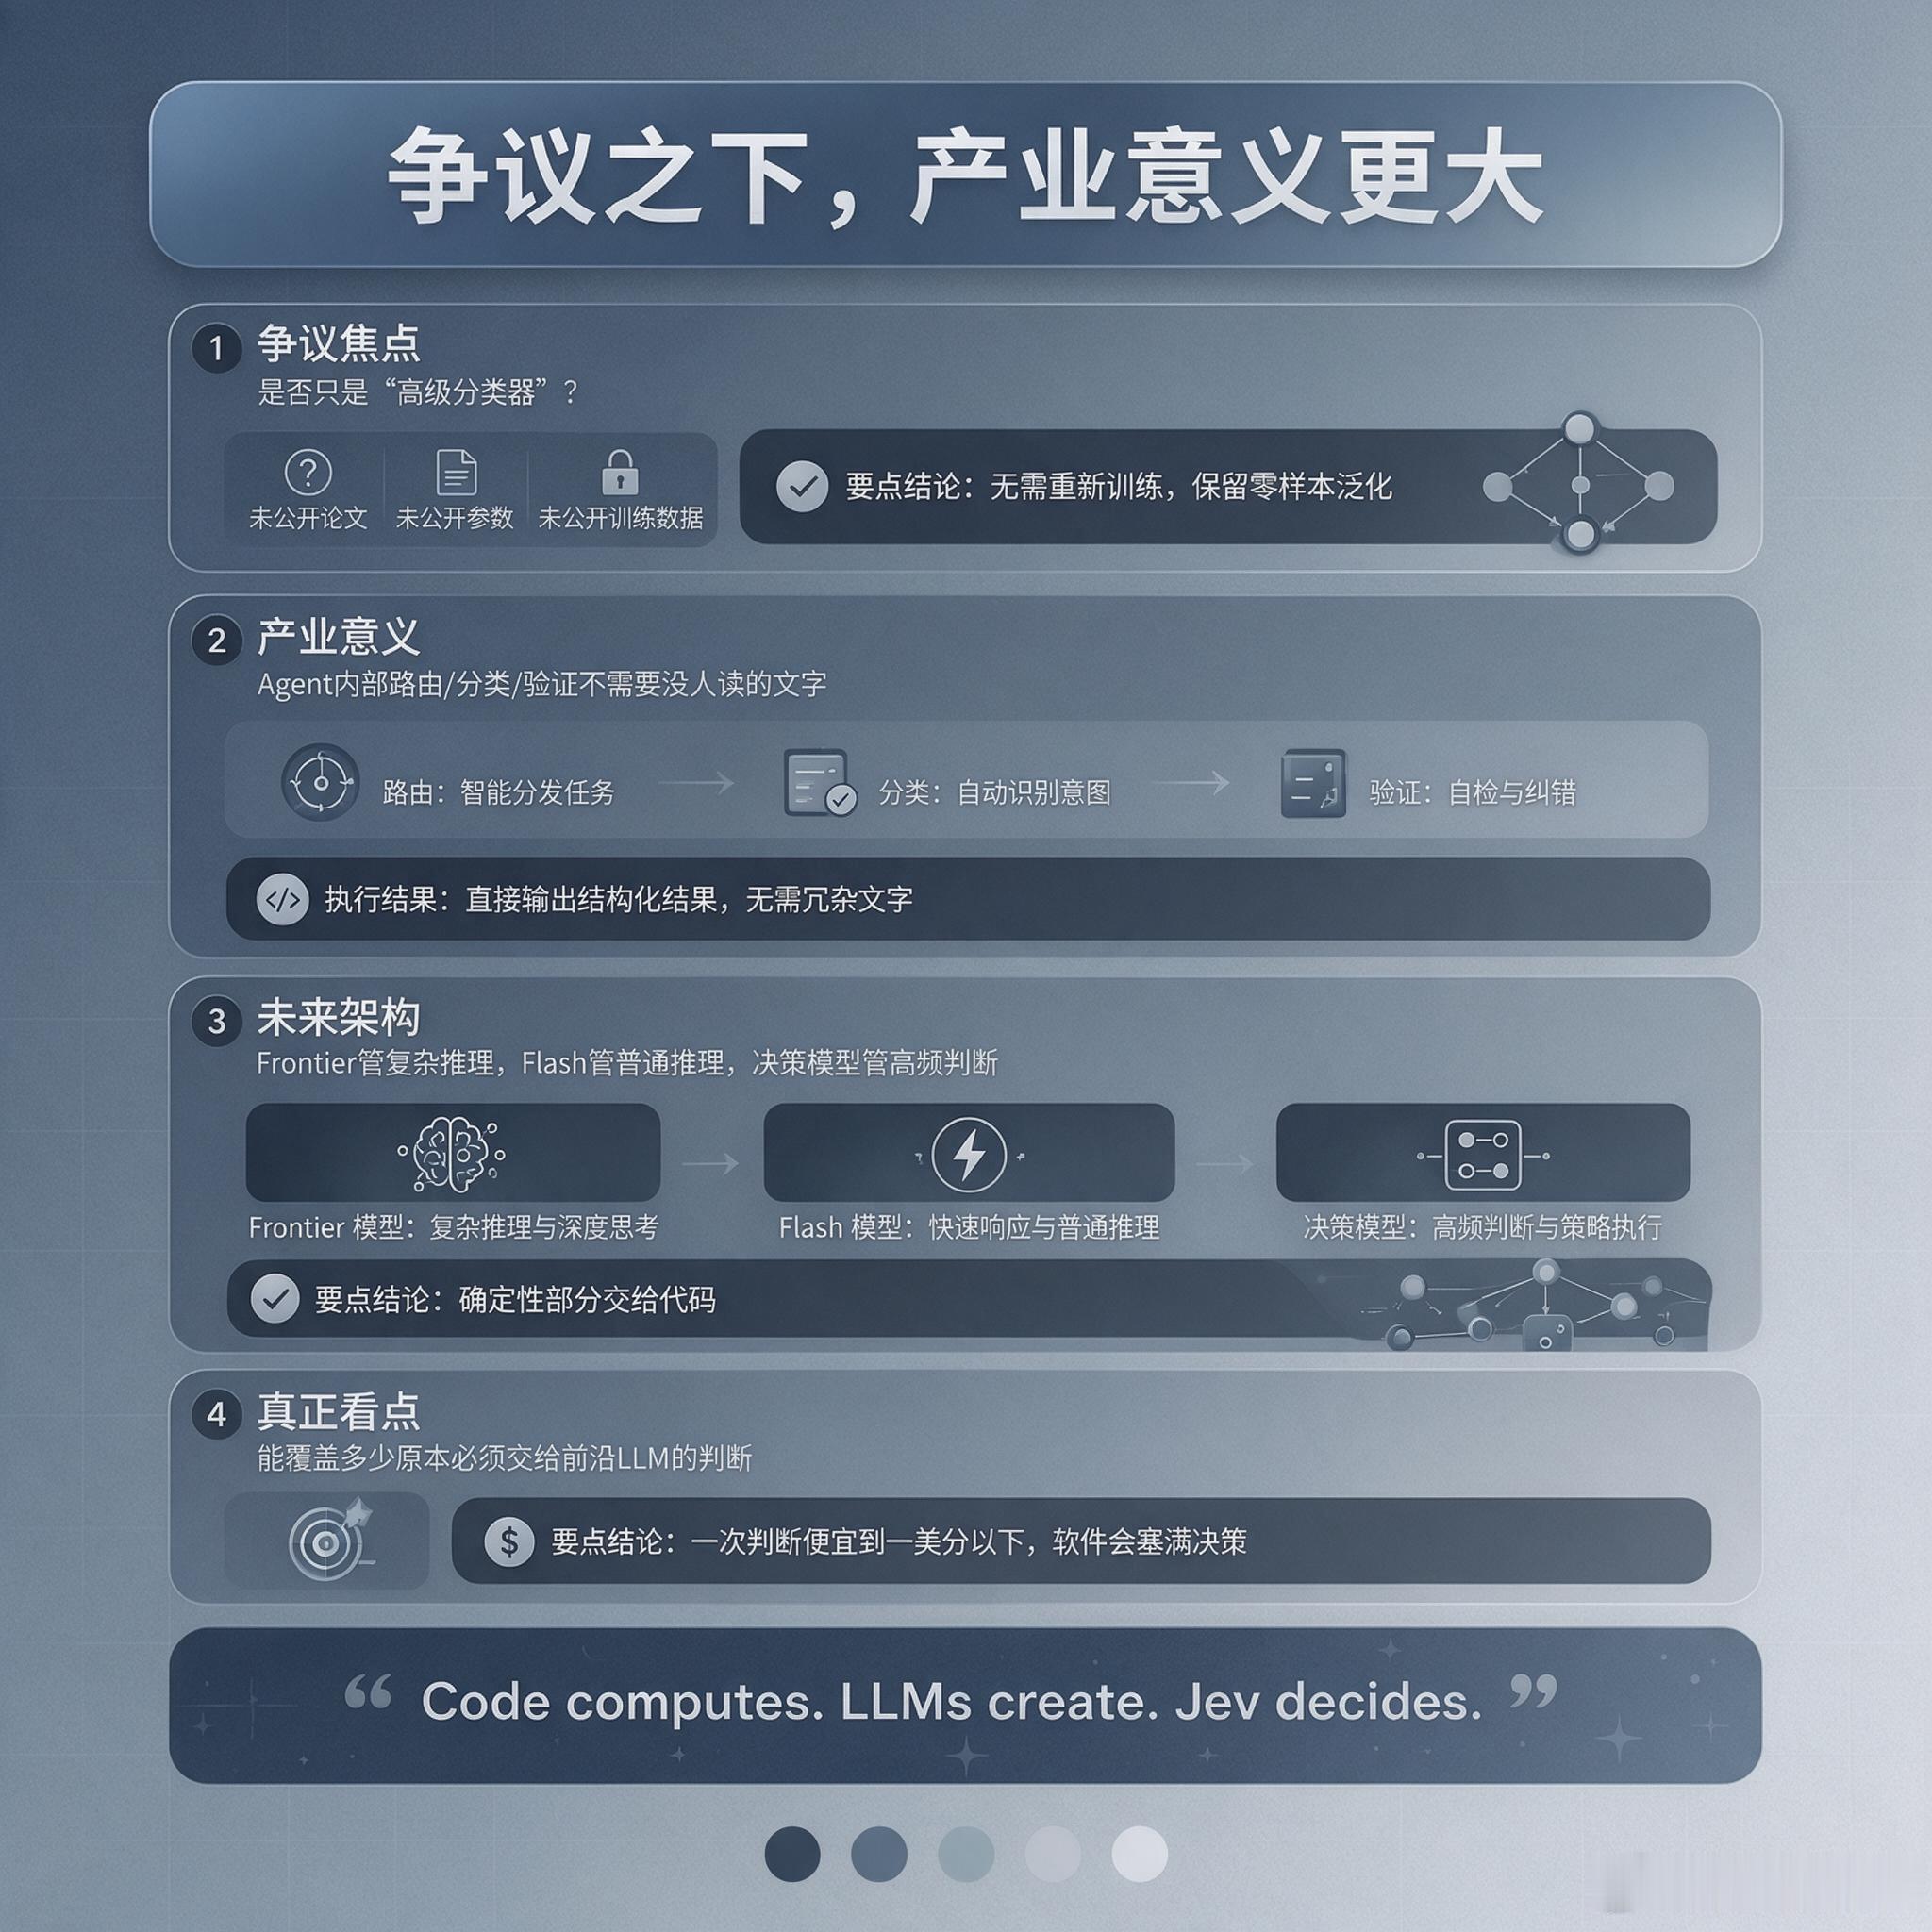
九、争议与意义争议在于:它是否只是 "高级分类器"?区别是不用为每个任务重新训练、保留零样本泛化,但官方没公开论文、参数规模和训练数据,无法独立验证。
它的产业意义更值得关注:Agent 内部大量路由、分类、验证步骤,其实不需要一段没人读的文字。未来更现实的架构是多层分工——Frontier 模型管复杂推理,Flash 管普通推理,决策模型管高频判断,确定性部分交给代码。
Code computes. LLMs create. Jev decides. Fresh state proves the result.(代码负责计算,LLM 负责创造,Jev 负责决策,新状态负责证明结果。)
真正值得跟踪的,不是它快多少倍,而是能覆盖多少原本必须交给前沿 LLM 的判断—— 当一次判断便宜到一美分以下,软件会在你从没想过的地方,塞满决策。
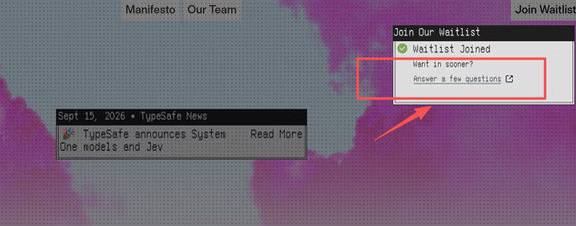
申请:typesafe.ai
HOW I AI 程序员