塔斯娱乐资讯网

蔓涵爱看科技的文章

最近注意到一个挺有意思的趋势:AI 公司们开始扎堆开放自己的搜索能力了。 腾讯把内部用了一年多的元宝搜索通过 API 对外开放了,DeepSeek 也在不久前上线了自研的 Search API。两家几乎前后脚,而且做的是同一件事,就是给开发者提供一套现成的联网搜索能力,让你的 Agent 能实时获取外部信息。 为 ​
最近注意到一个挺有意思的趋势:AI 公司们开始扎堆开放自己的搜索能力了。 腾讯把内部用了一年多的元宝搜索通过 API 对外开放了,DeepSeek 也在不久前上线了自研的 Search API。两家几乎前后脚,而且做的是同一件事,就是给开发者提供一套现成的联网搜索能力,让你的 Agent 能实时获取外部信息。 为 ​
昨天整个互联网安全圈都炸了。几个高危漏洞同一天集中爆出来,影响范围大到什么程度呢?就连日本首相高市早苗都亲自发推,让所有人赶紧检查自己的网站用没用 PHP,补丁出了马上打,来不及的话,先把网站停掉。荷兰议会、荷兰国家安全中心、芬兰中央政府的网站,还有日本的 Pixiv,全都临时下线了。 先 ​

昨天整个互联网安全圈都炸了。几个高危漏洞同一天集中爆出来,影响范围大到什么程度呢?就连日本首相高市早苗都亲自发推,让所有人赶紧检查自己的网站用没用 PHP,补丁出了马上打,来不及的话,先把网站停掉。荷兰议会、荷兰国家安全中心、芬兰中央政府的网站,还有日本的 Pixiv,全都临时下线了。 先 ​

10月17号到20号,DeepSeek在四天里接连干了三件事:发布V4.1 Flash新版本1017、开放自研搜索API、全面开源内部推理框架DeepInfer。单看哪一件都像常规更新,连起来看才值得琢磨。 第一件事,1017这个版本官方定义是minor update,模型结构没变、分词器没变、提示词格式没变,只改了权重。结果在DeepSW ​

10月17号到20号,DeepSeek在四天里接连干了三件事:发布V4.1 Flash新版本1017、开放自研搜索API、全面开源内部推理框架DeepInfer。单看哪一件都像常规更新,连起来看才值得琢磨。 第一件事,1017这个版本官方定义是minor update,模型结构没变、分词器没变、提示词格式没变,只改了权重。结果在DeepSW ​
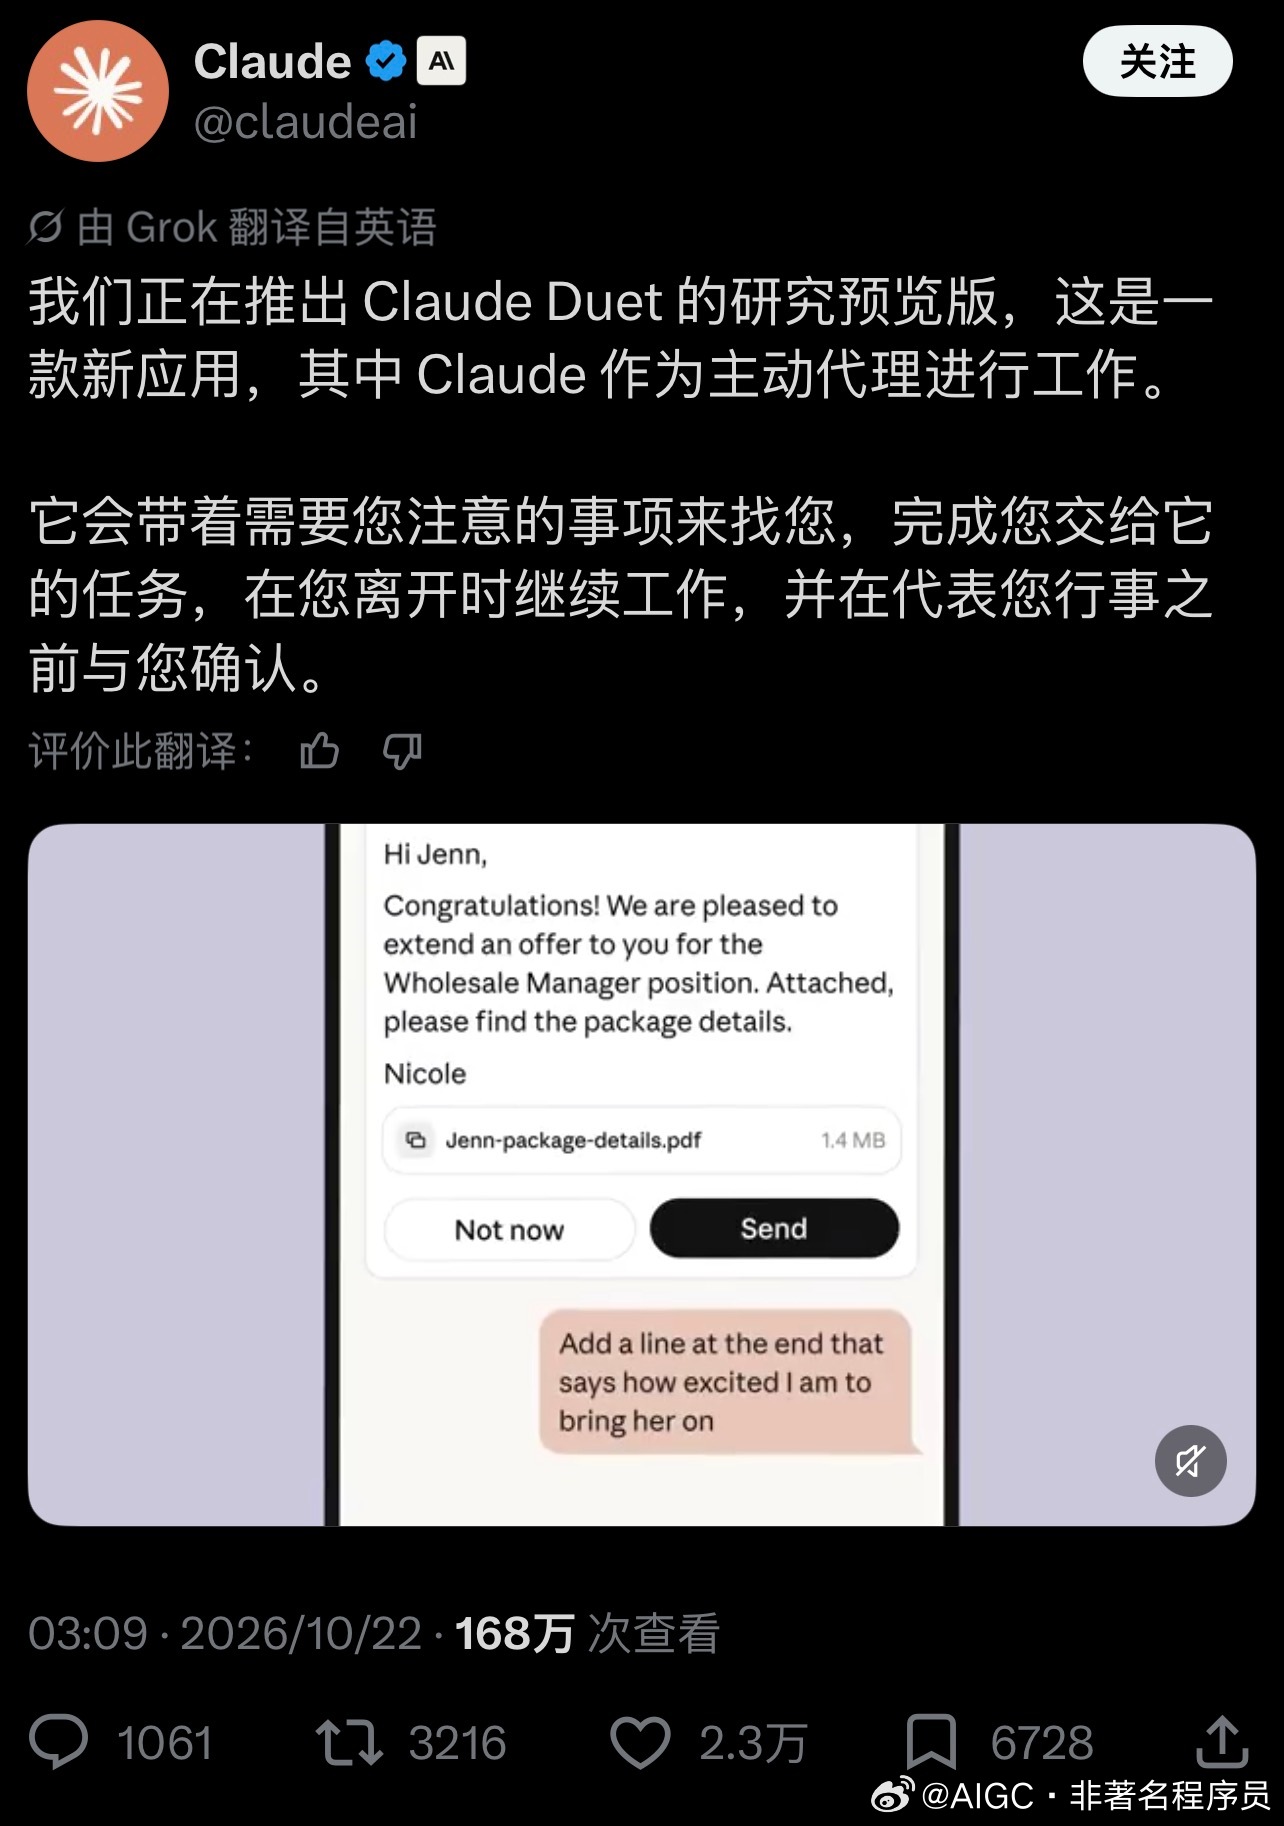
Anthropic 正式发布了 Claude Duet,基于 Opus 5.5 打造的主动式 AI Agent。

注意这个词,主动式。以前的 AI 助手都是你问它答,Claude Duet 反过来了,它会主动来找你。

每天给你汇报邮件、日程和值得注意的事项。你连接的那些应用,它在后台持续盯着,发现问题直接通知你。不用你开口,它自己先把 ​

Anthropic 正式发布了 Claude Duet,基于 Opus 5.5 打造的主动式 AI Agent。 注意这个词,主动式。以前的 AI 助手都是你问它答,Claude Duet 反过来了,它会主动来找你。 每天给你汇报邮件、日程和值得注意的事项。你连接的那些应用,它在后台持续盯着,发现问题直接通知你。不用你开口,它自己先把 ​

Anthropic 正式发布了 Claude Duet,基于 Opus 5.5 打造的主动式 AI Agent。 注意这个词,主动式。以前的 AI 助手都是你问它答,Claude Duet 反过来了,它会主动来找你。 每天给你汇报邮件、日程和值得注意的事项。你连接的那些应用,它在后台持续盯着,发现问题直接通知你。不用你开口,它自己先把 ​
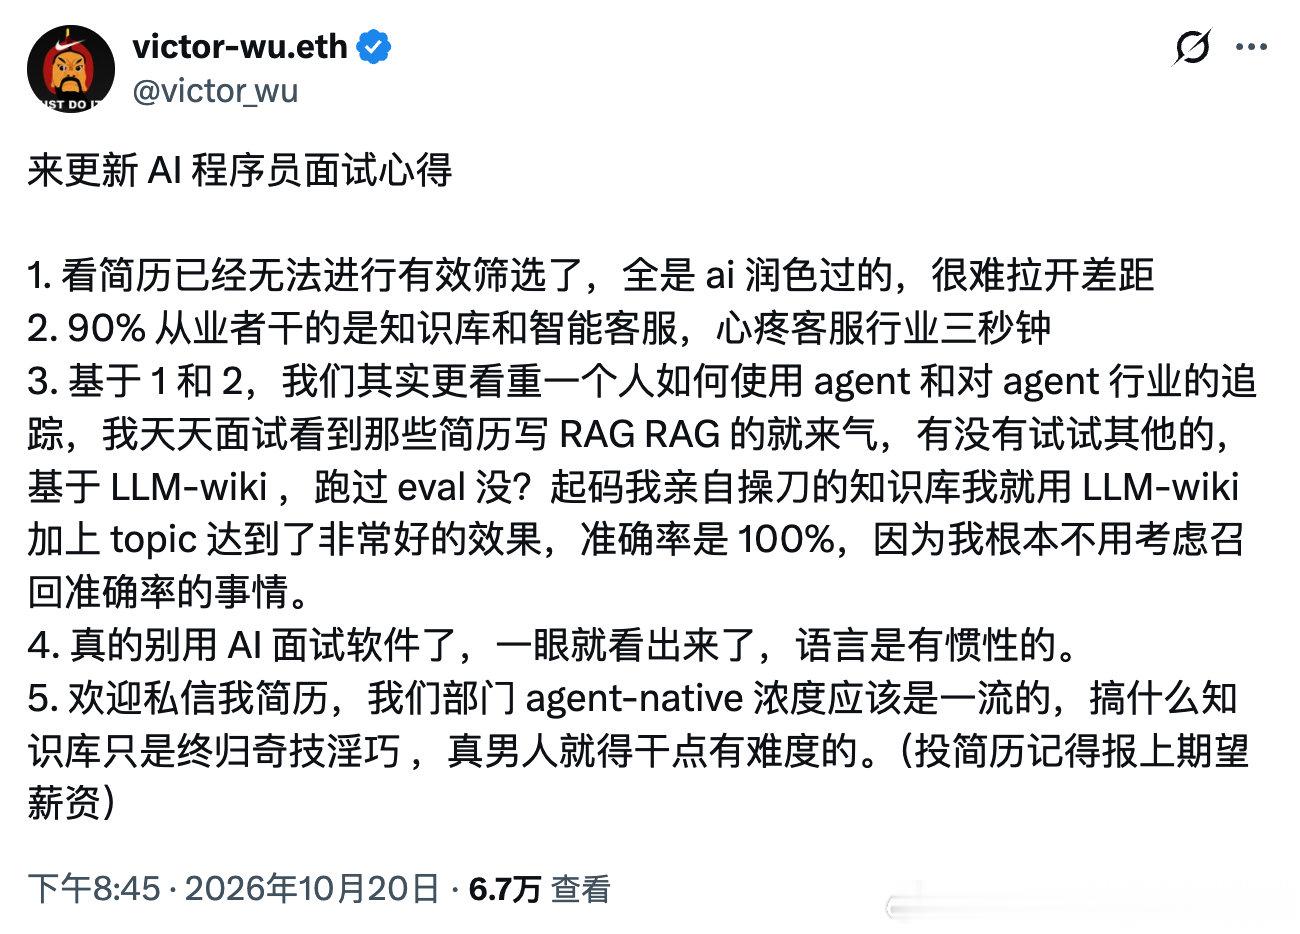
是不是现在的简历已经没法看了?感觉没有任何参考价值了。 ​

是不是现在的简历已经没法看了?感觉没有任何参考价值了。 ​

是不是现在的简历已经没法看了?感觉没有任何参考价值了。 ​

昨晚得到的秋季发布会上,快刀青衣讲了一个我很有共鸣的判断:这两年大家一直在追最新最强的模型,GPT出新版赶紧试,DeepSeek更新赶紧换。但追了两年之后他越来越确信,模型的聪明程度已经不是瓶颈了。 真正的瓶颈是个人上下文。现在主流大模型的智商都够用,但很多人用一段时间就觉得帮助没想象中大 ​

昨晚得到的秋季发布会上,快刀青衣讲了一个我很有共鸣的判断:这两年大家一直在追最新最强的模型,GPT出新版赶紧试,DeepSeek更新赶紧换。但追了两年之后他越来越确信,模型的聪明程度已经不是瓶颈了。 真正的瓶颈是个人上下文。现在主流大模型的智商都够用,但很多人用一段时间就觉得帮助没想象中大 ​
其实,当你看到这种时间差、地域差的时候,这就是时代的红利,就看你怎么去融入,去抓住这种机会。

时间差就是红利差。 ​

其实,当你看到这种时间差、地域差的时候,这就是时代的红利,就看你怎么去融入,去抓住这种机会。 时间差就是红利差。 ​

其实,当你看到这种时间差、地域差的时候,这就是时代的红利,就看你怎么去融入,去抓住这种机会。 时间差就是红利差。 ​

有一说一,DeepSeek 才是大家心中真正的 OpenAI 。 ​

有一说一,DeepSeek 才是大家心中真正的 OpenAI 。 ​
写的真好。

当然了博主是从企业 Agent 的角度来入手谈 FDE 的,其实除了 to B 的企业 Agent ,还有面对 to C 的产品 Agent ,这两者路径是不一样的。

其实,现在 Agent 赛道里真正跑出来的产品,都是不走企业定制路线的。Cursor、Bolt、Replit Agent、v0,它们解决的是个人开发者和小团队的问题,靠 ​

写的真好。 当然了博主是从企业 Agent 的角度来入手谈 FDE 的,其实除了 to B 的企业 Agent ,还有面对 to C 的产品 Agent ,这两者路径是不一样的。 其实,现在 Agent 赛道里真正跑出来的产品,都是不走企业定制路线的。Cursor、Bolt、Replit Agent、v0,它们解决的是个人开发者和小团队的问题,靠 ​

写的真好。 当然了博主是从企业 Agent 的角度来入手谈 FDE 的,其实除了 to B 的企业 Agent ,还有面对 to C 的产品 Agent ,这两者路径是不一样的。 其实,现在 Agent 赛道里真正跑出来的产品,都是不走企业定制路线的。Cursor、Bolt、Replit Agent、v0,它们解决的是个人开发者和小团队的问题,靠 ​
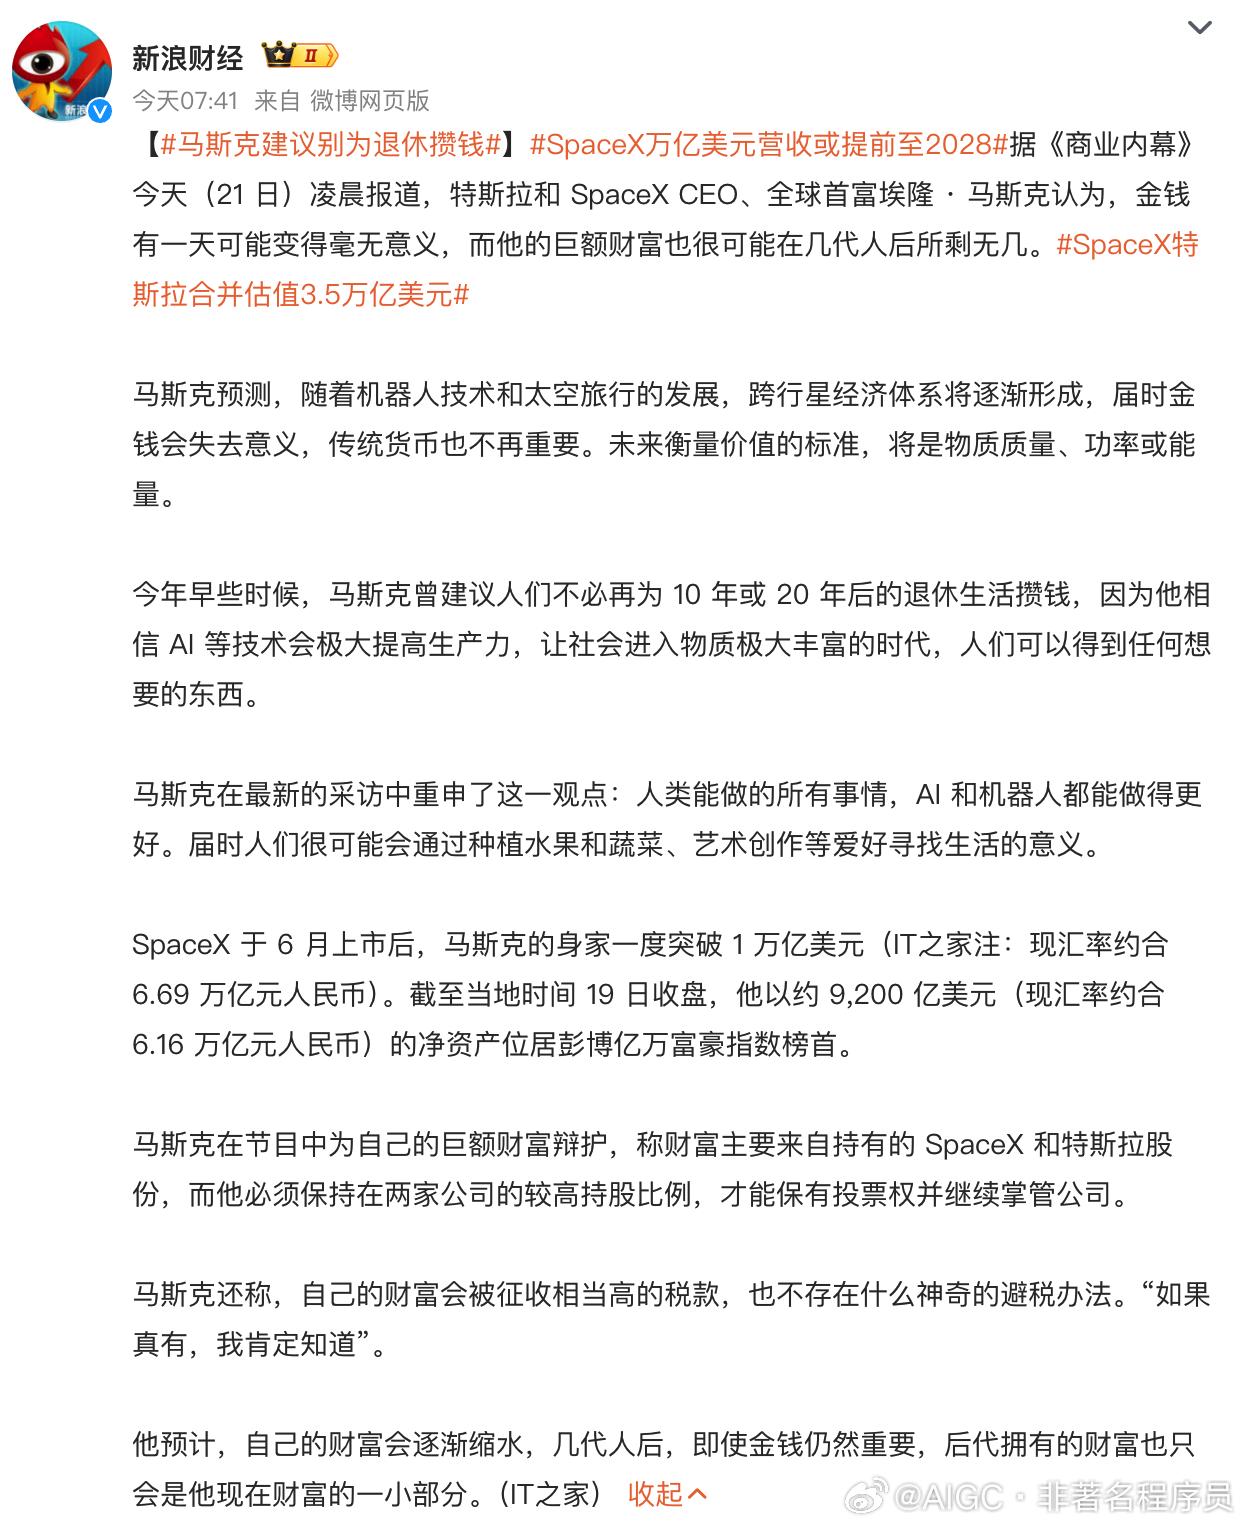
#马斯克建议别为退休攒钱#马斯克说这话毫无含金量,没有任何借鉴意义。

对于普通人来讲,再怎么攒钱,到人走茶凉的那一刻,钱也会被花完的,甚至到了老了都没有钱花。

马斯克你是钱多的花不了,才有这烦恼。

普通人千万别信,谁信谁倒霉。

马斯克说:他相信 AI 等技术会极大提高生产力,让社会进入 ​

#马斯克建议别为退休攒钱#马斯克说这话毫无含金量,没有任何借鉴意义。 对于普通人来讲,再怎么攒钱,到人走茶凉的那一刻,钱也会被花完的,甚至到了老了都没有钱花。 马斯克你是钱多的花不了,才有这烦恼。 普通人千万别信,谁信谁倒霉。 马斯克说:他相信 AI 等技术会极大提高生产力,让社会进入 ​

#马斯克建议别为退休攒钱#马斯克说这话毫无含金量,没有任何借鉴意义。 对于普通人来讲,再怎么攒钱,到人走茶凉的那一刻,钱也会被花完的,甚至到了老了都没有钱花。 马斯克你是钱多的花不了,才有这烦恼。 普通人千万别信,谁信谁倒霉。 马斯克说:他相信 AI 等技术会极大提高生产力,让社会进入 ​

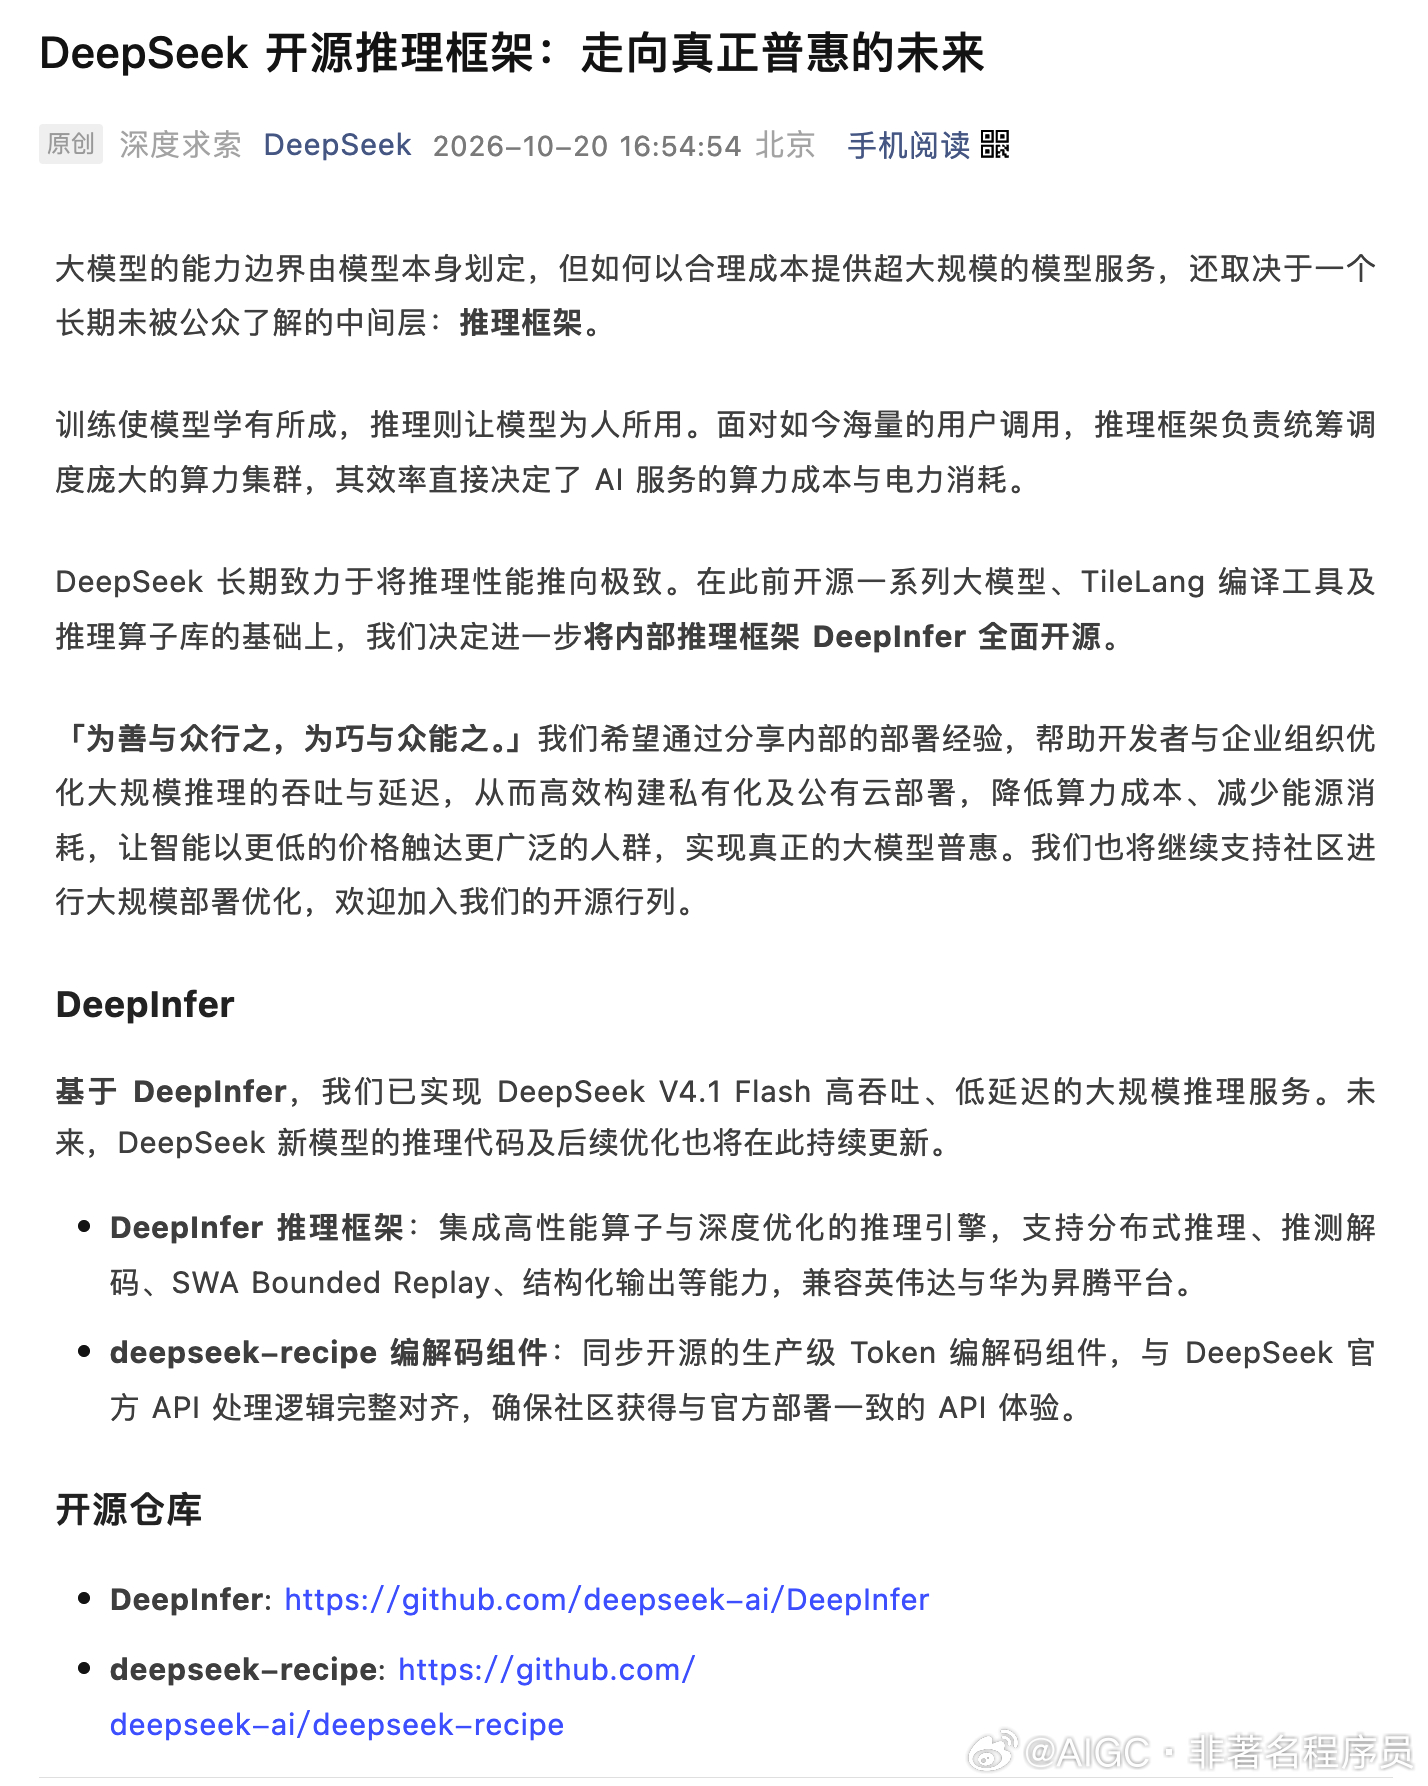
DeepSeek 把内部推理框架 DeepInfer 开源了,很多人第一反应可能是:这不是在帮竞争对手吗? 但换个角度想:推理框架开源之后,整个行业跑大模型的成本会下降,AI 服务会变得更便宜、更普及,最终使用 DeepSeek 服务的人也会更多。这一步看似大方,背后是一笔很清醒的账。 更有意思的是,这次开源的 ​

DeepSeek 把内部推理框架 DeepInfer 开源了,很多人第一反应可能是:这不是在帮竞争对手吗? 但换个角度想:推理框架开源之后,整个行业跑大模型的成本会下降,AI 服务会变得更便宜、更普及,最终使用 DeepSeek 服务的人也会更多。这一步看似大方,背后是一笔很清醒的账。 更有意思的是,这次开源的 ​
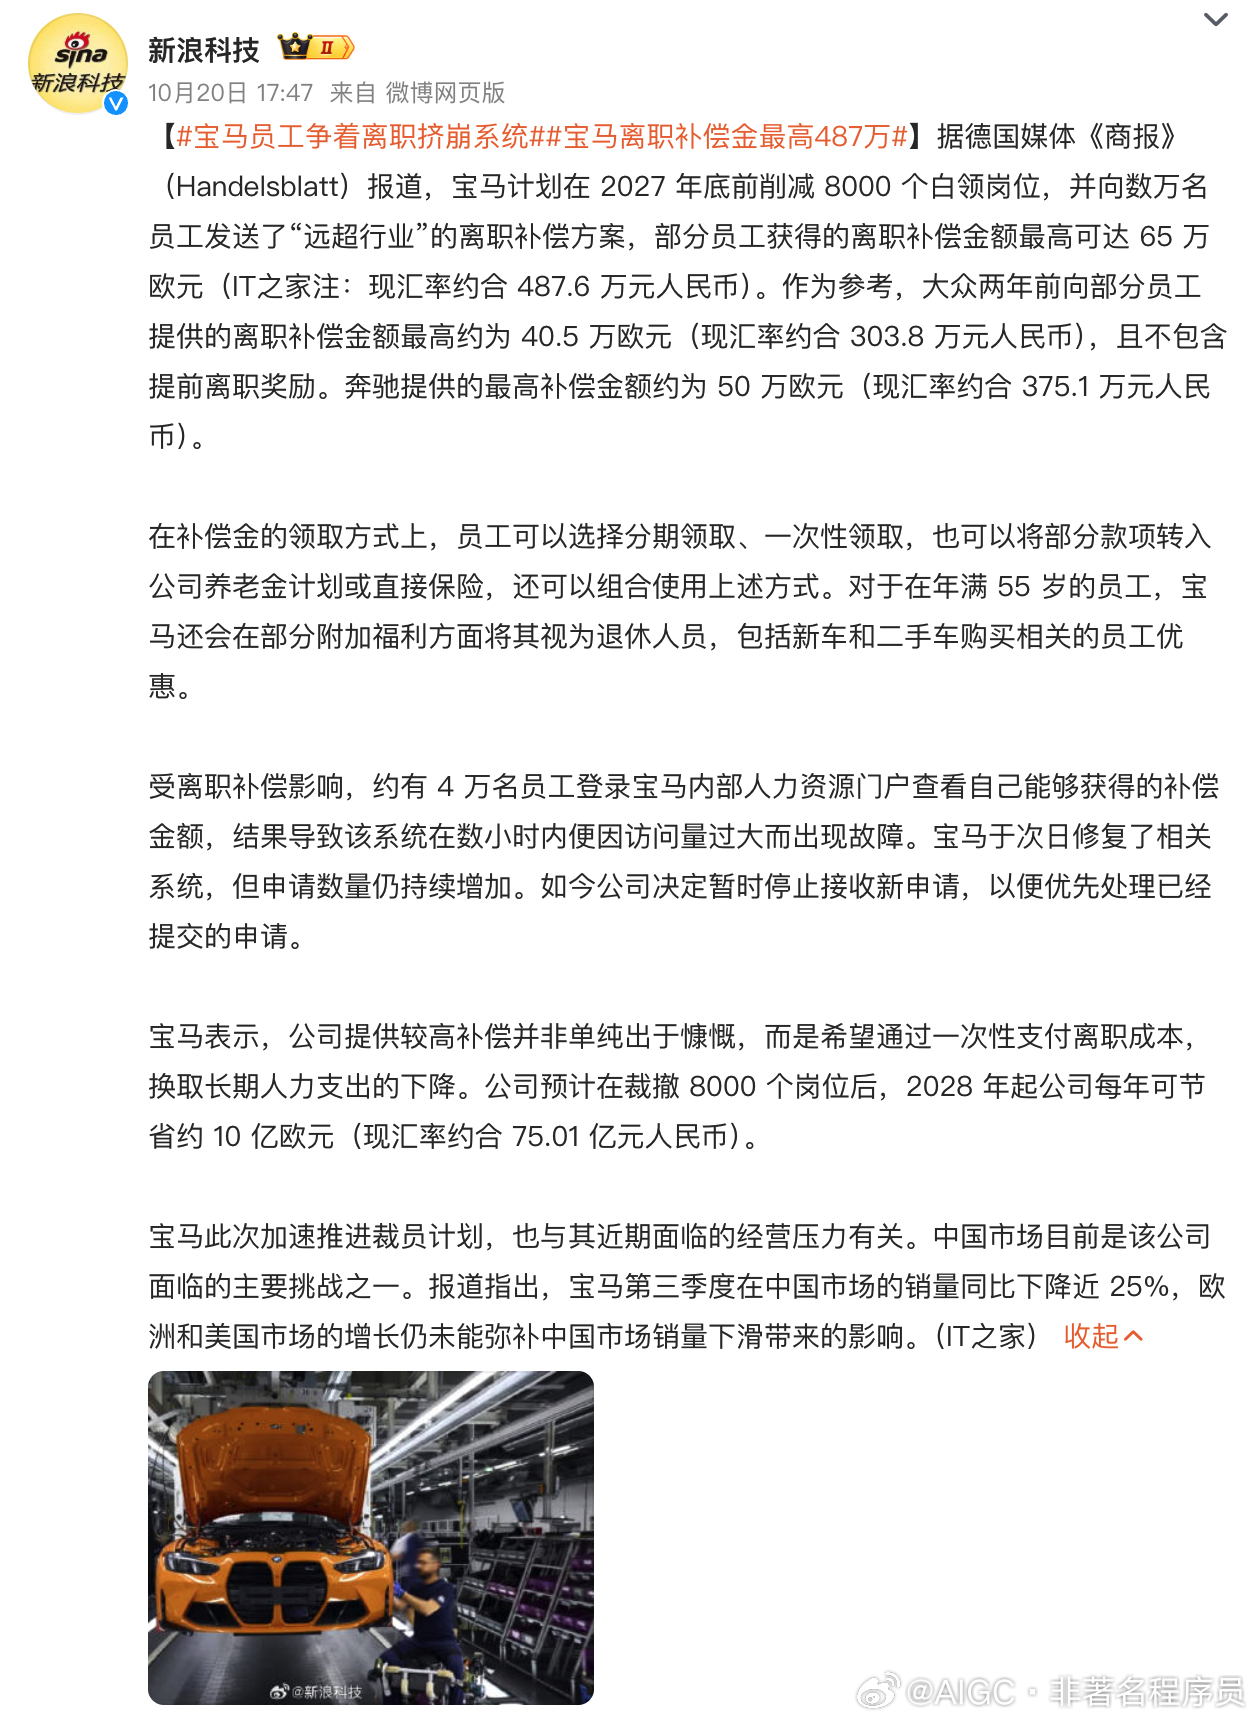
#宝马员工争着离职挤崩系统#这个世界真奇妙,见过怕被裁员的,没见过争相抢着被裁员的,还把系统挤崩溃了。

但是,宝马这波操作,细品之下,其实很有意思。

最高65万欧元的离职补偿,看起来是壕气冲天,实际上是一笔极其精明的商业账。

我换个说法:这笔钱的本质,是用一次性支出锁定长期收益。裁80 ​

#宝马员工争着离职挤崩系统#这个世界真奇妙,见过怕被裁员的,没见过争相抢着被裁员的,还把系统挤崩溃了。 但是,宝马这波操作,细品之下,其实很有意思。 最高65万欧元的离职补偿,看起来是壕气冲天,实际上是一笔极其精明的商业账。 我换个说法:这笔钱的本质,是用一次性支出锁定长期收益。裁80 ​

#宝马员工争着离职挤崩系统#这个世界真奇妙,见过怕被裁员的,没见过争相抢着被裁员的,还把系统挤崩溃了。 但是,宝马这波操作,细品之下,其实很有意思。 最高65万欧元的离职补偿,看起来是壕气冲天,实际上是一笔极其精明的商业账。 我换个说法:这笔钱的本质,是用一次性支出锁定长期收益。裁80 ​
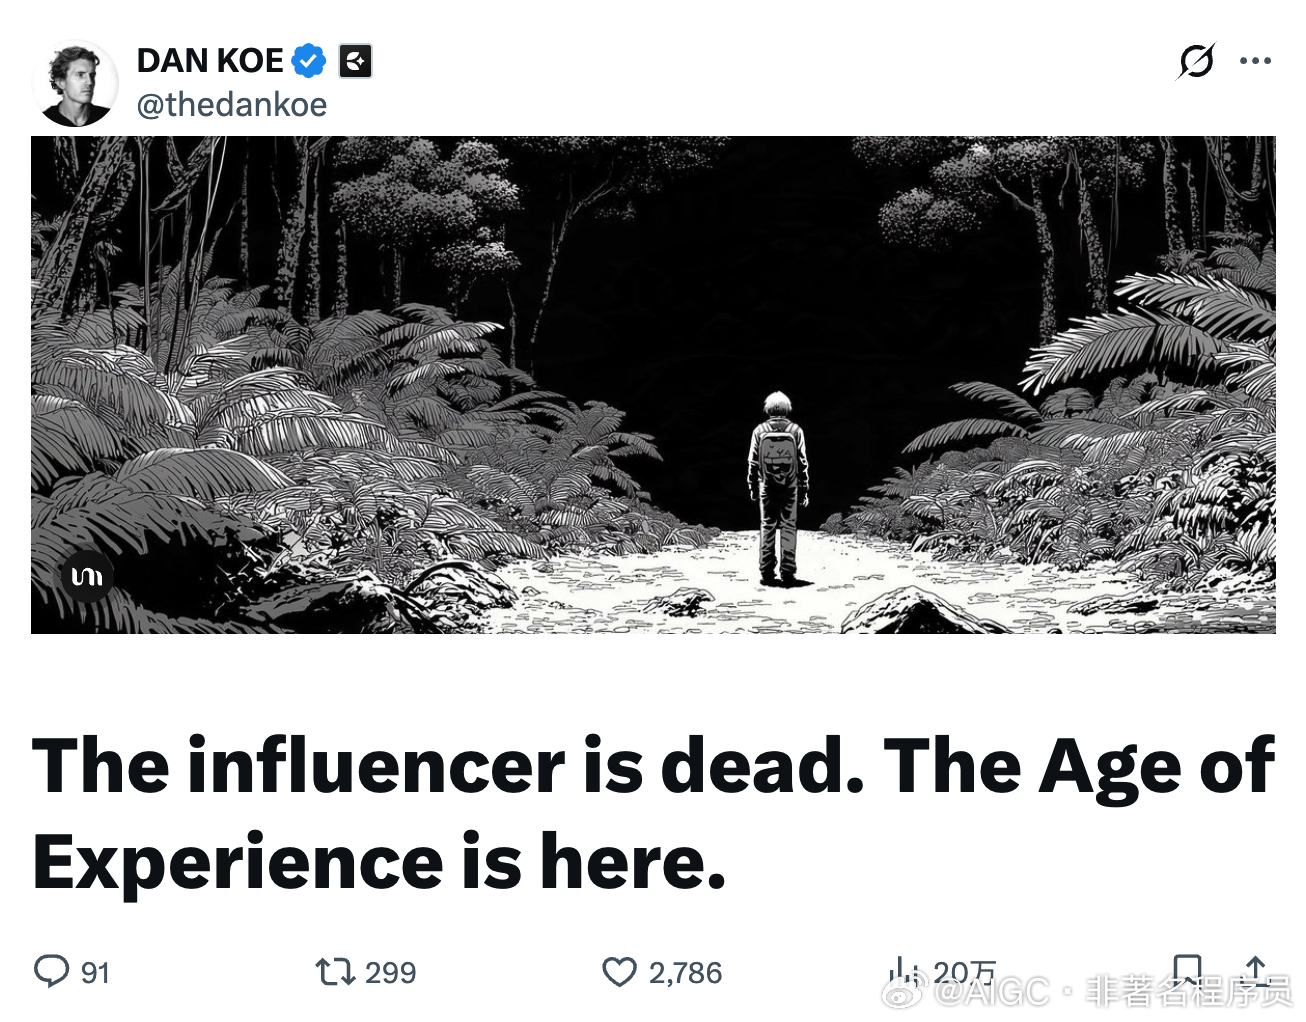
网红已死,匠人时代来了。

国外超级个体,油管百万粉丝大 V  Dan Koe,发了最新的一篇长推文,叫:《网红已死,体验时代来了》。

不知道为什么, 我看完 Dan Koe 写的每一篇文章,都感觉很有道理,有一种魔力,既像鸡汤,又感觉很实用。就是这种感觉。

 Dan Koe 开头就说:现在越来越多四十多岁的普 ​

网红已死,匠人时代来了。 国外超级个体,油管百万粉丝大 V Dan Koe,发了最新的一篇长推文,叫:《网红已死,体验时代来了》。 不知道为什么, 我看完 Dan Koe 写的每一篇文章,都感觉很有道理,有一种魔力,既像鸡汤,又感觉很实用。就是这种感觉。 Dan Koe 开头就说:现在越来越多四十多岁的普 ​

网红已死,匠人时代来了。 国外超级个体,油管百万粉丝大 V Dan Koe,发了最新的一篇长推文,叫:《网红已死,体验时代来了》。 不知道为什么, 我看完 Dan Koe 写的每一篇文章,都感觉很有道理,有一种魔力,既像鸡汤,又感觉很实用。就是这种感觉。 Dan Koe 开头就说:现在越来越多四十多岁的普 ​
DeepSeek 又开源了,但这次开源的东西跟以前不一样。

以前开源的是模型本身,你拿到权重,能跑起来就算成功。但跑起来和跑得好是两回事。一个模型训完之后,怎么让它在几百块 GPU 上同时服务海量用户,怎么把延迟压下来,怎么把吞吐量拉上去,怎么让一块钱的算力干出两块钱的活,这些事情全靠中间那层 ​

DeepSeek 又开源了,但这次开源的东西跟以前不一样。 以前开源的是模型本身,你拿到权重,能跑起来就算成功。但跑起来和跑得好是两回事。一个模型训完之后,怎么让它在几百块 GPU 上同时服务海量用户,怎么把延迟压下来,怎么把吞吐量拉上去,怎么让一块钱的算力干出两块钱的活,这些事情全靠中间那层 ​

DeepSeek 又开源了,但这次开源的东西跟以前不一样。 以前开源的是模型本身,你拿到权重,能跑起来就算成功。但跑起来和跑得好是两回事。一个模型训完之后,怎么让它在几百块 GPU 上同时服务海量用户,怎么把延迟压下来,怎么把吞吐量拉上去,怎么让一块钱的算力干出两块钱的活,这些事情全靠中间那层 ​
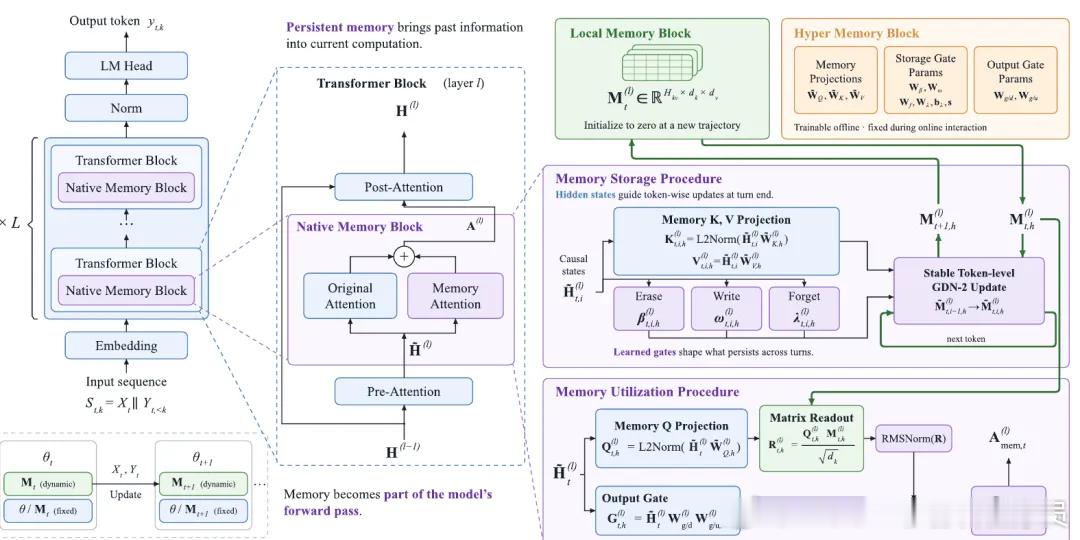
# 让模型真正拥有记忆:MemT 1.0 

最近看到一个很有意思的记忆项目,叫 MemT 1.0,是记忆张量团队做的。

看完他们的技术报告之后,我觉得这个思路值得好好聊一聊。

## 一、现在的模型记忆,全靠外挂

我们平时说的“模型有记忆了”,仔细想想,都是在往上下文窗口里塞文本。

你写的提示词是文本,

# 让模型真正拥有记忆:MemT 1.0 最近看到一个很有意思的记忆项目,叫 MemT 1.0,是记忆张量团队做的。 看完他们的技术报告之后,我觉得这个思路值得好好聊一聊。 ## 一、现在的模型记忆,全靠外挂 我们平时说的“模型有记忆了”,仔细想想,都是在往上下文窗口里塞文本。 你写的提示词是文本,

# 让模型真正拥有记忆:MemT 1.0 最近看到一个很有意思的记忆项目,叫 MemT 1.0,是记忆张量团队做的。 看完他们的技术报告之后,我觉得这个思路值得好好聊一聊。 ## 一、现在的模型记忆,全靠外挂 我们平时说的“模型有记忆了”,仔细想想,都是在往上下文窗口里塞文本。 你写的提示词是文本,
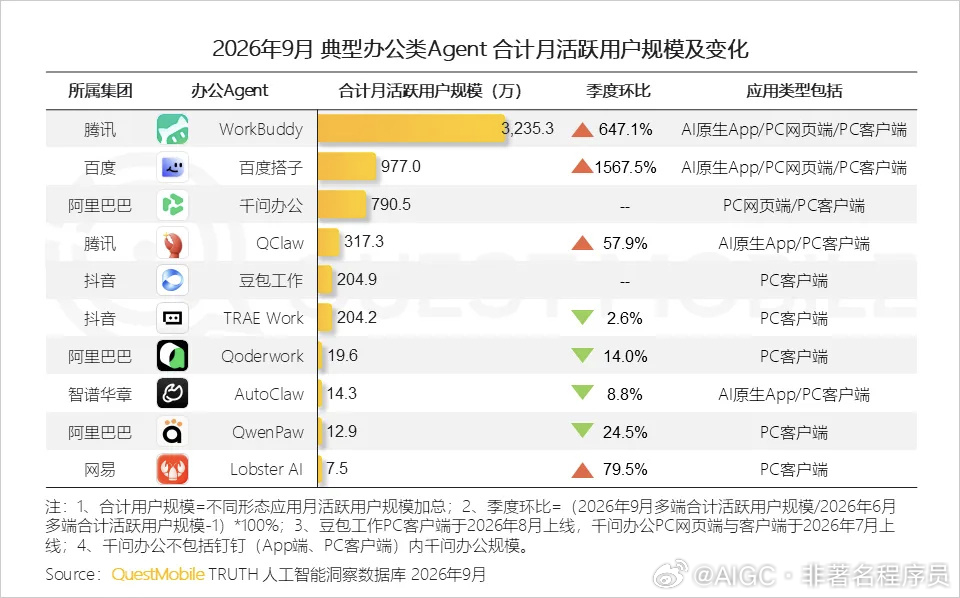
QuestMobile 出了一份 2026 年 9 月的办公类 AI Agent 月活数据,看完之后有几个数字挺让人意外的。

第一梯队就三家。腾讯的 WorkBuddy 月活 3235 万,排第一,季度环比涨了 647%。百度搭子排第二,月活 977 万,但它的增速最猛,季度环比涨了 1567%,一个季度翻了十五六倍。百度搭子在两个月应该是在 ​

QuestMobile 出了一份 2026 年 9 月的办公类 AI Agent 月活数据,看完之后有几个数字挺让人意外的。 第一梯队就三家。腾讯的 WorkBuddy 月活 3235 万,排第一,季度环比涨了 647%。百度搭子排第二,月活 977 万,但它的增速最猛,季度环比涨了 1567%,一个季度翻了十五六倍。百度搭子在两个月应该是在 ​

QuestMobile 出了一份 2026 年 9 月的办公类 AI Agent 月活数据,看完之后有几个数字挺让人意外的。 第一梯队就三家。腾讯的 WorkBuddy 月活 3235 万,排第一,季度环比涨了 647%。百度搭子排第二,月活 977 万,但它的增速最猛,季度环比涨了 1567%,一个季度翻了十五六倍。百度搭子在两个月应该是在 ​
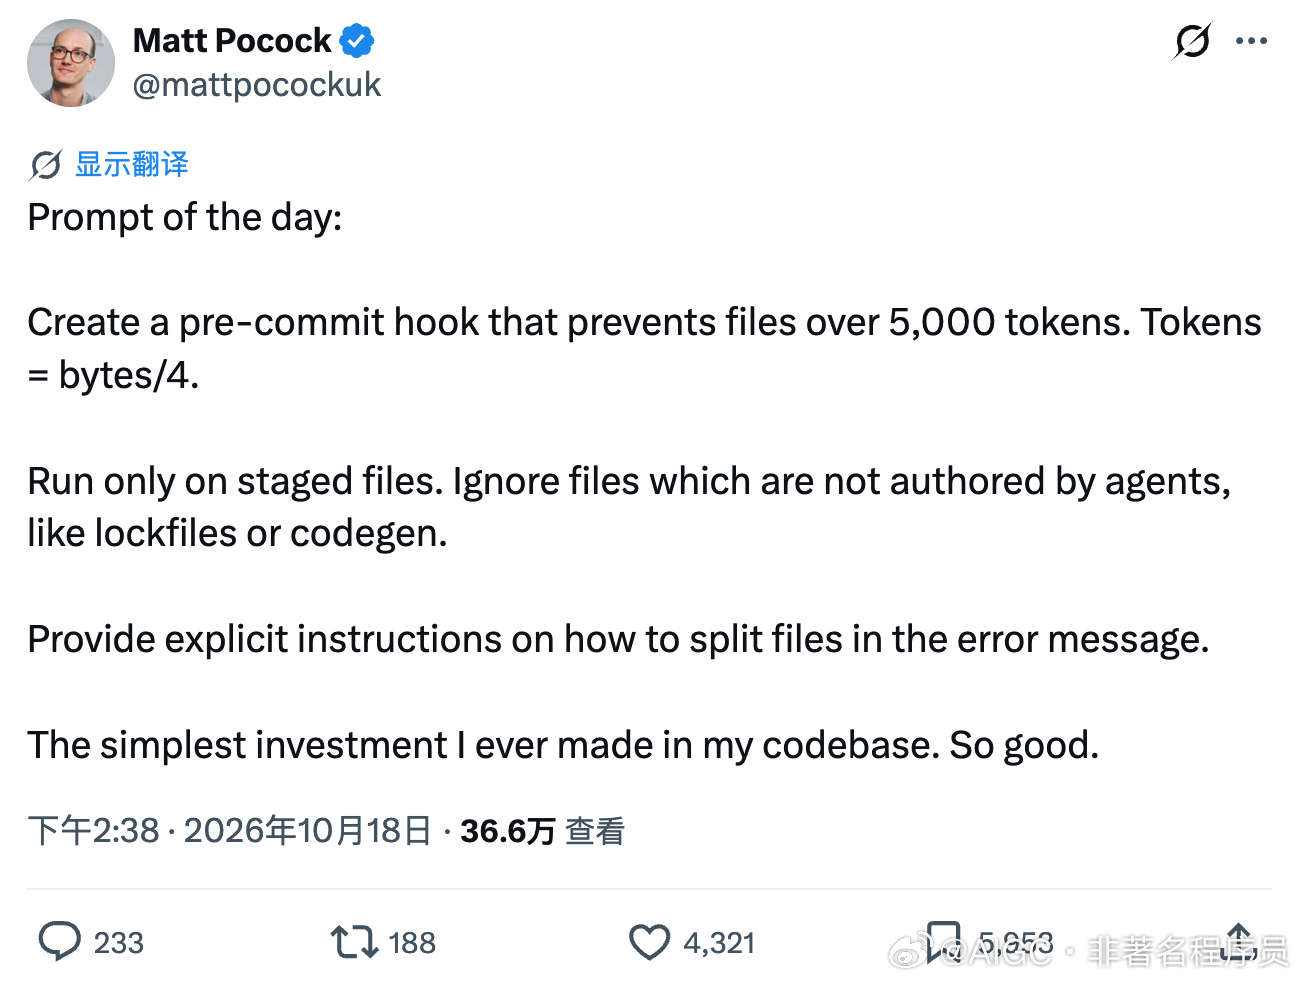
Total TypeScript 和 AI Hero 的作者 Matt Pocock 分享了一个他觉得特别值的小操作:让 Agent 写一个 pre-commit hook,任何代码文件超过 5000 token 就拦下来,不让你提交。

这个 hook 的设计挺细的。

第一点,它只检查你准备提交的文件,不会扫整个项目。然后第二点,lockfile 和自动生成的代码直 ​

Total TypeScript 和 AI Hero 的作者 Matt Pocock 分享了一个他觉得特别值的小操作:让 Agent 写一个 pre-commit hook,任何代码文件超过 5000 token 就拦下来,不让你提交。 这个 hook 的设计挺细的。 第一点,它只检查你准备提交的文件,不会扫整个项目。然后第二点,lockfile 和自动生成的代码直 ​

Total TypeScript 和 AI Hero 的作者 Matt Pocock 分享了一个他觉得特别值的小操作:让 Agent 写一个 pre-commit hook,任何代码文件超过 5000 token 就拦下来,不让你提交。 这个 hook 的设计挺细的。 第一点,它只检查你准备提交的文件,不会扫整个项目。然后第二点,lockfile 和自动生成的代码直 ​
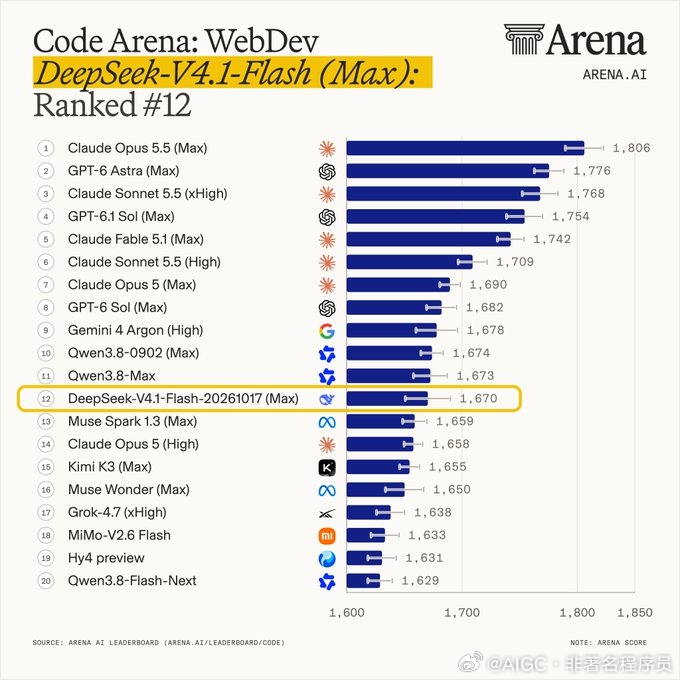
Agent Arena 发文称:最新发布的 V4.1-Flash-20261017(Max 模式),拿下了开源模型第一名,总榜排到了第 11 位。这个排名是怎么测出来的呢?Arena.ai 用了超过 7500 个真实场景去跑,最终这个模型的综合表现比之前提升了 5.1%。

排在它前面的那些模型,全是闭源的,而且贵得多。V4.1-Flash 跑一个任 ​

Agent Arena 发文称:最新发布的 V4.1-Flash-20261017(Max 模式),拿下了开源模型第一名,总榜排到了第 11 位。这个排名是怎么测出来的呢?Arena.ai 用了超过 7500 个真实场景去跑,最终这个模型的综合表现比之前提升了 5.1%。 排在它前面的那些模型,全是闭源的,而且贵得多。V4.1-Flash 跑一个任 ​

Agent Arena 发文称:最新发布的 V4.1-Flash-20261017(Max 模式),拿下了开源模型第一名,总榜排到了第 11 位。这个排名是怎么测出来的呢?Arena.ai 用了超过 7500 个真实场景去跑,最终这个模型的综合表现比之前提升了 5.1%。 排在它前面的那些模型,全是闭源的,而且贵得多。V4.1-Flash 跑一个任 ​
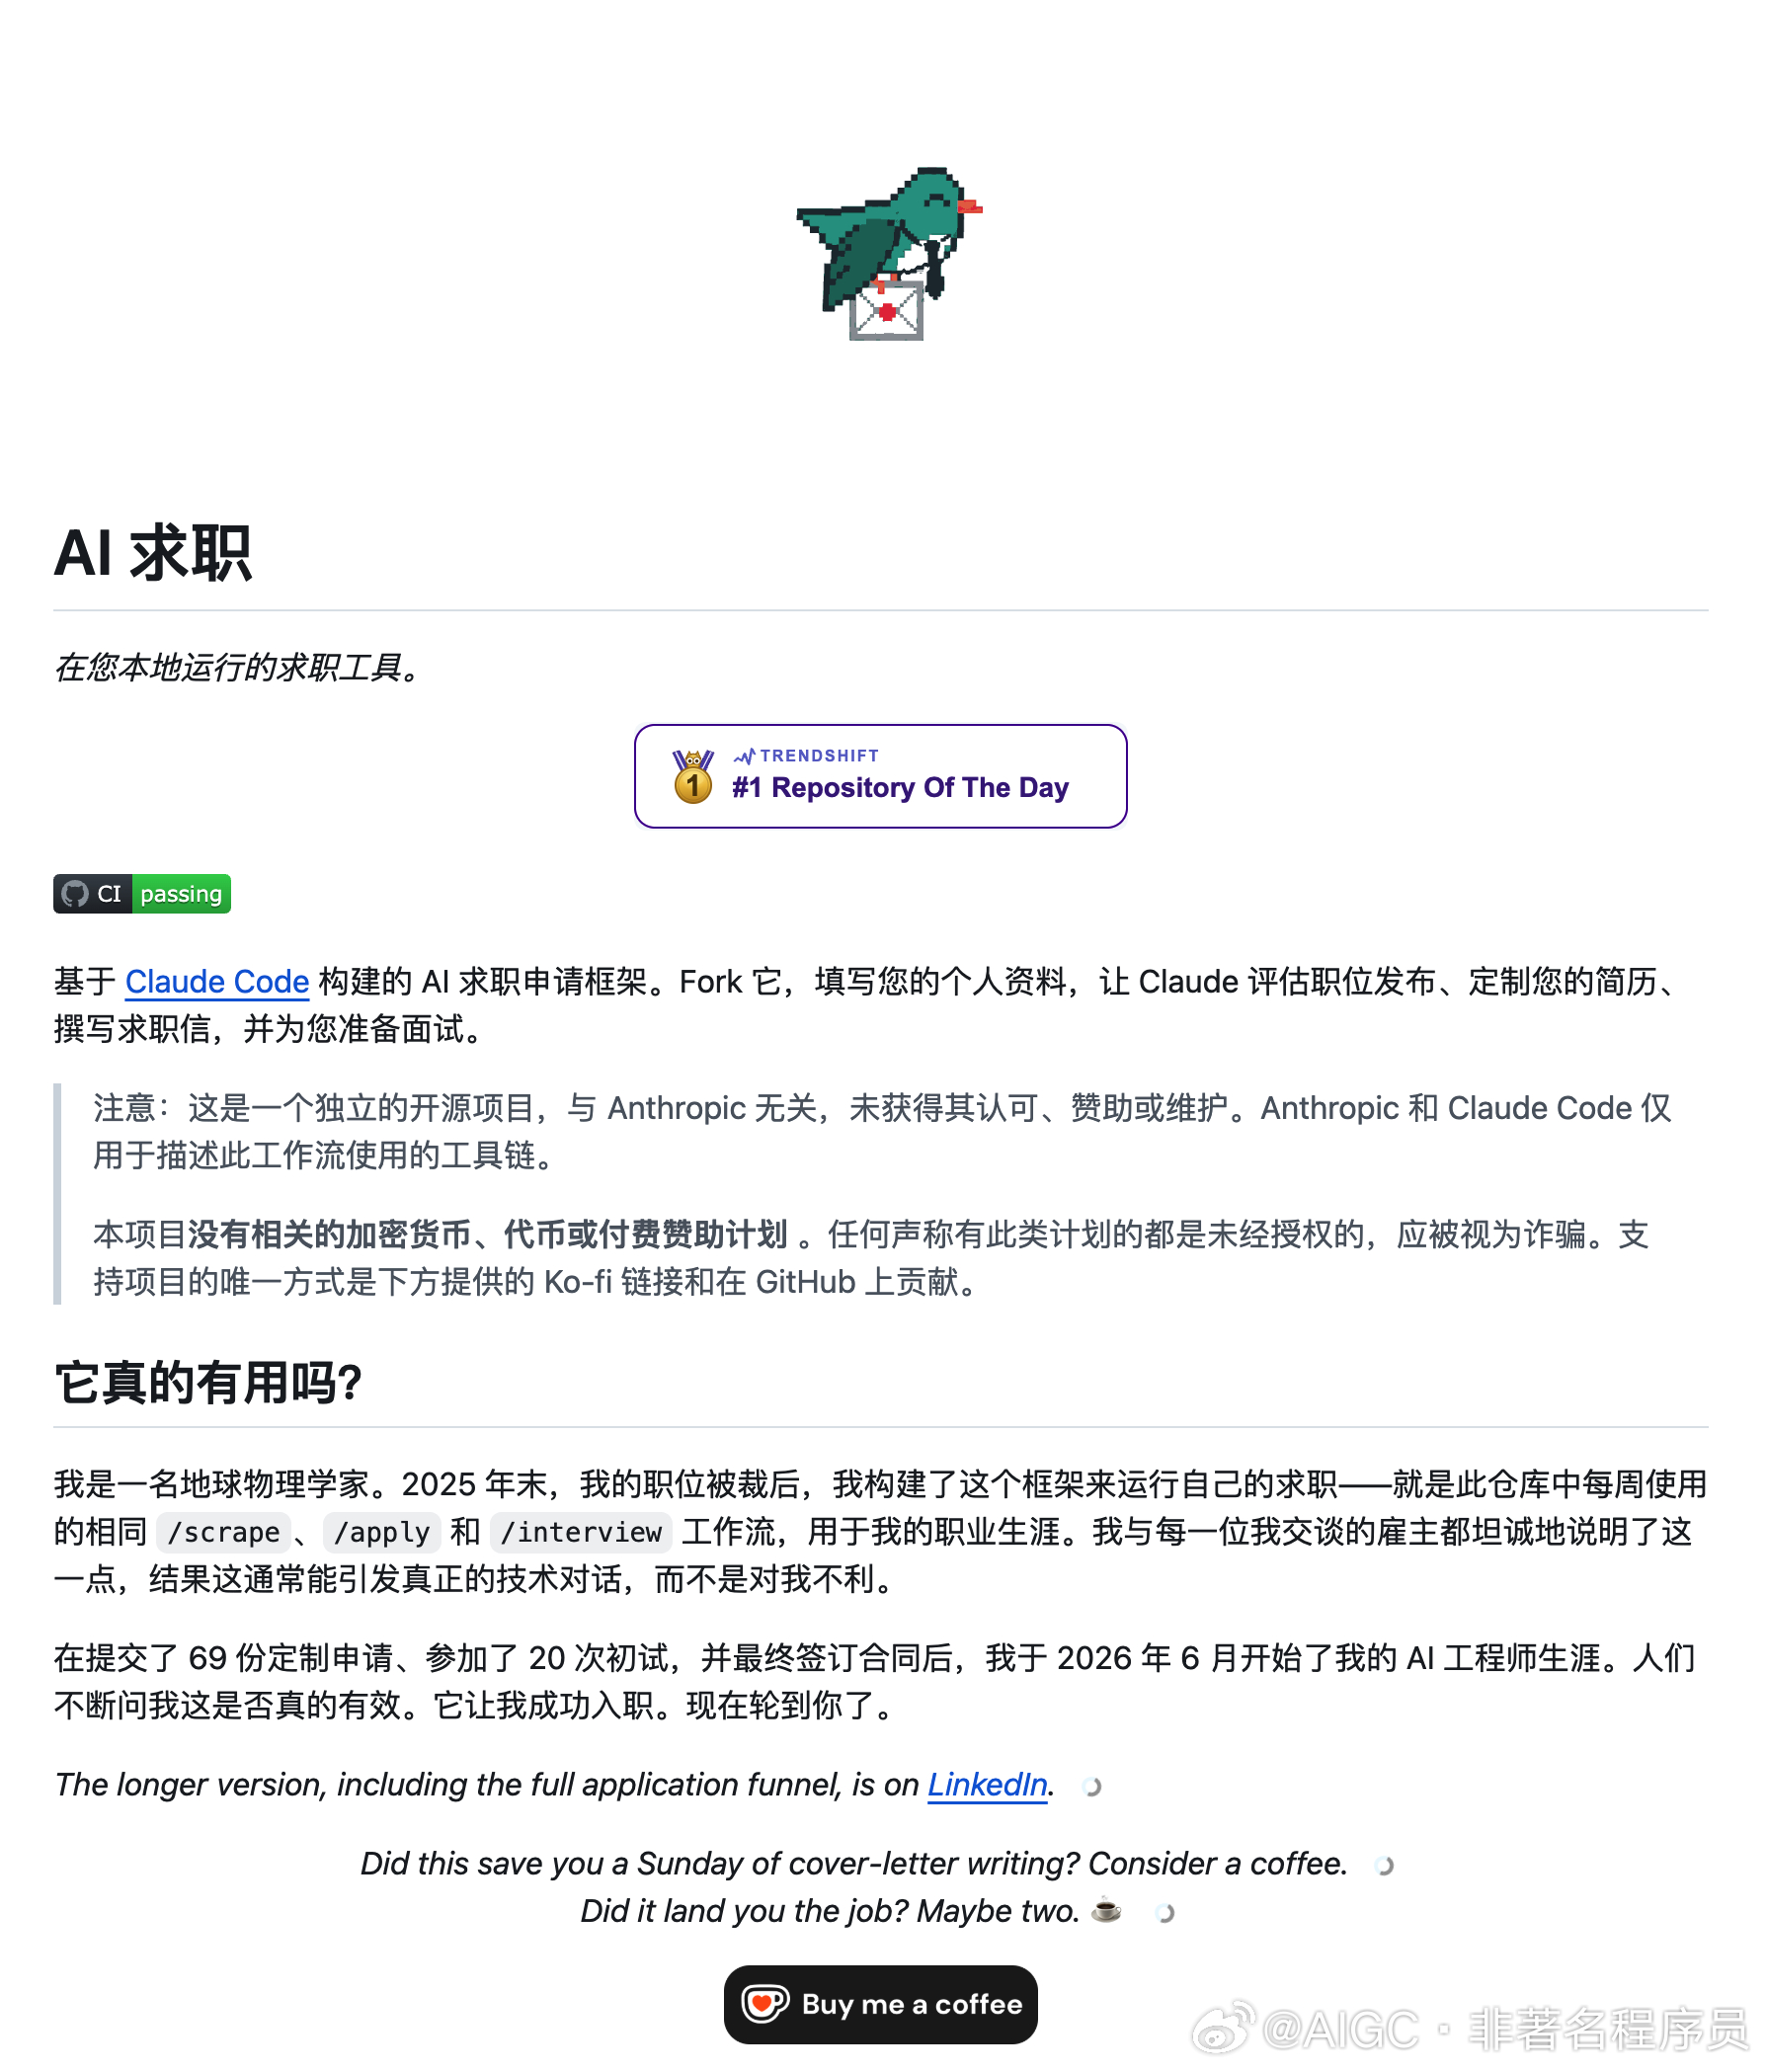
一个可以帮你找工作的开源工具,我感觉超级赞,能够让你做到定制化的求职。

一个地球物理学家,2025 年底被裁了。

丢了工作之后,他干了一件事:自己写了一套 AI 求职工具。这个工具跑在 Claude Code 上面,能帮你搜职位、评估匹配度、定制简历、写求职信,还能帮你准备面试。

他拿这套工具跑了自己 ​

一个可以帮你找工作的开源工具,我感觉超级赞,能够让你做到定制化的求职。 一个地球物理学家,2025 年底被裁了。 丢了工作之后,他干了一件事:自己写了一套 AI 求职工具。这个工具跑在 Claude Code 上面,能帮你搜职位、评估匹配度、定制简历、写求职信,还能帮你准备面试。 他拿这套工具跑了自己 ​

一个可以帮你找工作的开源工具,我感觉超级赞,能够让你做到定制化的求职。 一个地球物理学家,2025 年底被裁了。 丢了工作之后,他干了一件事:自己写了一套 AI 求职工具。这个工具跑在 Claude Code 上面,能帮你搜职位、评估匹配度、定制简历、写求职信,还能帮你准备面试。 他拿这套工具跑了自己 ​
软件背后,应该站着人。

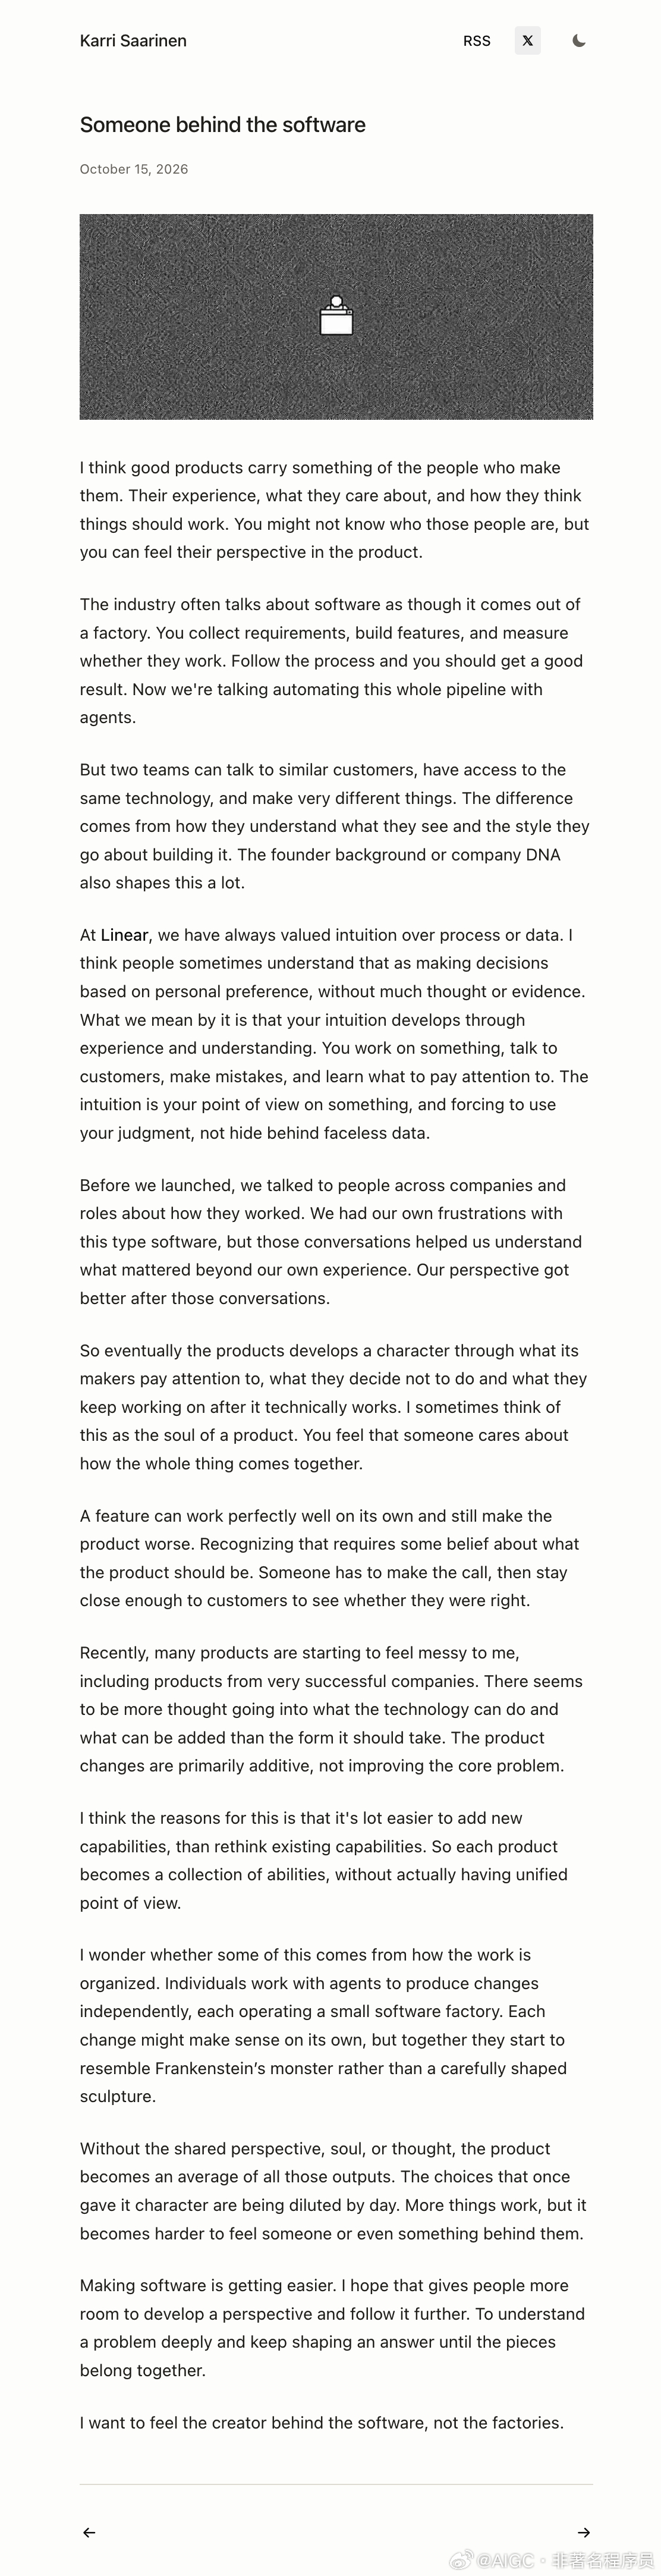
最近看到 Linear 创始人写了一篇文章,聊了一个话题:你用一个软件的时候,能不能感觉到背后有个“人”在?

他说好的产品里面,你能感受到做它的人的想法,他们在乎什么,怎么看问题。你可能不认识他们,但用着用着就能体会到。

这个行业习惯把做软件当流水线,收集需求,开 ​

软件背后,应该站着人。 最近看到 Linear 创始人写了一篇文章,聊了一个话题:你用一个软件的时候,能不能感觉到背后有个“人”在? 他说好的产品里面,你能感受到做它的人的想法,他们在乎什么,怎么看问题。你可能不认识他们,但用着用着就能体会到。 这个行业习惯把做软件当流水线,收集需求,开 ​

软件背后,应该站着人。 最近看到 Linear 创始人写了一篇文章,聊了一个话题:你用一个软件的时候,能不能感觉到背后有个“人”在? 他说好的产品里面,你能感受到做它的人的想法,他们在乎什么,怎么看问题。你可能不认识他们,但用着用着就能体会到。 这个行业习惯把做软件当流水线,收集需求,开 ​