训练万亿参数大模型,过去得靠几万张卡硬堆。华为这次说,可以把它"当一台计算机"来用。
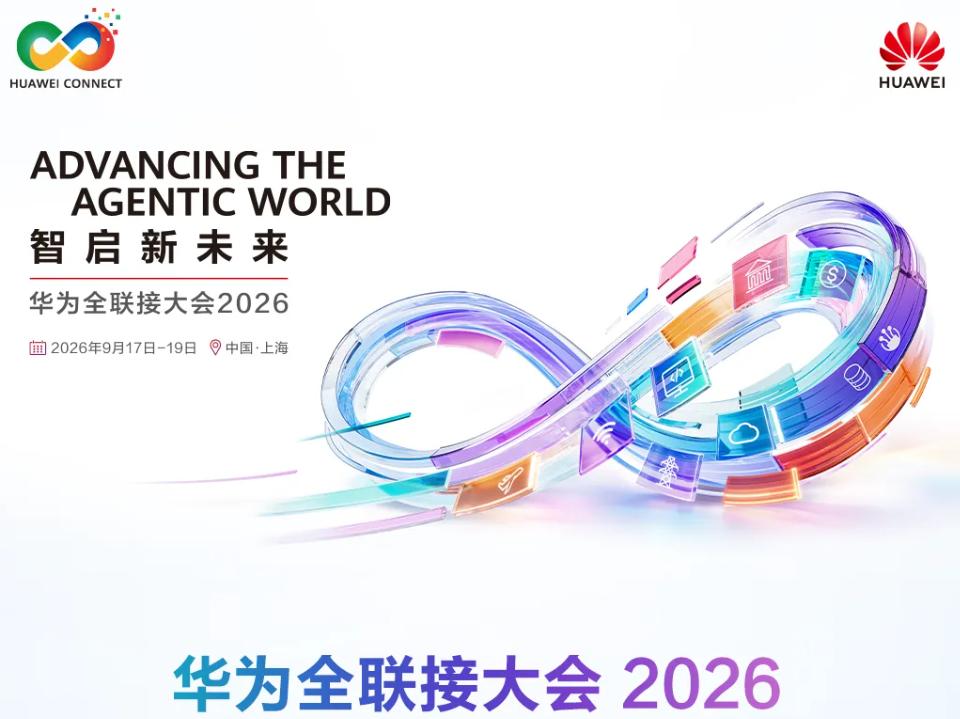
9 月 17 日华为全联接大会,轮值董事长汪涛发布昇腾 960 超节点,支持十万亿参数级训练推理,能扩到 4096 卡;同步提 Peerium 架构,号称让百万级处理器协同成一台机器。
翻译成人话——以前多个智算中心各算各的,像一群人隔墙喊话;现在华为想打通成同一个大脑,任务调度不用反复搬数据,训练等待和电费都往下掉。对用国产算力的公司,等于同样预算能跑更大的模型。
值不值得吹?华为自己说产能连国内需求都喂不饱,暂不全面出海。这是国产算力从"能用"往"好用"挤的一步,但和英伟达顶层集群的代差还在。昇腾 960DT 提前到 2027 一季度、性能翻番,970/980 排到 28/29 年,路线图清楚;可端侧和训练是两码事,真落地还得看软件生态跟不跟得上。
国产算力这口气,是真心追上还是账面漂亮?你更看重纸面参数,还是实际能跑通?