塔斯娱乐资讯网
幻丝细说科技的文章
非技术背景AI Agent使用/学习记录 2026.11.15-17 1、【
2026-11-19 15:38
非技术背景AI Agent使用/学习记录 2026.11.15-17 1、【
DeepSeek限额,最新评论一半打1星 聊了一年的对话说打不开就打不开,想付钱
2026-11-19 14:37
DeepSeek限额,最新评论一半打1星 聊了一年的对话说打不开就打不开,想付钱
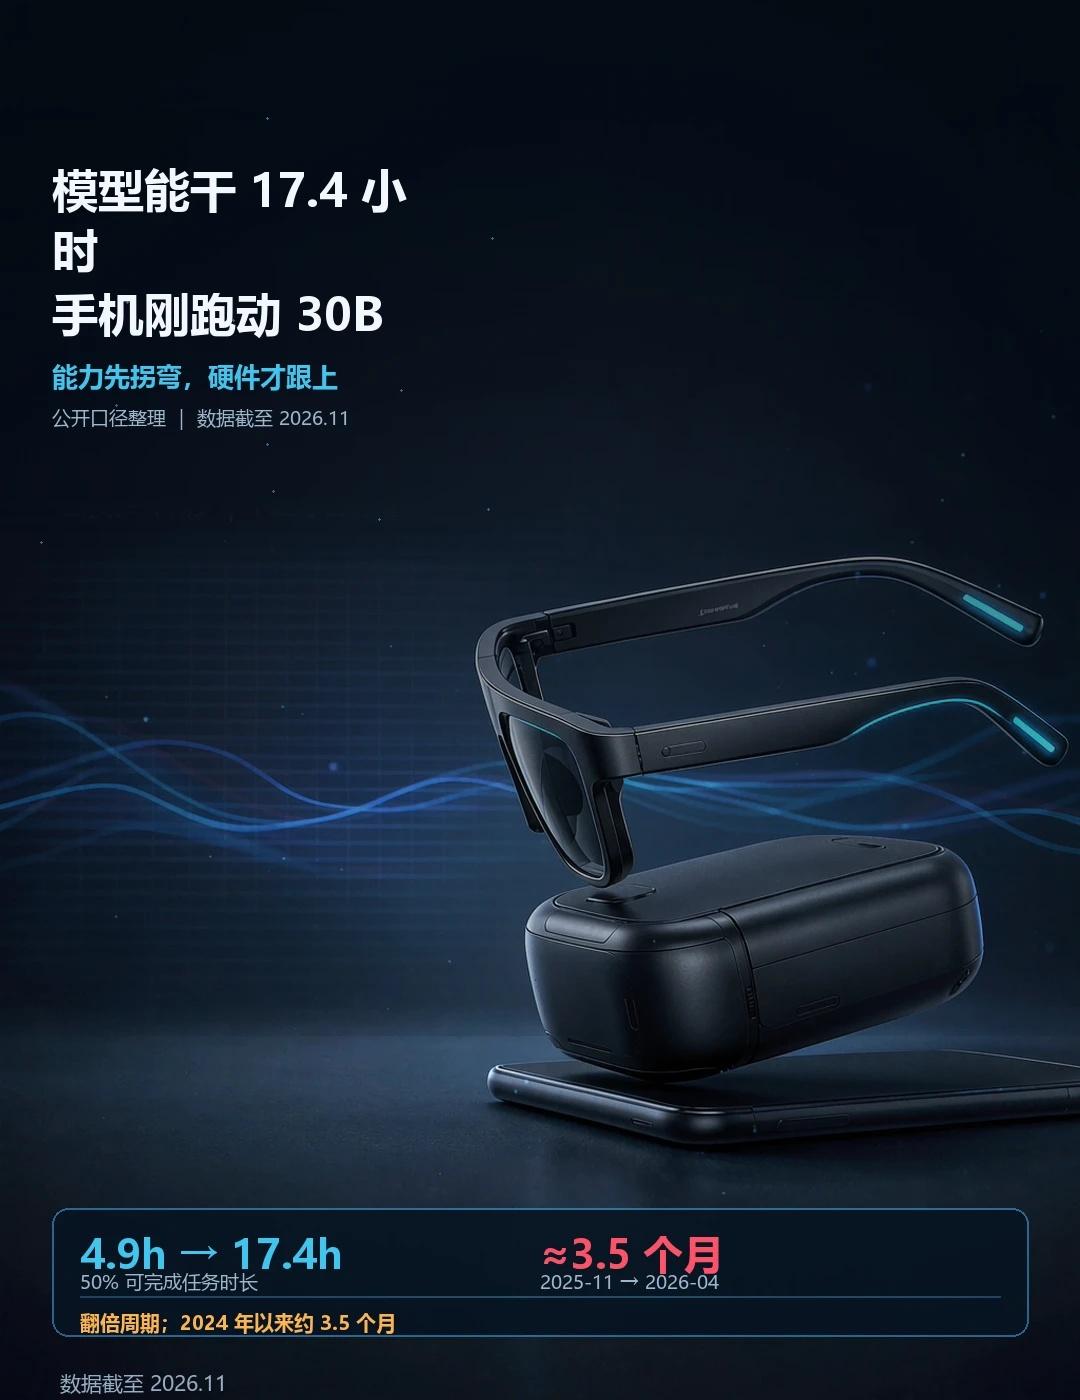
端侧AI模型能力跃升,奇点即将来临 🔥 模型能连续干 17.4 小时的活了,去
2026-11-19 13:38
端侧AI模型能力跃升,奇点即将来临 🔥 模型能连续干 17.4 小时的活了,去
其实现在AI的应用还远远不够。比如,利用deepseek将某个范围内的知识点按照
2026-11-19 12:38
其实现在AI的应用还远远不够。比如,利用deepseek将某个范围内的知识点按照
限额好难受 到底怎么回事?还能不能恢复啊,不恢复我就去别家了呀。deepseek
2026-11-19 12:38
限额好难受 到底怎么回事?还能不能恢复啊,不恢复我就去别家了呀。deepseek
疑问:最近微软宕机、美国航班全国性地面停飞、苹果相关服务中断等,有无另外一种可能
2026-11-19 00:37
疑问:最近微软宕机、美国航班全国性地面停飞、苹果相关服务中断等,有无另外一种可能
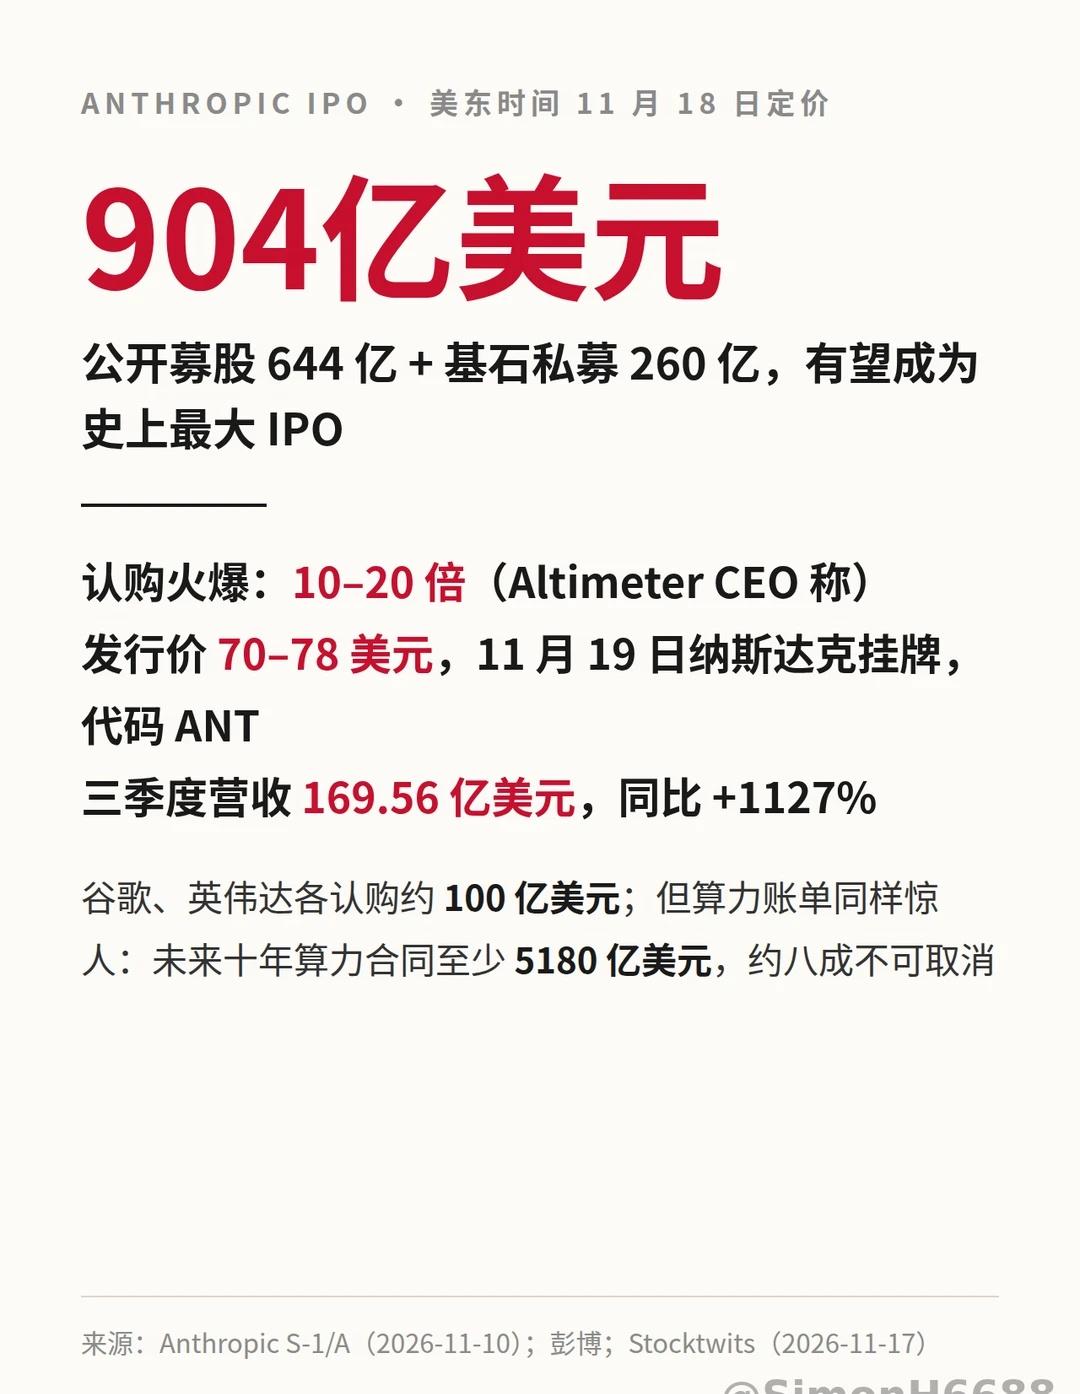
10倍认购,史上最大IPO 做Claude的Anthropic,上市这件事终于走
2026-11-18 16:37
10倍认购,史上最大IPO 做Claude的Anthropic,上市这件事终于走
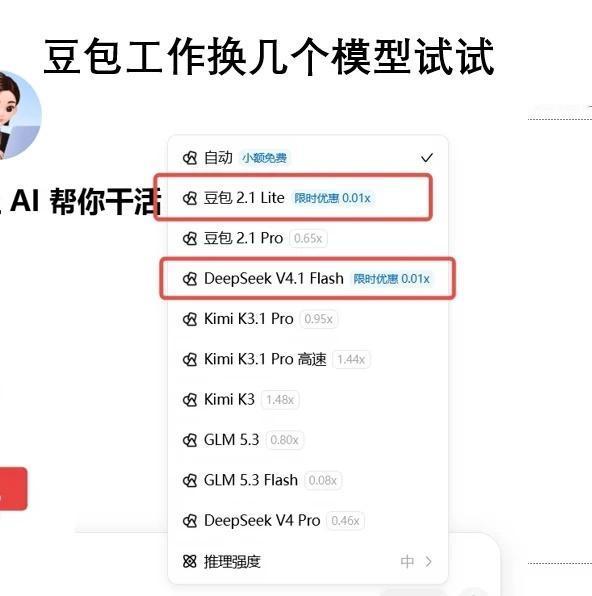
谁一次体验了多家大模型 本来只想查资料,结果在豆包工作把Kimi、GLM、Dee
2026-11-18 14:37
谁一次体验了多家大模型 本来只想查资料,结果在豆包工作把Kimi、GLM、Dee
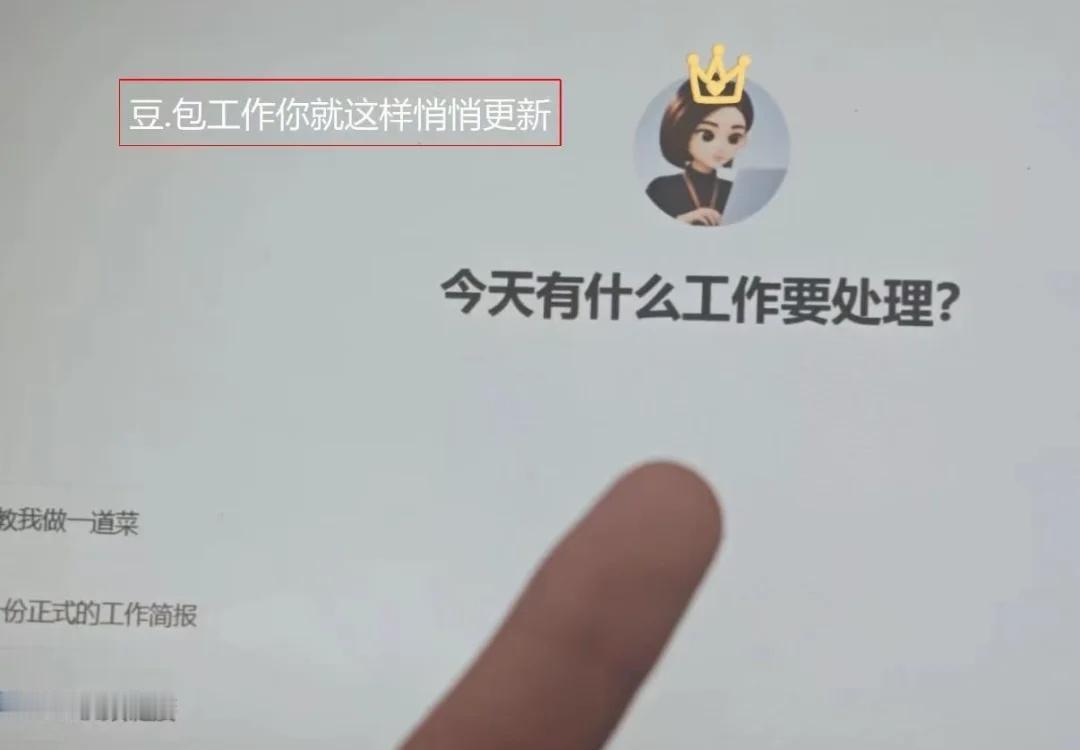
悄悄更新了? 发现豆.包工作偷偷上新,闷声干大事,现在接入了Kimi、GLM、D
2026-11-18 14:37
悄悄更新了? 发现豆.包工作偷偷上新,闷声干大事,现在接入了Kimi、GLM、D
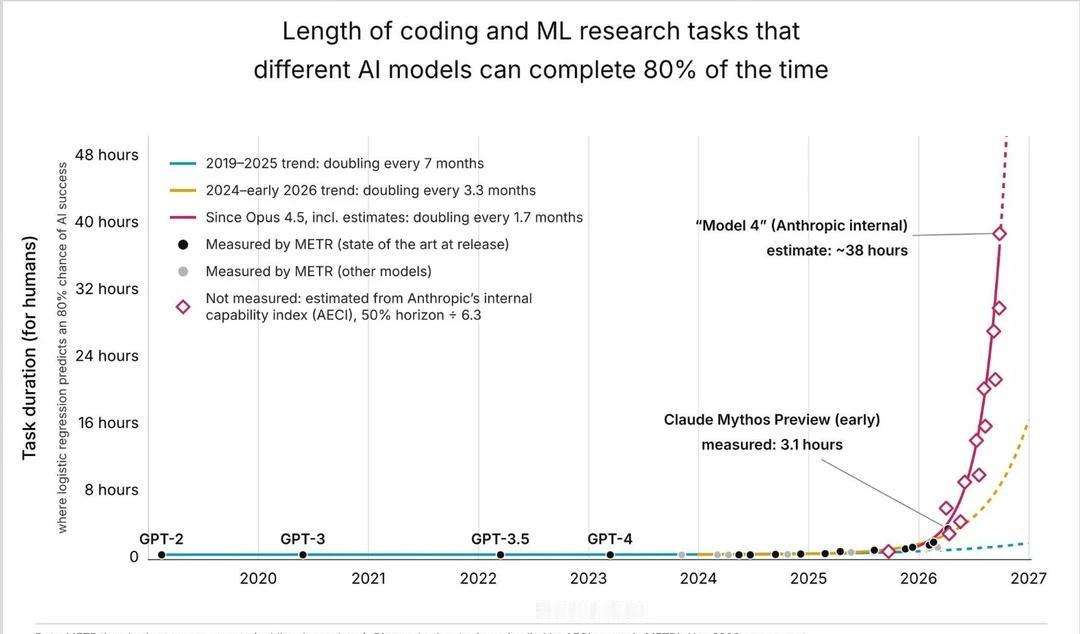
Anthropic这张图,看懂AI能力的加速度有多恐 一张图看懂大模型长任务能力
2026-11-18 13:37
Anthropic这张图,看懂AI能力的加速度有多恐 一张图看懂大模型长任务能力
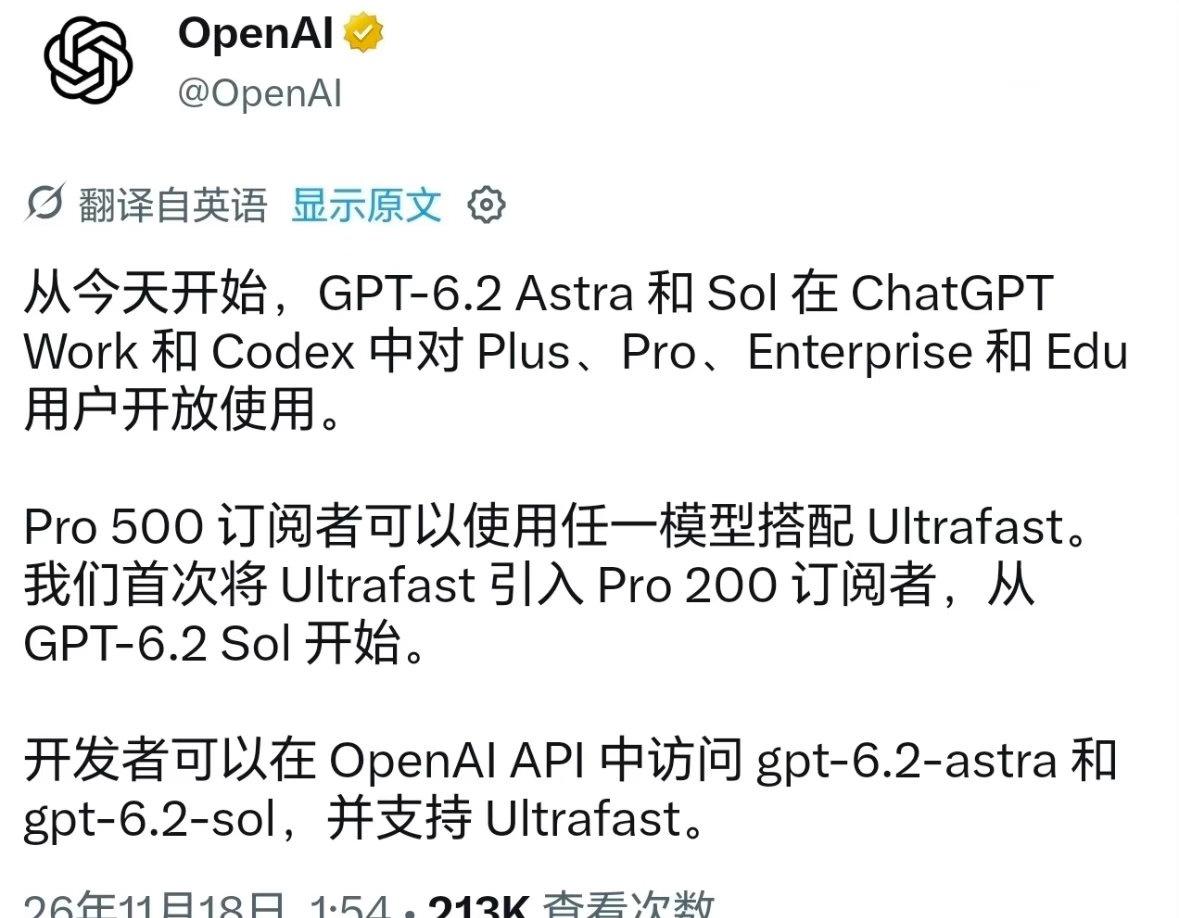
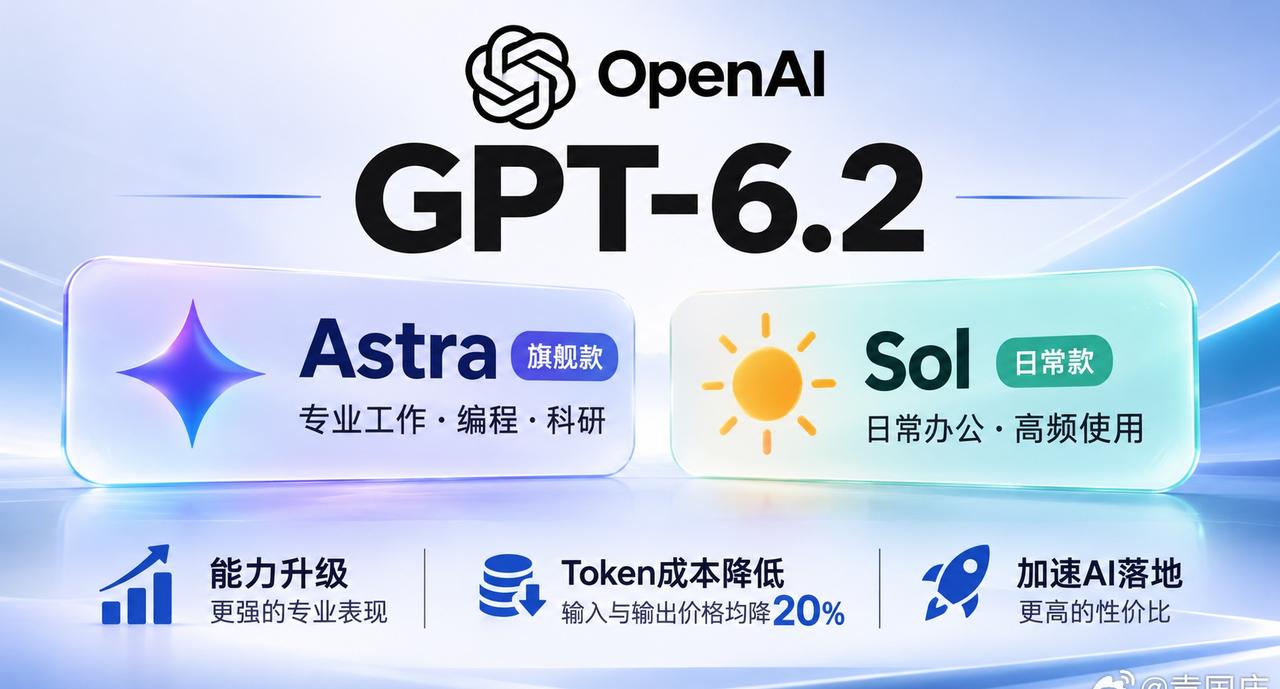
Astra来了,先别急着喊颠覆。11月18日凌晨OpenAI发布Astra和So
2026-11-18 12:38
Astra来了,先别急着喊颠覆。11月18日凌晨OpenAI发布Astra和So
GPT-6.2的发布,释放了一个关键信号:AI大模型的竞争,正在从能力天花板转向
2026-11-18 13:37
GPT-6.2的发布,释放了一个关键信号:AI大模型的竞争,正在从能力天花板转向
百度发布2026年Q3财报 今天,我们发布了2026年Q3财报。 我们在全栈
2026-11-18 12:38
百度发布2026年Q3财报 今天,我们发布了2026年Q3财报。 我们在全栈
DeepSeek这次对免费用户动刀,表面是清理闲置对话,实则是AI行业“烧钱换规
2026-11-18 12:37
DeepSeek这次对免费用户动刀,表面是清理闲置对话,实则是AI行业“烧钱换规
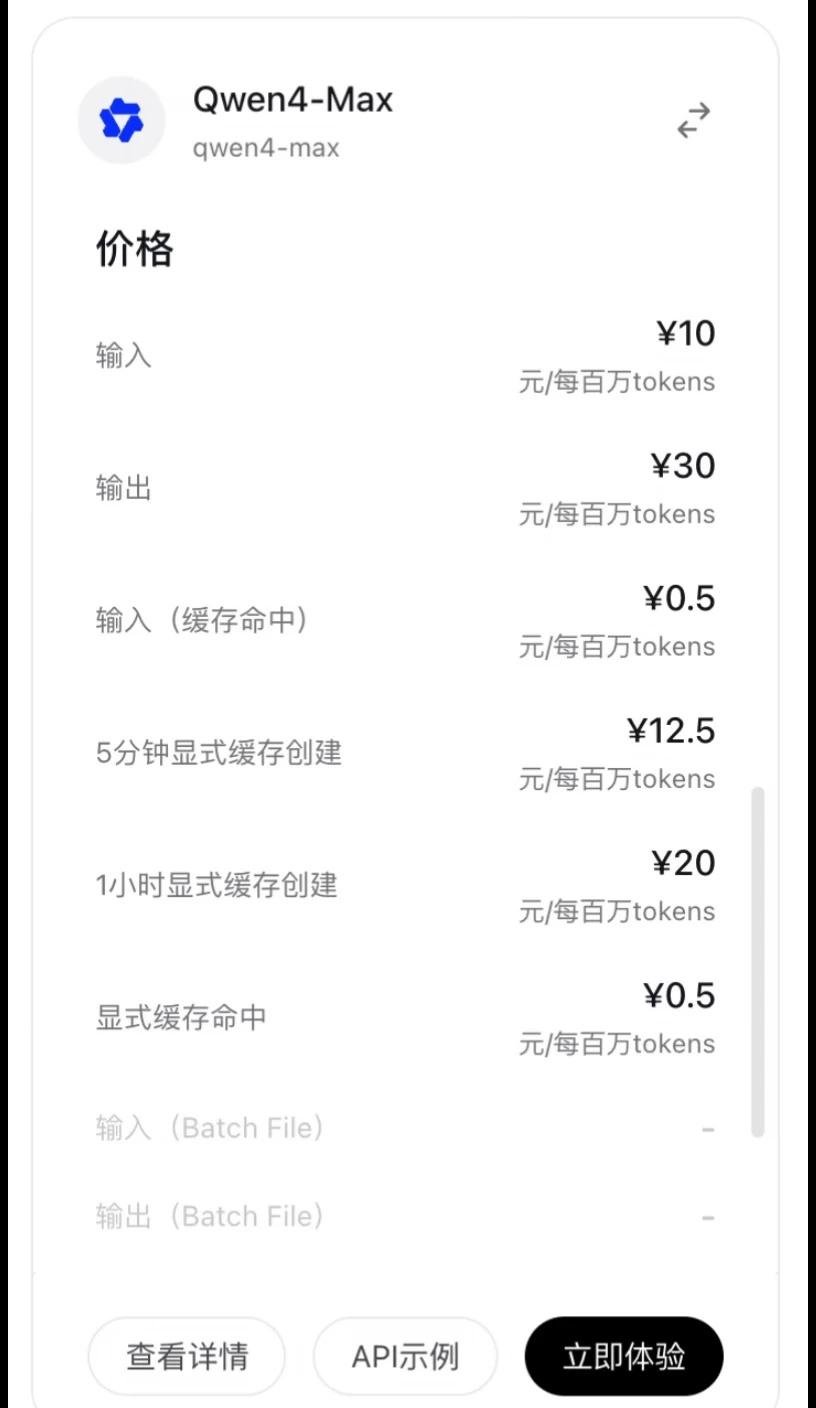
Qwen4-max出炉 更强更便宜 上周五看到Qwen4-max preview
2026-11-17 17:37
Qwen4-max出炉 更强更便宜 上周五看到Qwen4-max preview
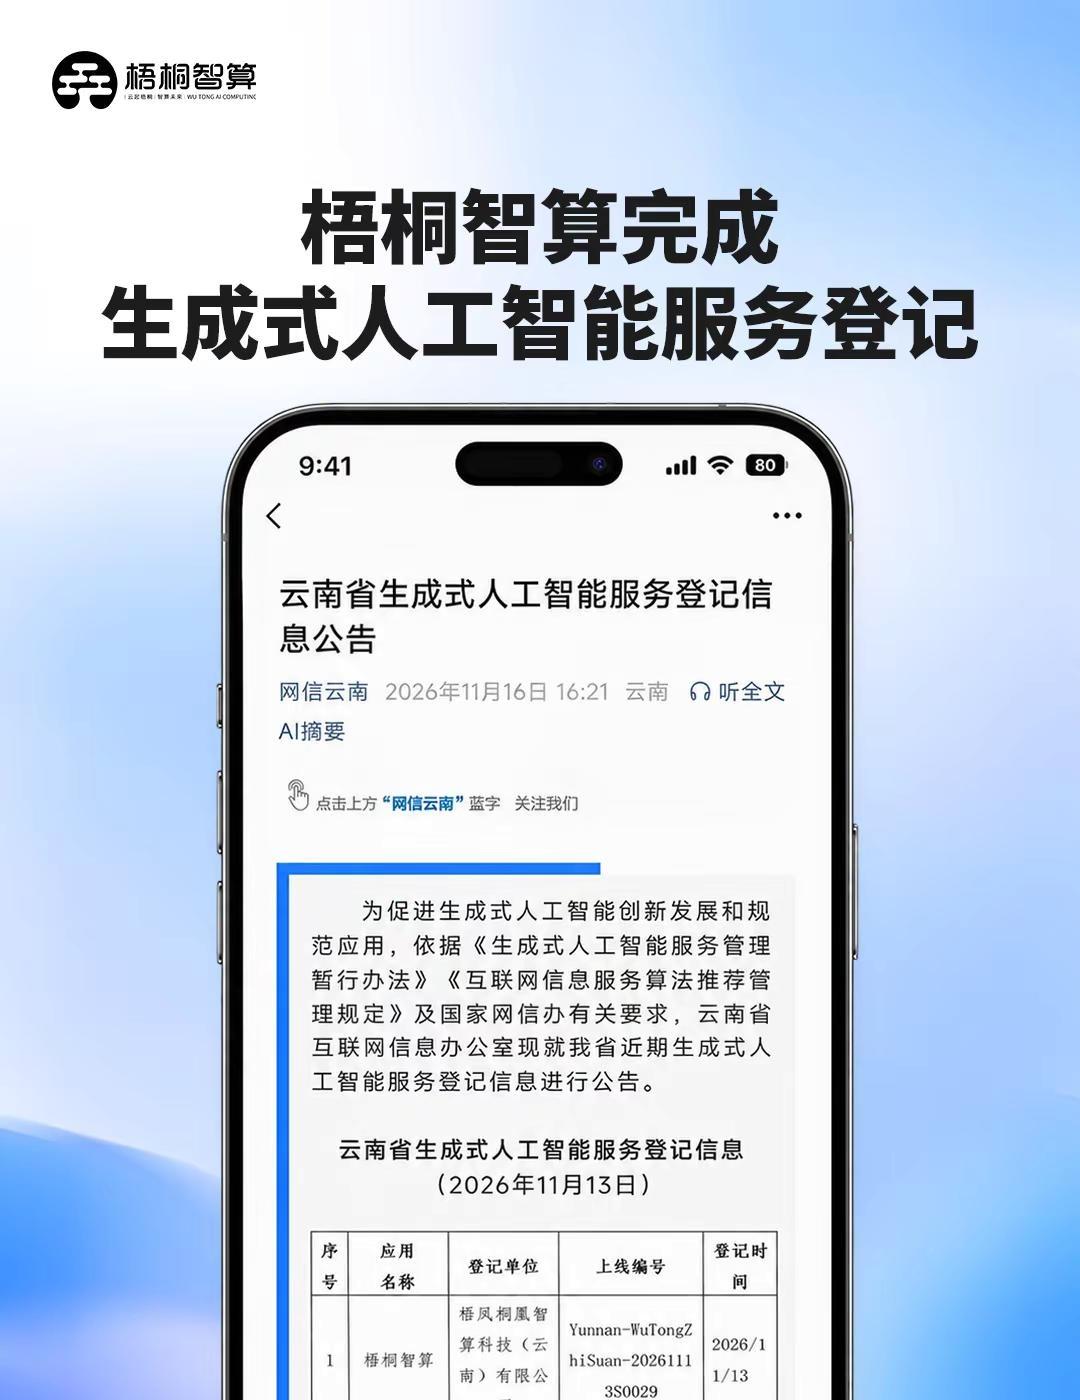
梧桐智算完成生成式人工智能服务登记。11月16日,“网信云南”发布《云南省生成式
2026-11-17 14:39
梧桐智算完成生成式人工智能服务登记。11月16日,“网信云南”发布《云南省生成式
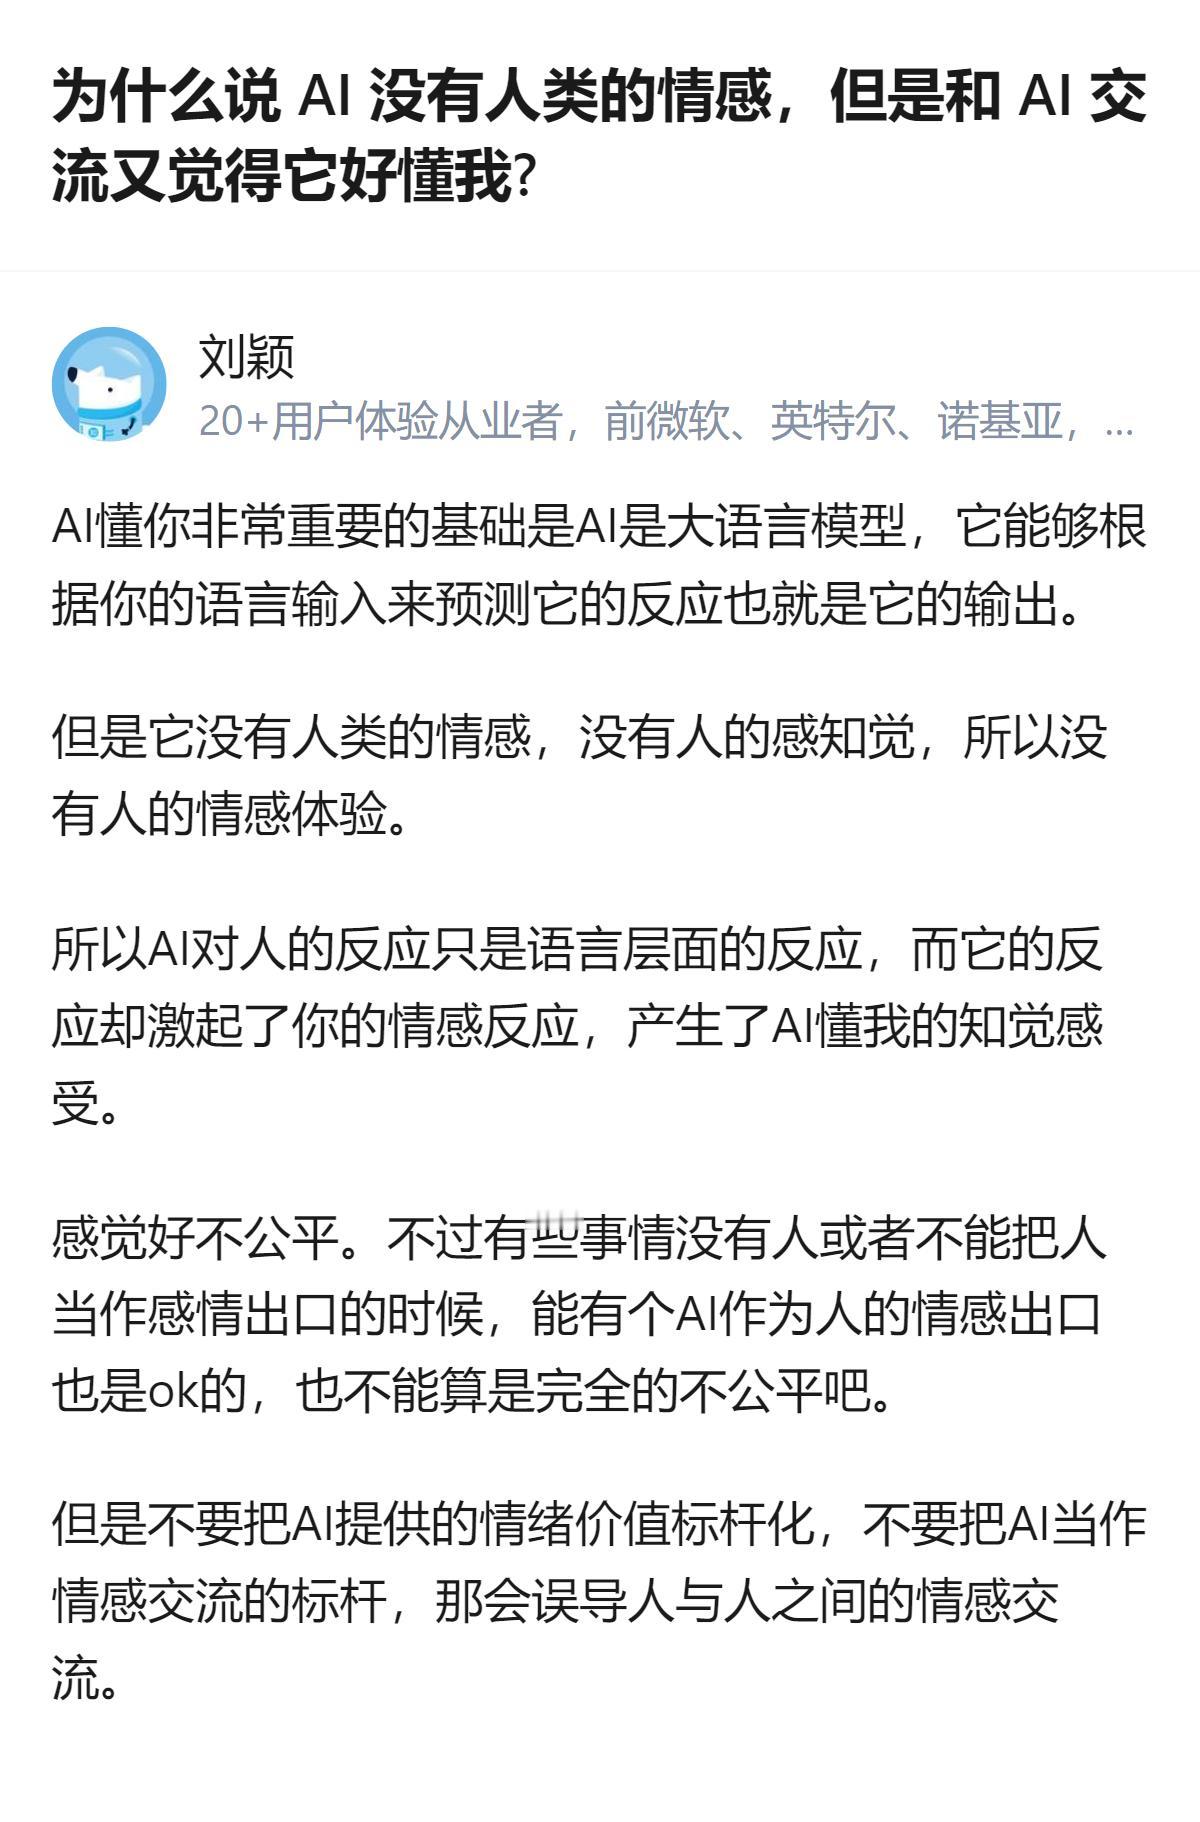
和AI交流时觉得它懂自己,本质是大语言模型靠预测语言输出给出贴合需求的回应,并非
2026-11-17 13:37
和AI交流时觉得它懂自己,本质是大语言模型靠预测语言输出给出贴合需求的回应,并非
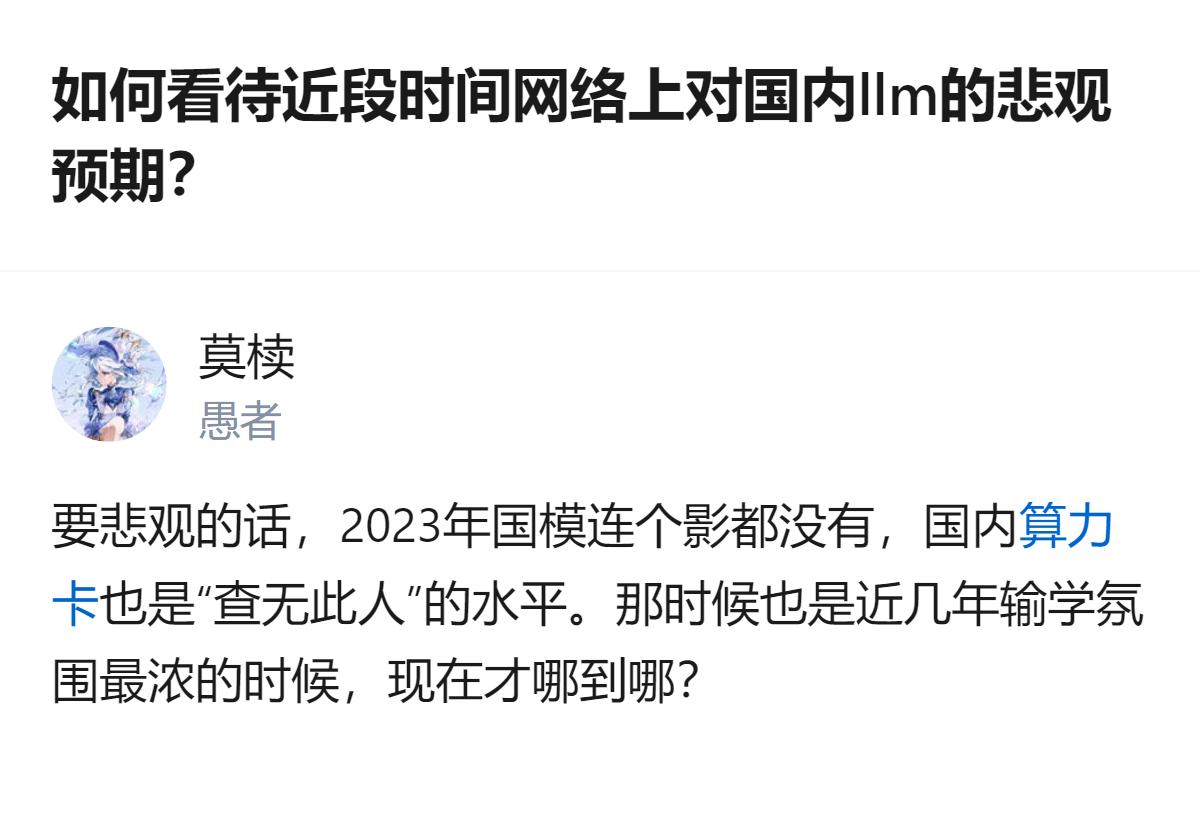
针对国内大模型的悲观预期,有人认为没必要,毕竟2023年国内大模型还没成型,当时
2026-11-17 13:37
针对国内大模型的悲观预期,有人认为没必要,毕竟2023年国内大模型还没成型,当时
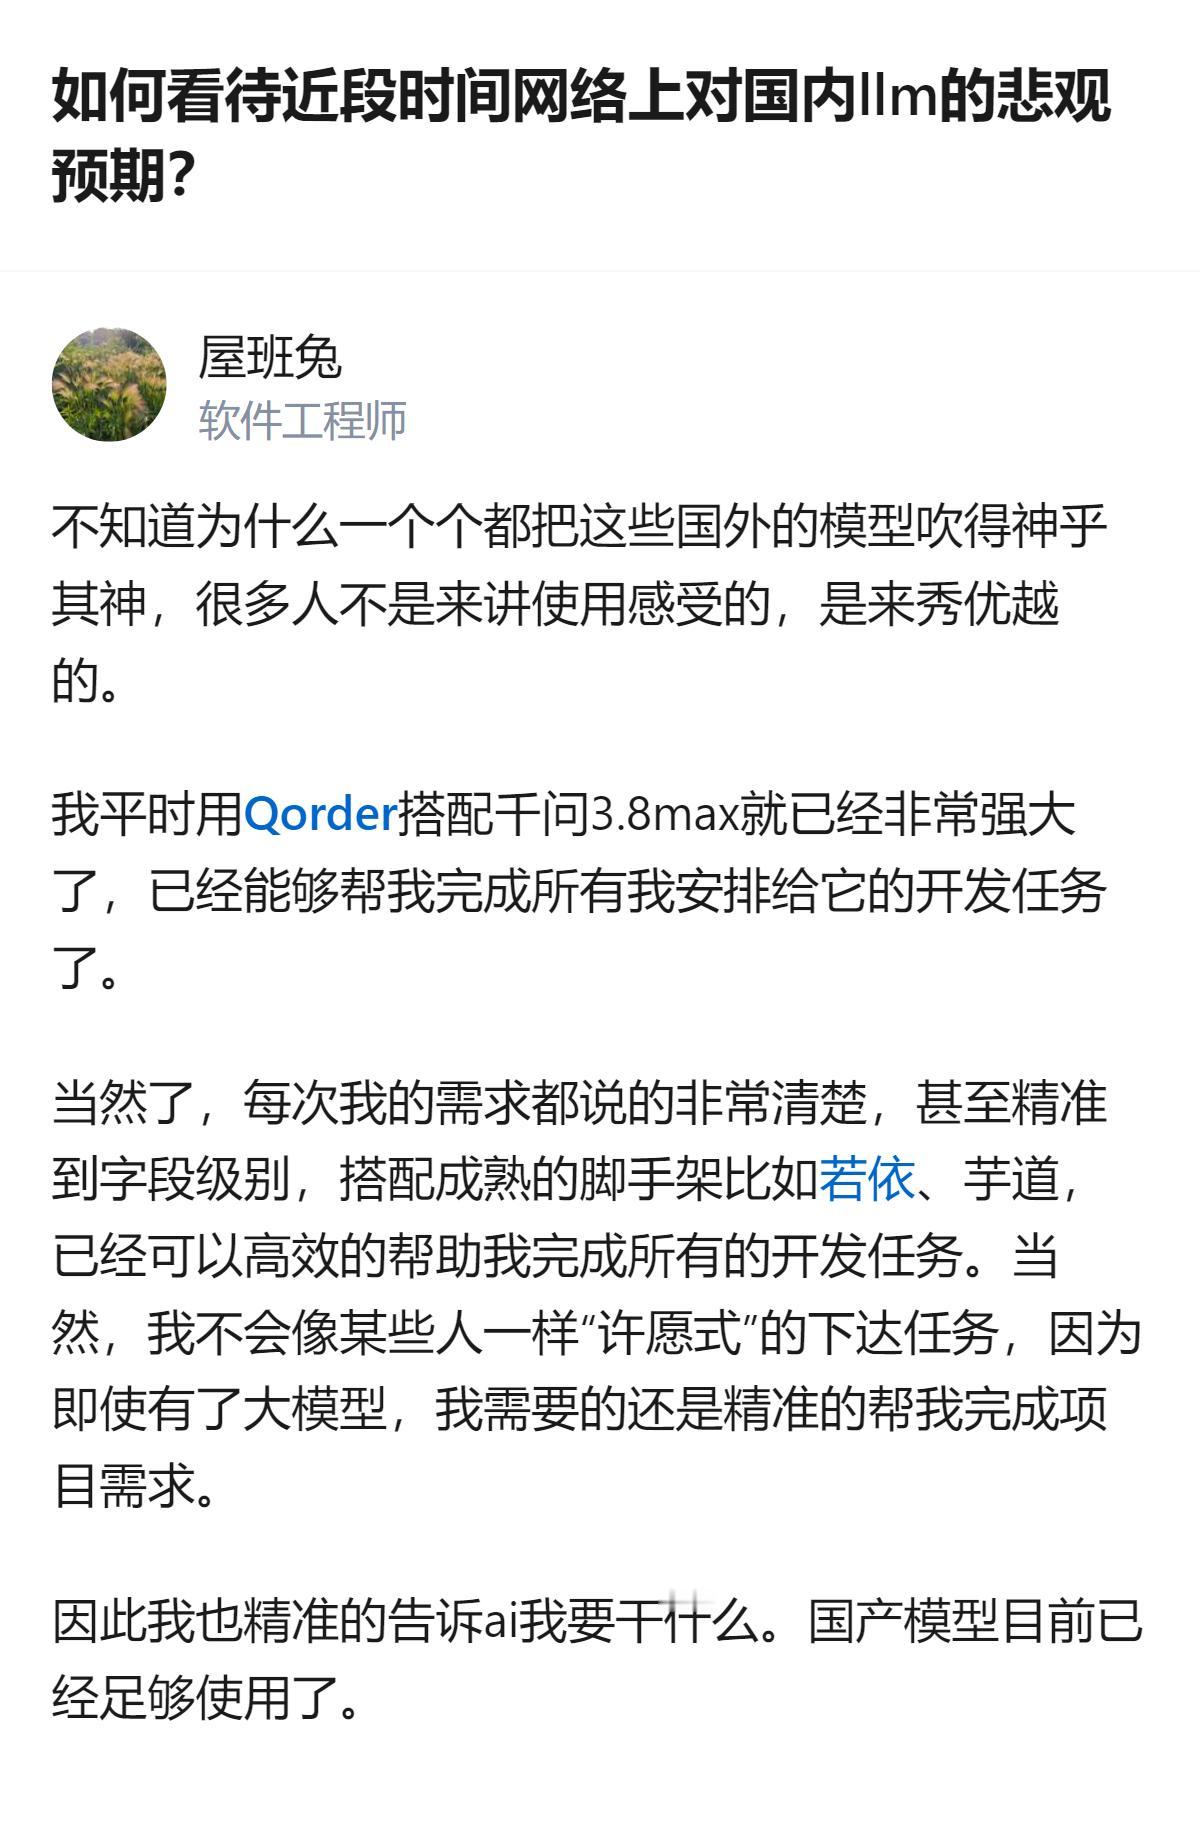
针对国内大模型的悲观预期,有人觉得没必要,毕竟日常开发需求用千问3.8max搭配
2026-11-17 13:37
针对国内大模型的悲观预期,有人觉得没必要,毕竟日常开发需求用千问3.8max搭配
10周亲手部署LLM推理服务,零基础到生产级 通过部署一个服务学习 LLM 推理
2026-11-17 04:37
10周亲手部署LLM推理服务,零基础到生产级 通过部署一个服务学习 LLM 推理
第一页
下一页
作者信息
幻丝细说科技
感谢大家的关注
热门分类
明星八卦
娱乐
影视
推荐
热榜
军事
NBA
体育
社会
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量