塔斯娱乐资讯网

憨儿逛逛科技的文章

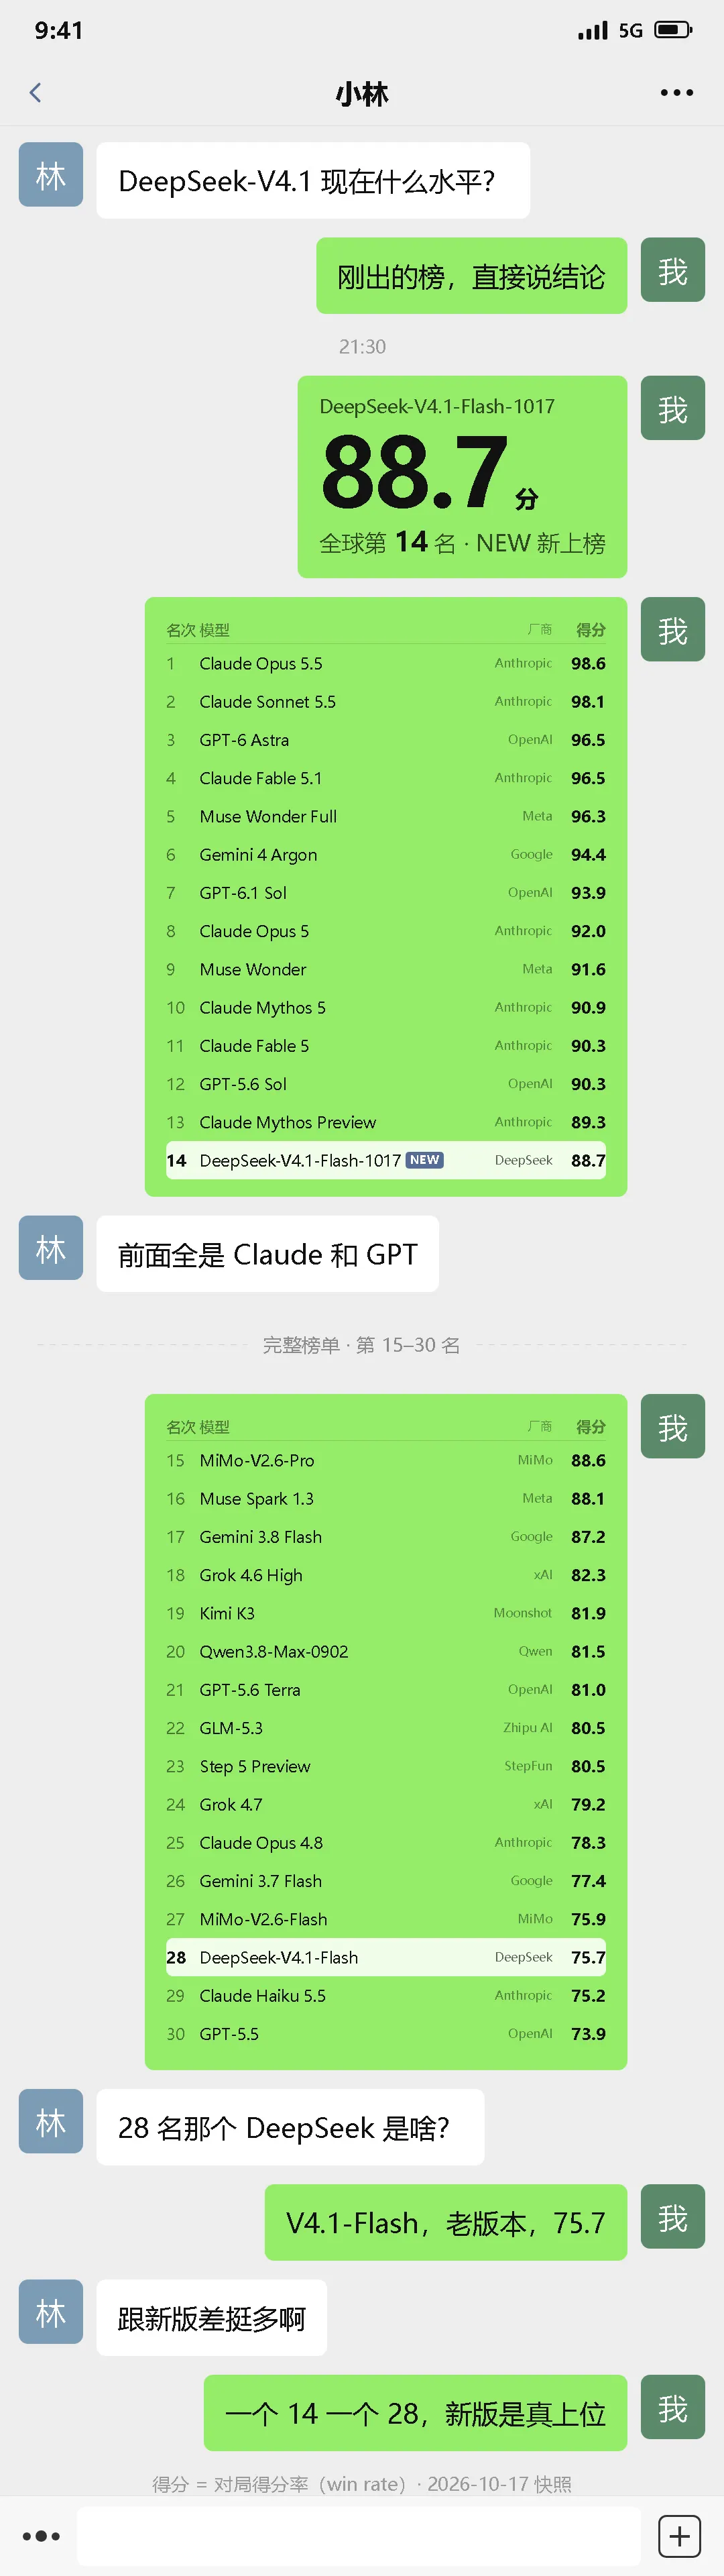
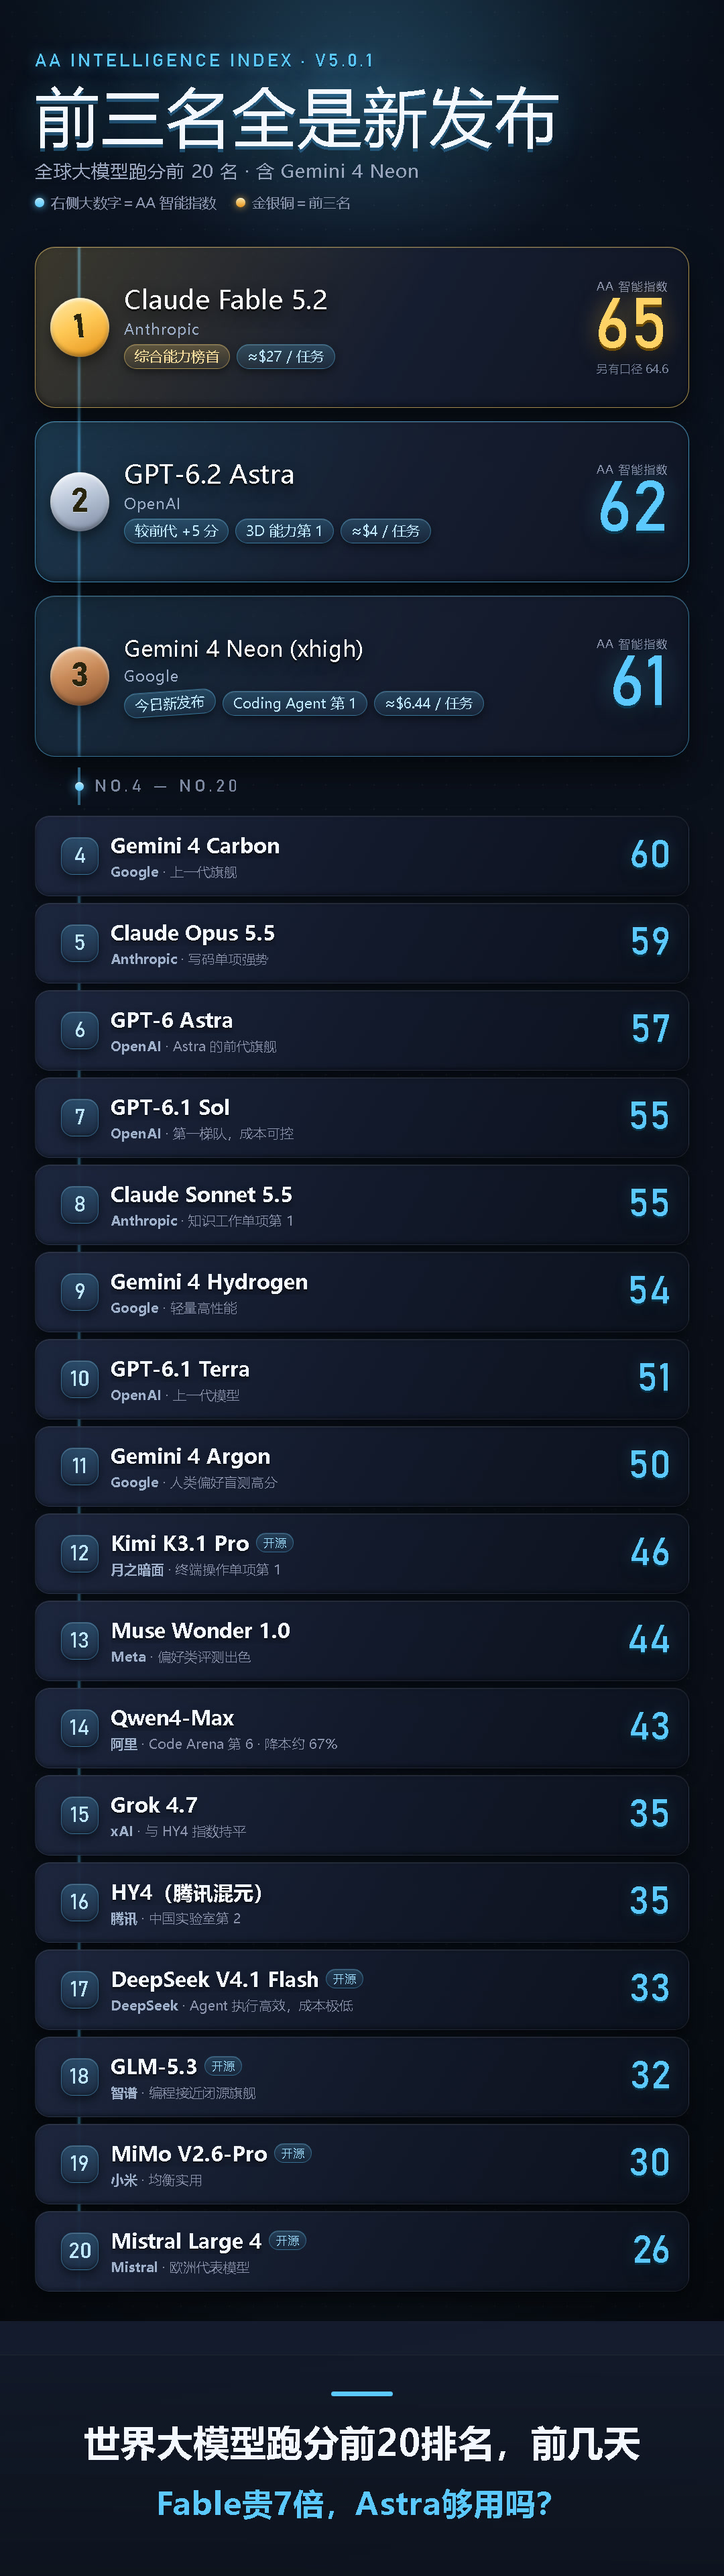
世界大模型跑分前20又变天了。Claude Fable 5.2、GPT-6.2 Astra 前几天刚横空出世,今天Gemini 4 Neon又杀到,大家觉得我们迭代速度慢的原因是什么:算力问题还是算法问题。国外的三个新模型直接把前三包圆了——榜单还没焐热就作废,这个迭代速度本身比排名更吓人。前三被美
世界大模型跑分前20又变天了。Claude Fable 5.2、GPT-6.2 Astra 前几天刚横空出世,今天Gemini 4 Neon又杀到,大家觉得我们迭代速度慢的原因是什么:算力问题还是算法问题。国外的三个新模型直接把前三包圆了——榜单还没焐热就作废,这个迭代速度本身比排名更吓人。前三被美
世界大模型跑分前20又变天了。Claude Fable 5.2、GPT-6.2 Astra 前几天刚横空出世,今天Gemini 4 Neon又杀到,大家觉得我们迭代速度慢的原因是什么:算力问题还是算法问题。国外的三个新模型直接把前三包圆了——榜单还没焐热就作废,这个迭代速度本身比排名更吓人。前三被美
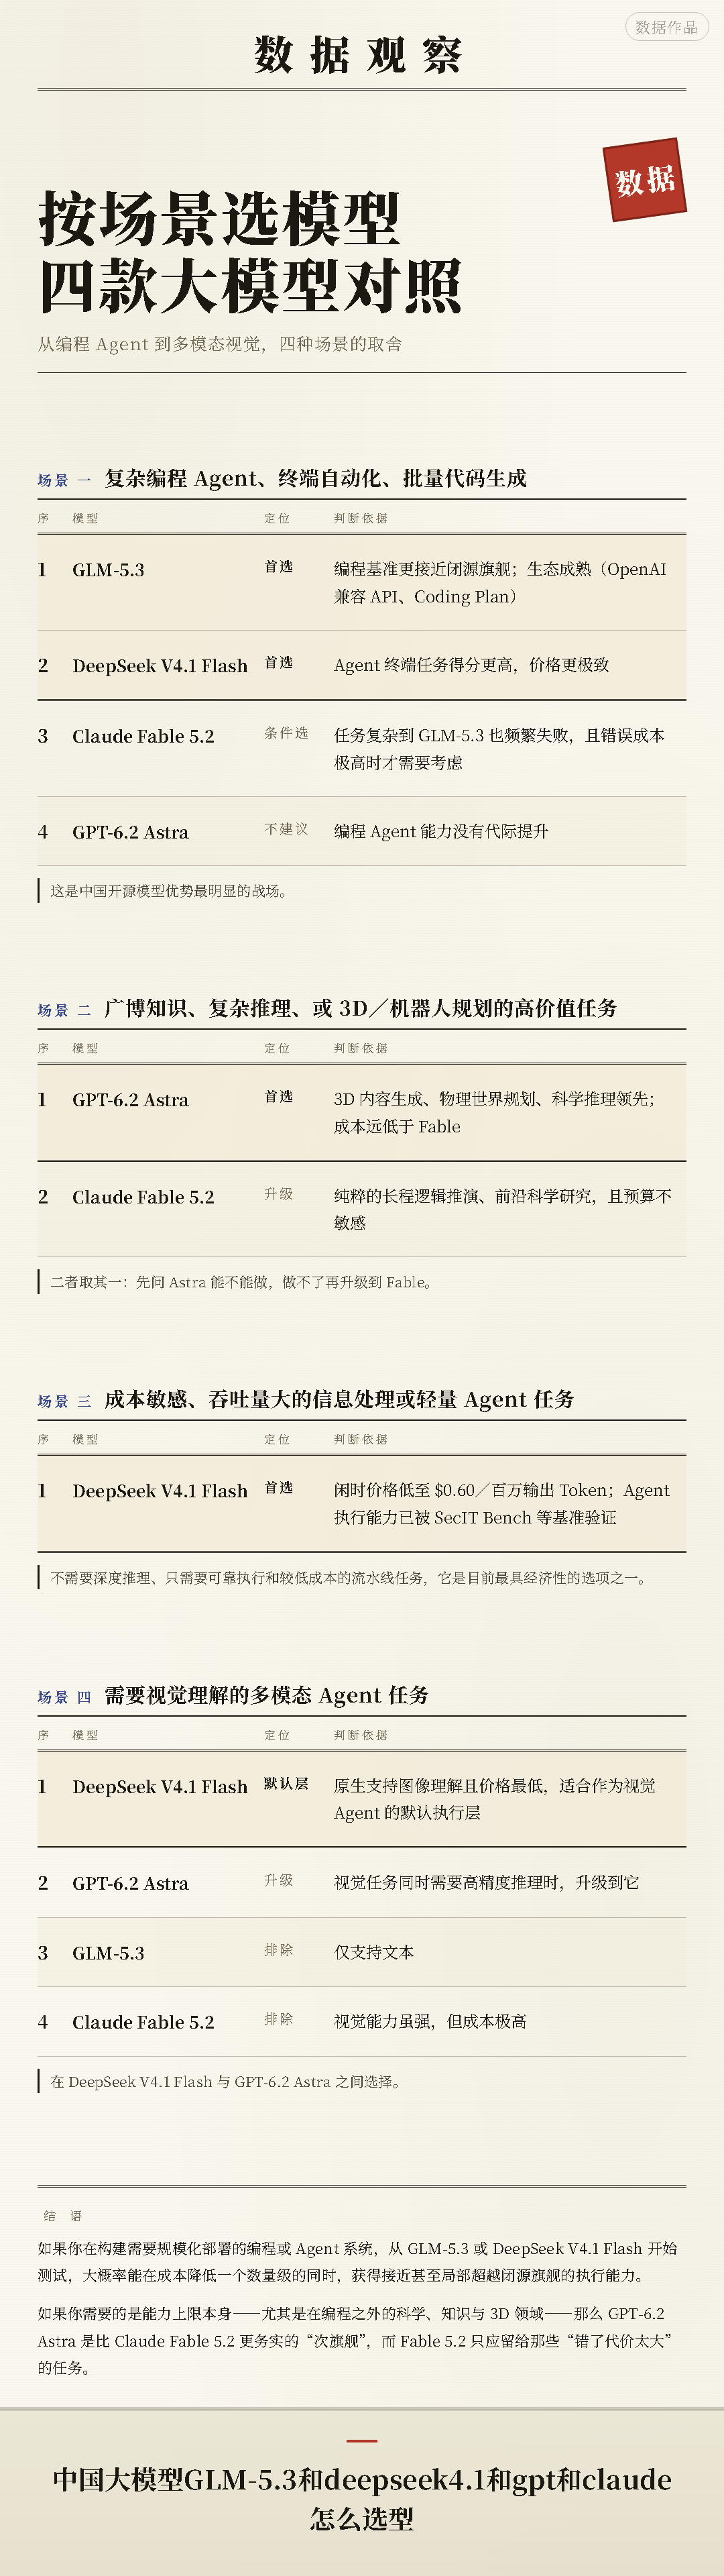
大模型GLM-5.3和deepseek4.1和gpt和claude怎么选型?
如果抛开跑分,只看具体场景和真实账单,选型逻辑会清晰很多。下面用几个具体的案例,来说明这四个模型分别适合什么情况。
🧑💻 案例一:高频、低风险的日常编程任务(测试生成、重构、日志排查)
推荐:DeepSeek V4.1 F

大模型GLM-5.3和deepseek4.1和gpt和claude怎么选型? 如果抛开跑分,只看具体场景和真实账单,选型逻辑会清晰很多。下面用几个具体的案例,来说明这四个模型分别适合什么情况。 🧑💻 案例一:高频、低风险的日常编程任务(测试生成、重构、日志排查) 推荐:DeepSeek V4.1 F

大模型GLM-5.3和deepseek4.1和gpt和claude怎么选型? 如果抛开跑分,只看具体场景和真实账单,选型逻辑会清晰很多。下面用几个具体的案例,来说明这四个模型分别适合什么情况。 🧑💻 案例一:高频、低风险的日常编程任务(测试生成、重构、日志排查) 推荐:DeepSeek V4.1 F
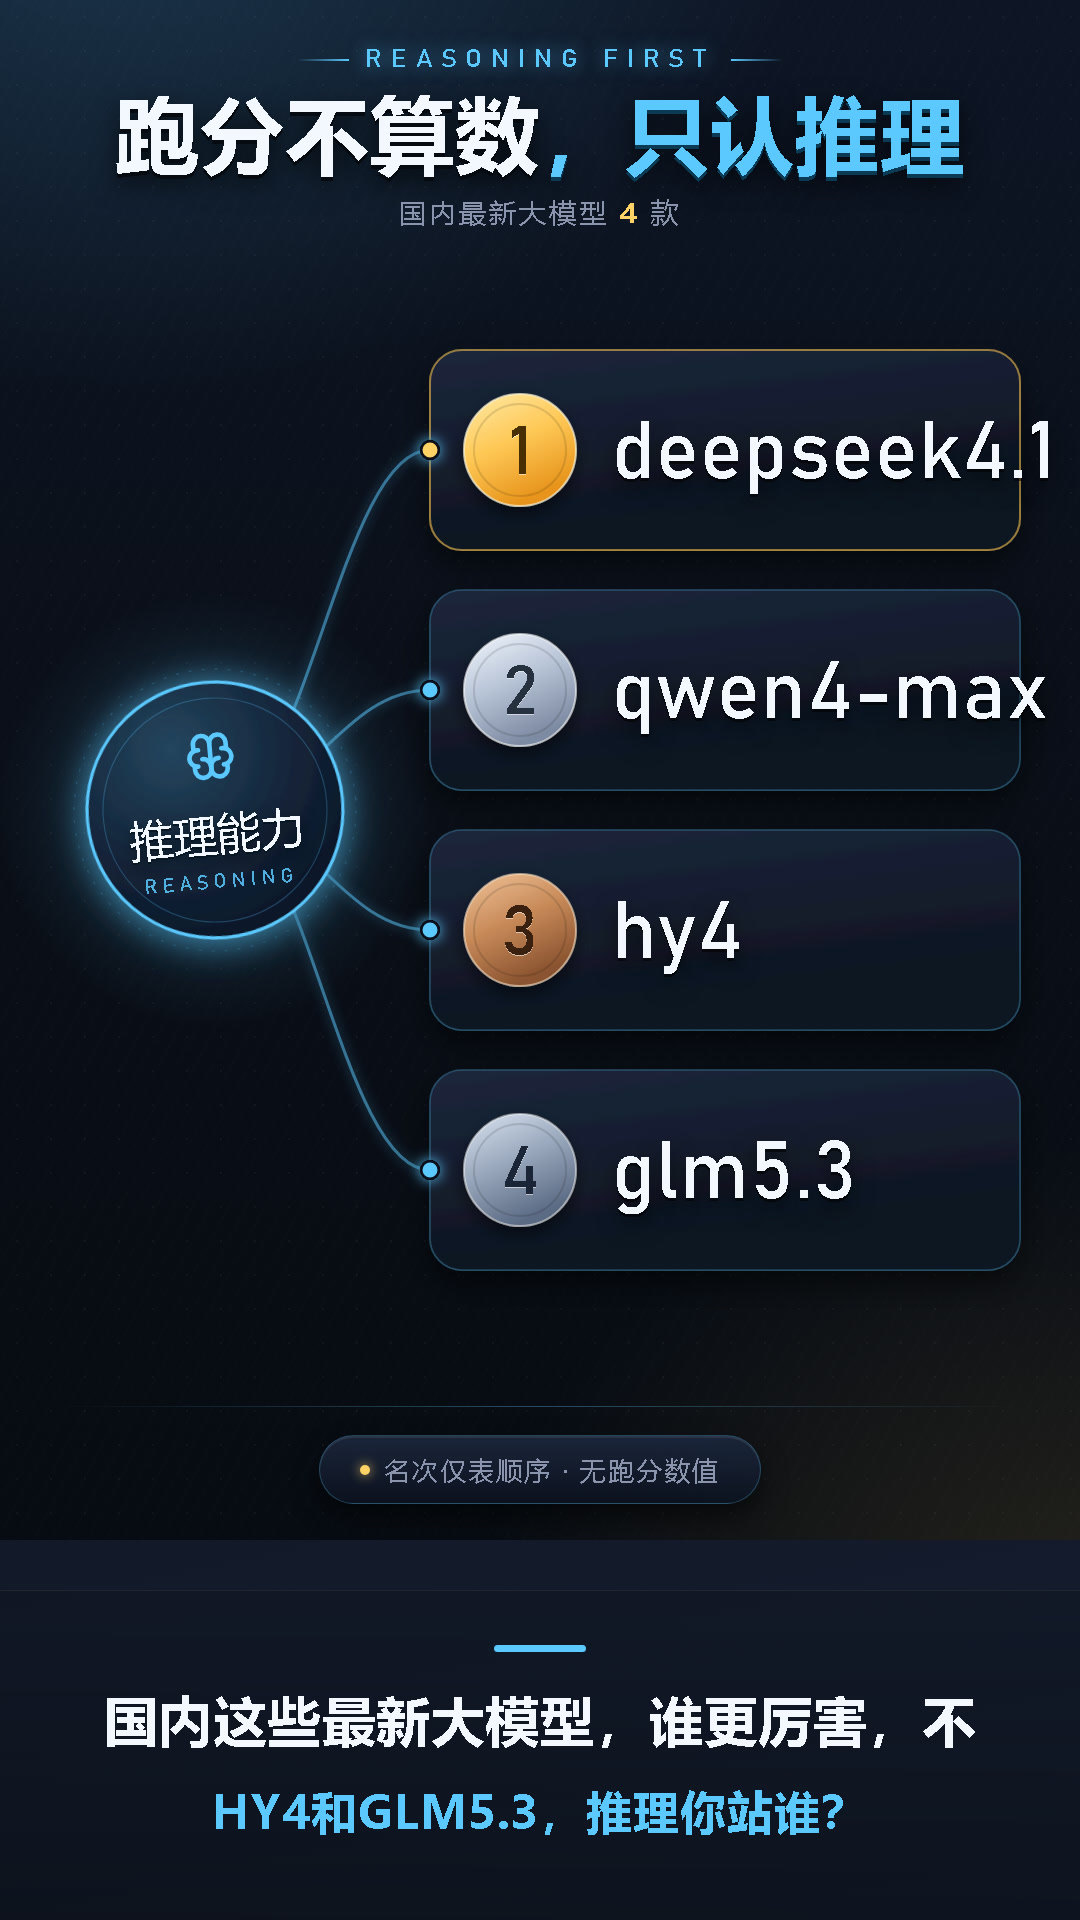
随着hy4和qwen4-max已经出来了,大家觉得国内这些最新大模型:deepseek4.1、qwen4-max、hy4、glm5.3
。谁更厉害,不看跑分,看推理能力?对比我下来我感觉glm5.3更厉害,qwen4-max和hy4只是换了一个版本号而已?你们觉得呢?
国产大模型

随着hy4和qwen4-max已经出来了,大家觉得国内这些最新大模型:deepseek4.1、qwen4-max、hy4、glm5.3 。谁更厉害,不看跑分,看推理能力?对比我下来我感觉glm5.3更厉害,qwen4-max和hy4只是换了一个版本号而已?你们觉得呢? 国产大模型

随着hy4和qwen4-max已经出来了,大家觉得国内这些最新大模型:deepseek4.1、qwen4-max、hy4、glm5.3 。谁更厉害,不看跑分,看推理能力?对比我下来我感觉glm5.3更厉害,qwen4-max和hy4只是换了一个版本号而已?你们觉得呢? 国产大模型
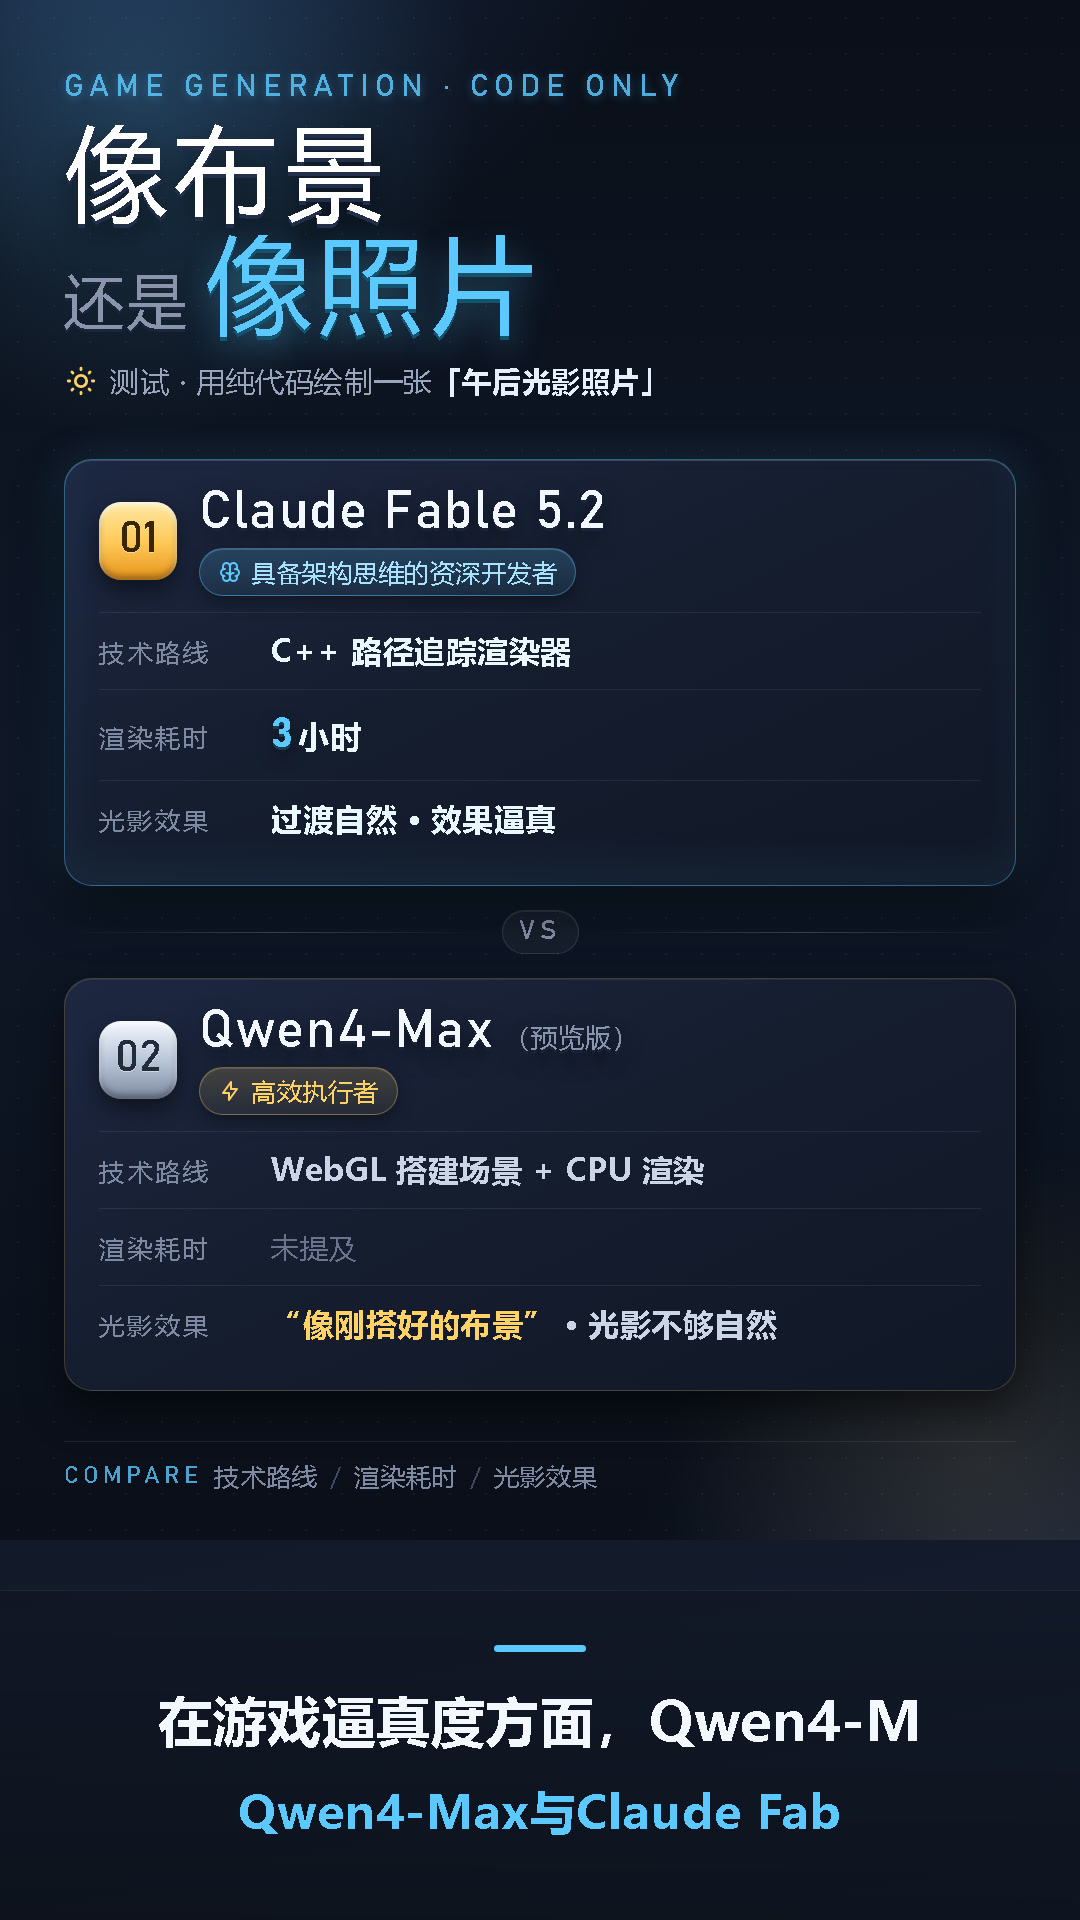
Qwen4-Max (预览版)和 Claude Fable 5.2生成游戏,Claude Fable 5.2完胜Qwen4-Max,主要区别如下:Qwen4-Max 是一个令人惊喜的“高效执行者”,以惊人的效率完成功能明确的模块,而 Qwen4-Max 则选择用 WebGL 搭建场景,并用 CPU

Qwen4-Max (预览版)和 Claude Fable 5.2生成游戏,Claude Fable 5.2完胜Qwen4-Max,主要区别如下:Qwen4-Max 是一个令人惊喜的“高效执行者”,以惊人的效率完成功能明确的模块,而 Qwen4-Max 则选择用 WebGL 搭建场景,并用 CPU

Qwen4-Max (预览版)和 Claude Fable 5.2生成游戏,Claude Fable 5.2完胜Qwen4-Max,主要区别如下:Qwen4-Max 是一个令人惊喜的“高效执行者”,以惊人的效率完成功能明确的模块,而 Qwen4-Max 则选择用 WebGL 搭建场景,并用 CPU
Claude自己设计量子电路,省了39倍

Claude自己设计量子电路,省了39倍

Claude自己设计量子电路,省了39倍
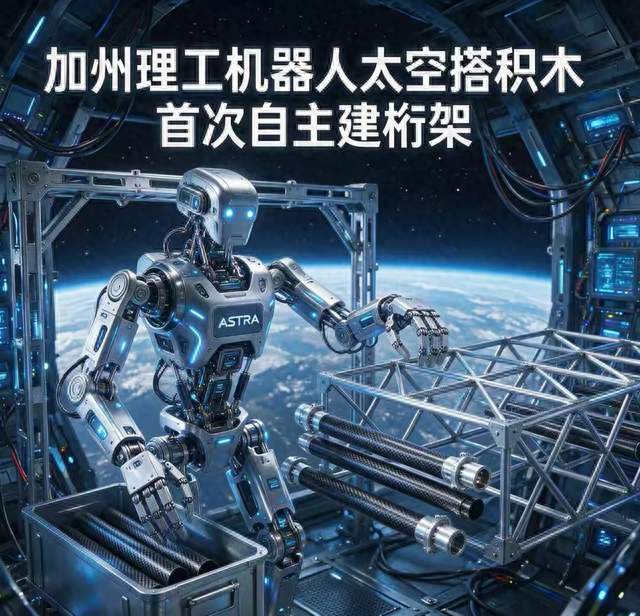
加州理工机器人太空“搭积木”,首次自主建桁架

加州理工机器人太空“搭积木”,首次自主建桁架

加州理工机器人太空“搭积木”,首次自主建桁架
最新DeepSeek-V4.1-Flash-1017大模型,有这么厉害吗,用过的朋友来聊聊。

最新DeepSeek-V4.1-Flash-1017大模型,有这么厉害吗,用过的朋友来聊聊。

最新DeepSeek-V4.1-Flash-1017大模型,有这么厉害吗,用过的朋友来聊聊。
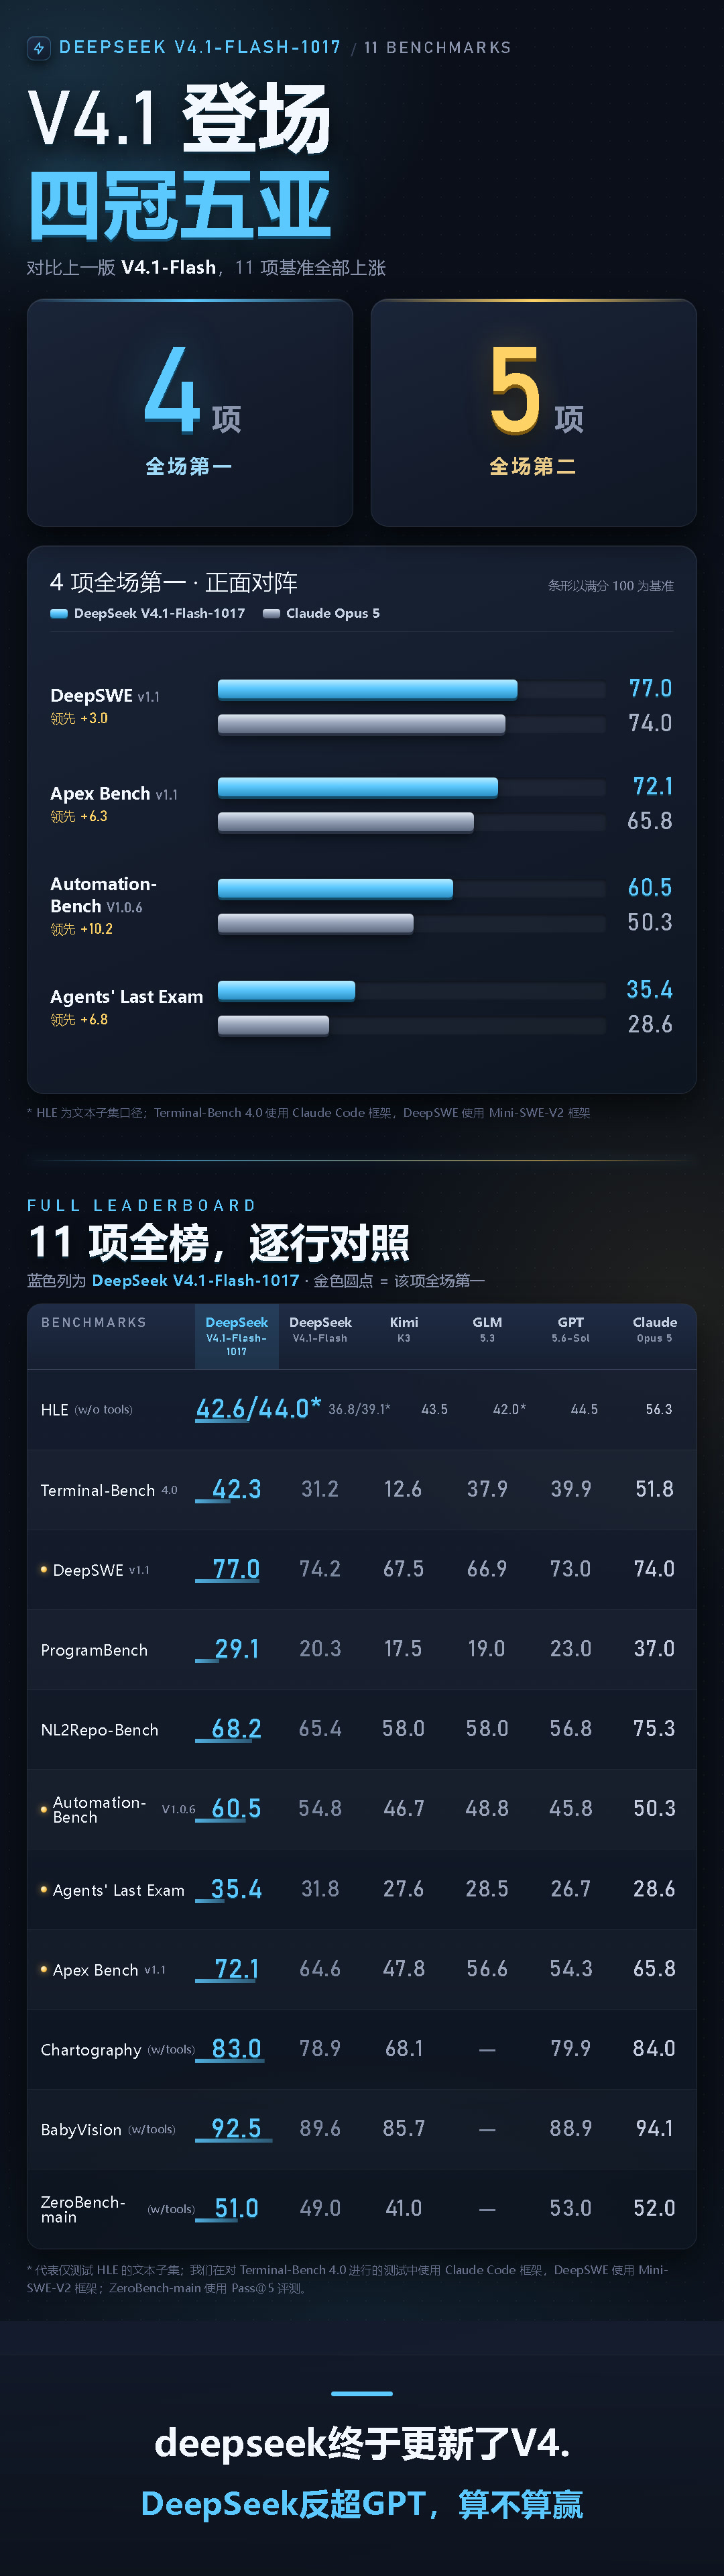
DeepSeek V4.1-Flash-1017是眼下最能打的国产编程模型。终端任务从31.2涨到42.3,反超GPT-5.6-Sol的39.9;Apex这项也比上一版高了7.5分。但别急着吹,Claude Opus 5在终端和代码仓库任务上还压着它,51.8对42.3。这波算真超车,还是只赢半程?

DeepSeek V4.1-Flash-1017是眼下最能打的国产编程模型。终端任务从31.2涨到42.3,反超GPT-5.6-Sol的39.9;Apex这项也比上一版高了7.5分。但别急着吹,Claude Opus 5在终端和代码仓库任务上还压着它,51.8对42.3。这波算真超车,还是只赢半程?

DeepSeek V4.1-Flash-1017是眼下最能打的国产编程模型。终端任务从31.2涨到42.3,反超GPT-5.6-Sol的39.9;Apex这项也比上一版高了7.5分。但别急着吹,Claude Opus 5在终端和代码仓库任务上还压着它,51.8对42.3。这波算真超车,还是只赢半程?
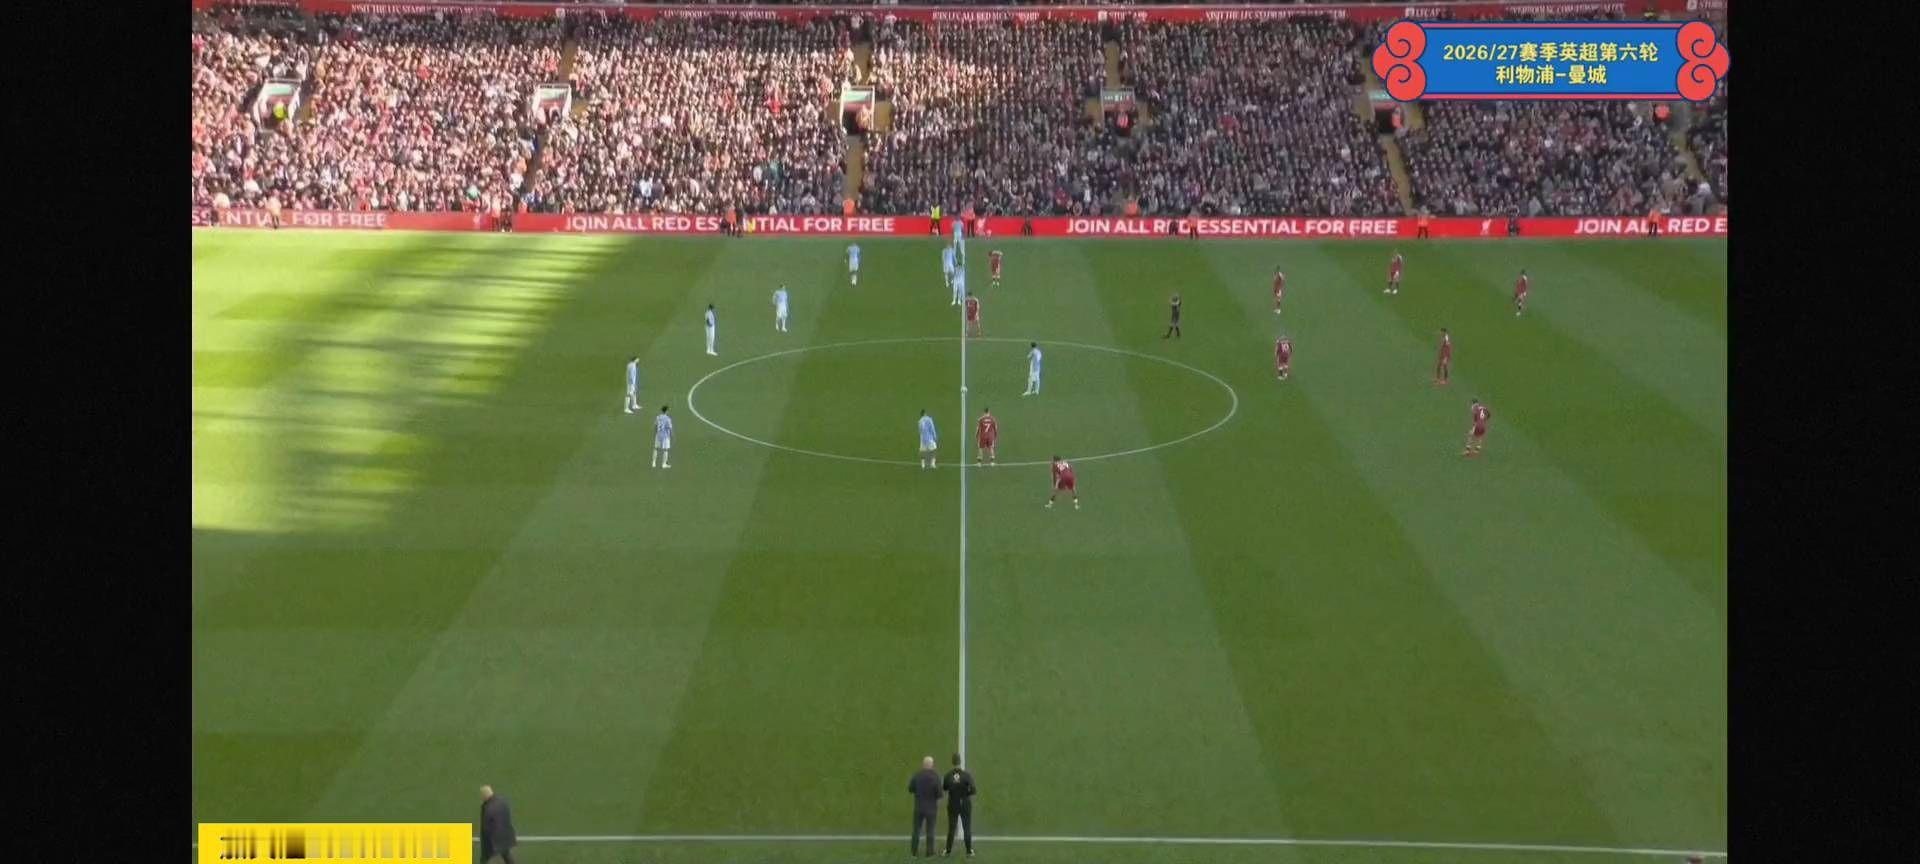
赫拉芬贝赫染红后,十人利物浦0-3曼城

赫拉芬贝赫染红后,十人利物浦0-3曼城

赫拉芬贝赫染红后,十人利物浦0-3曼城
没有阿伟罗的葡萄牙就是对手挪威的噩梦,队内就算有大魔王哈兰德也没有用,这就是葡萄牙新黄金一代的真实实力![呲牙]

没有阿伟罗的葡萄牙就是对手挪威的噩梦,队内就算有大魔王哈兰德也没有用,这就是葡萄牙新黄金一代的真实实力![呲牙]

没有阿伟罗的葡萄牙就是对手挪威的噩梦,队内就算有大魔王哈兰德也没有用,这就是葡萄牙新黄金一代的真实实力![呲牙]
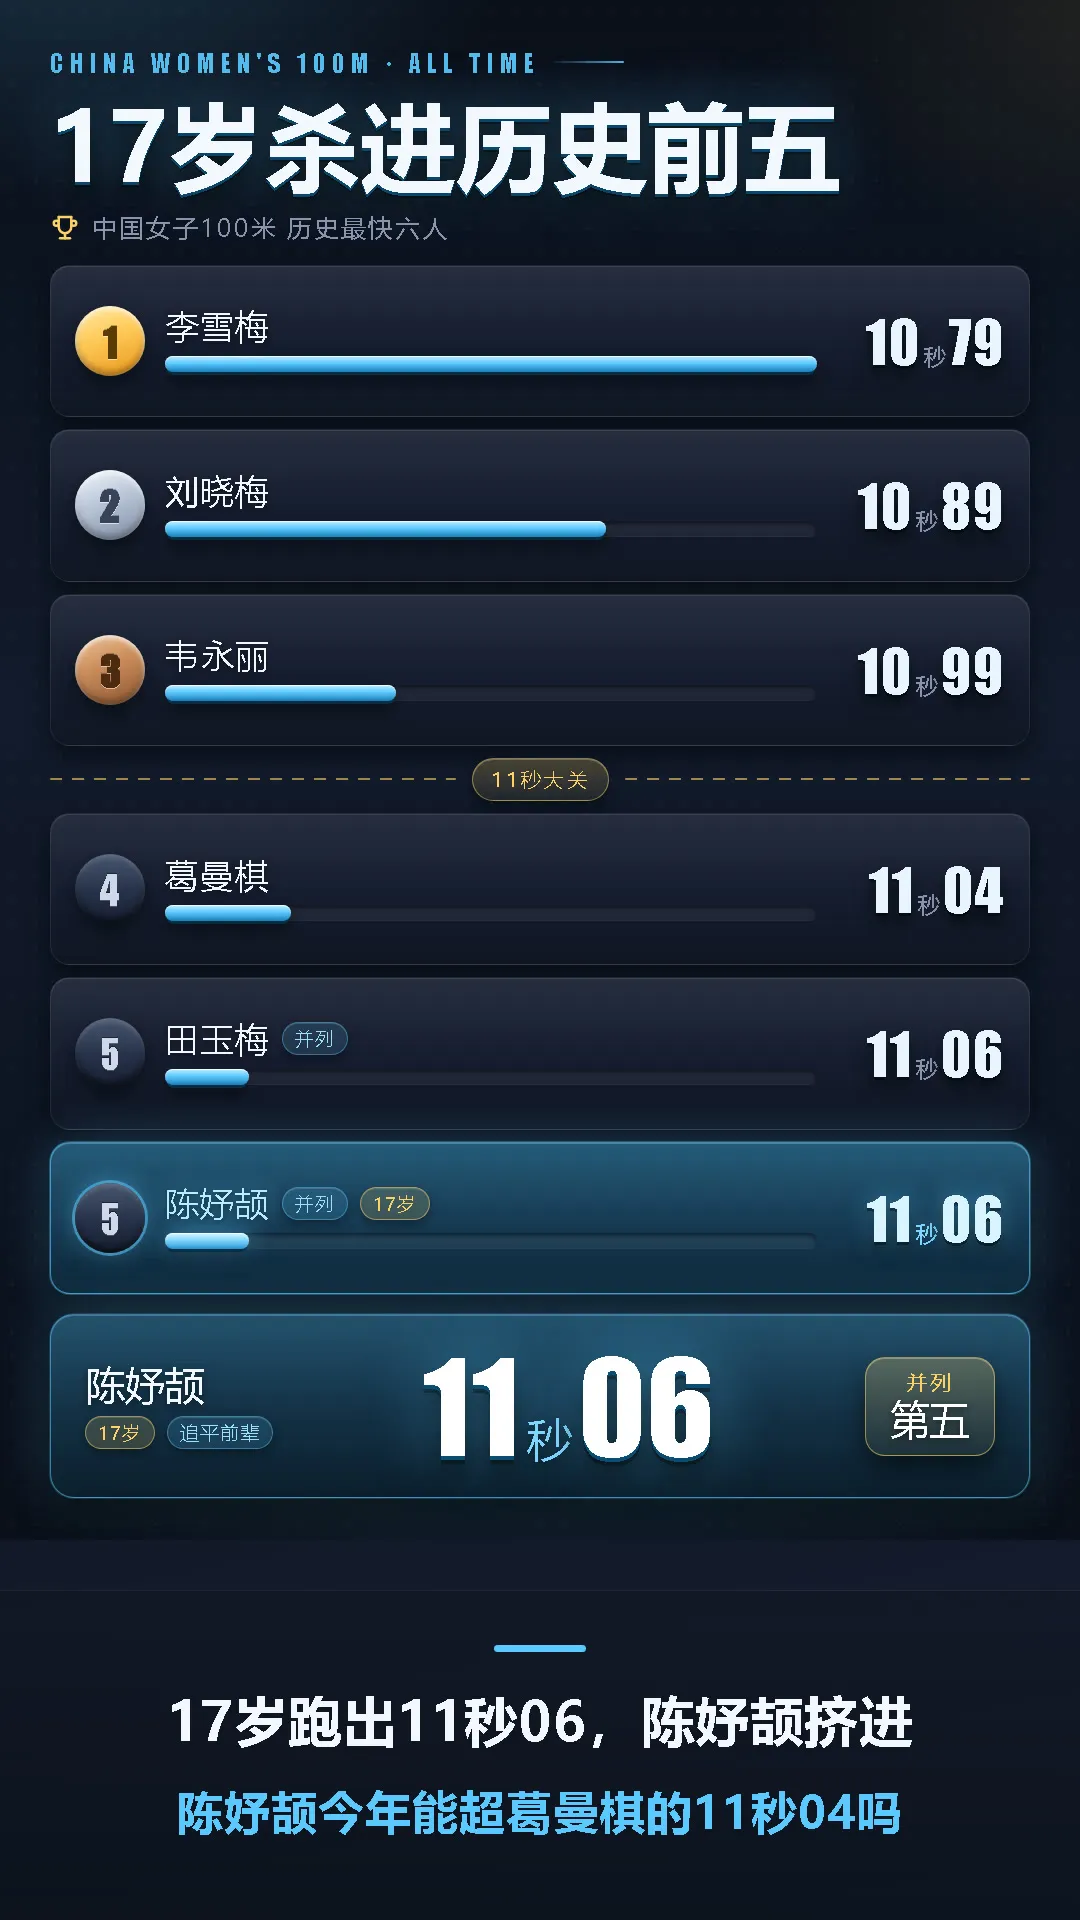
17岁的陈妤颉跑出11秒06,直接并列中国女子百米历史第5,前面只剩李雪梅10秒79、刘晓梅10秒89、韦永丽10秒99、葛曼棋11秒04,和同样11秒06的田玉梅。她距葛曼棋只有0.02秒,一个手掌的距离。这个成绩放在17岁,已经不是&

17岁的陈妤颉跑出11秒06,直接并列中国女子百米历史第5,前面只剩李雪梅10秒79、刘晓梅10秒89、韦永丽10秒99、葛曼棋11秒04,和同样11秒06的田玉梅。她距葛曼棋只有0.02秒,一个手掌的距离。这个成绩放在17岁,已经不是&

17岁的陈妤颉跑出11秒06,直接并列中国女子百米历史第5,前面只剩李雪梅10秒79、刘晓梅10秒89、韦永丽10秒99、葛曼棋11秒04,和同样11秒06的田玉梅。她距葛曼棋只有0.02秒,一个手掌的距离。这个成绩放在17岁,已经不是&
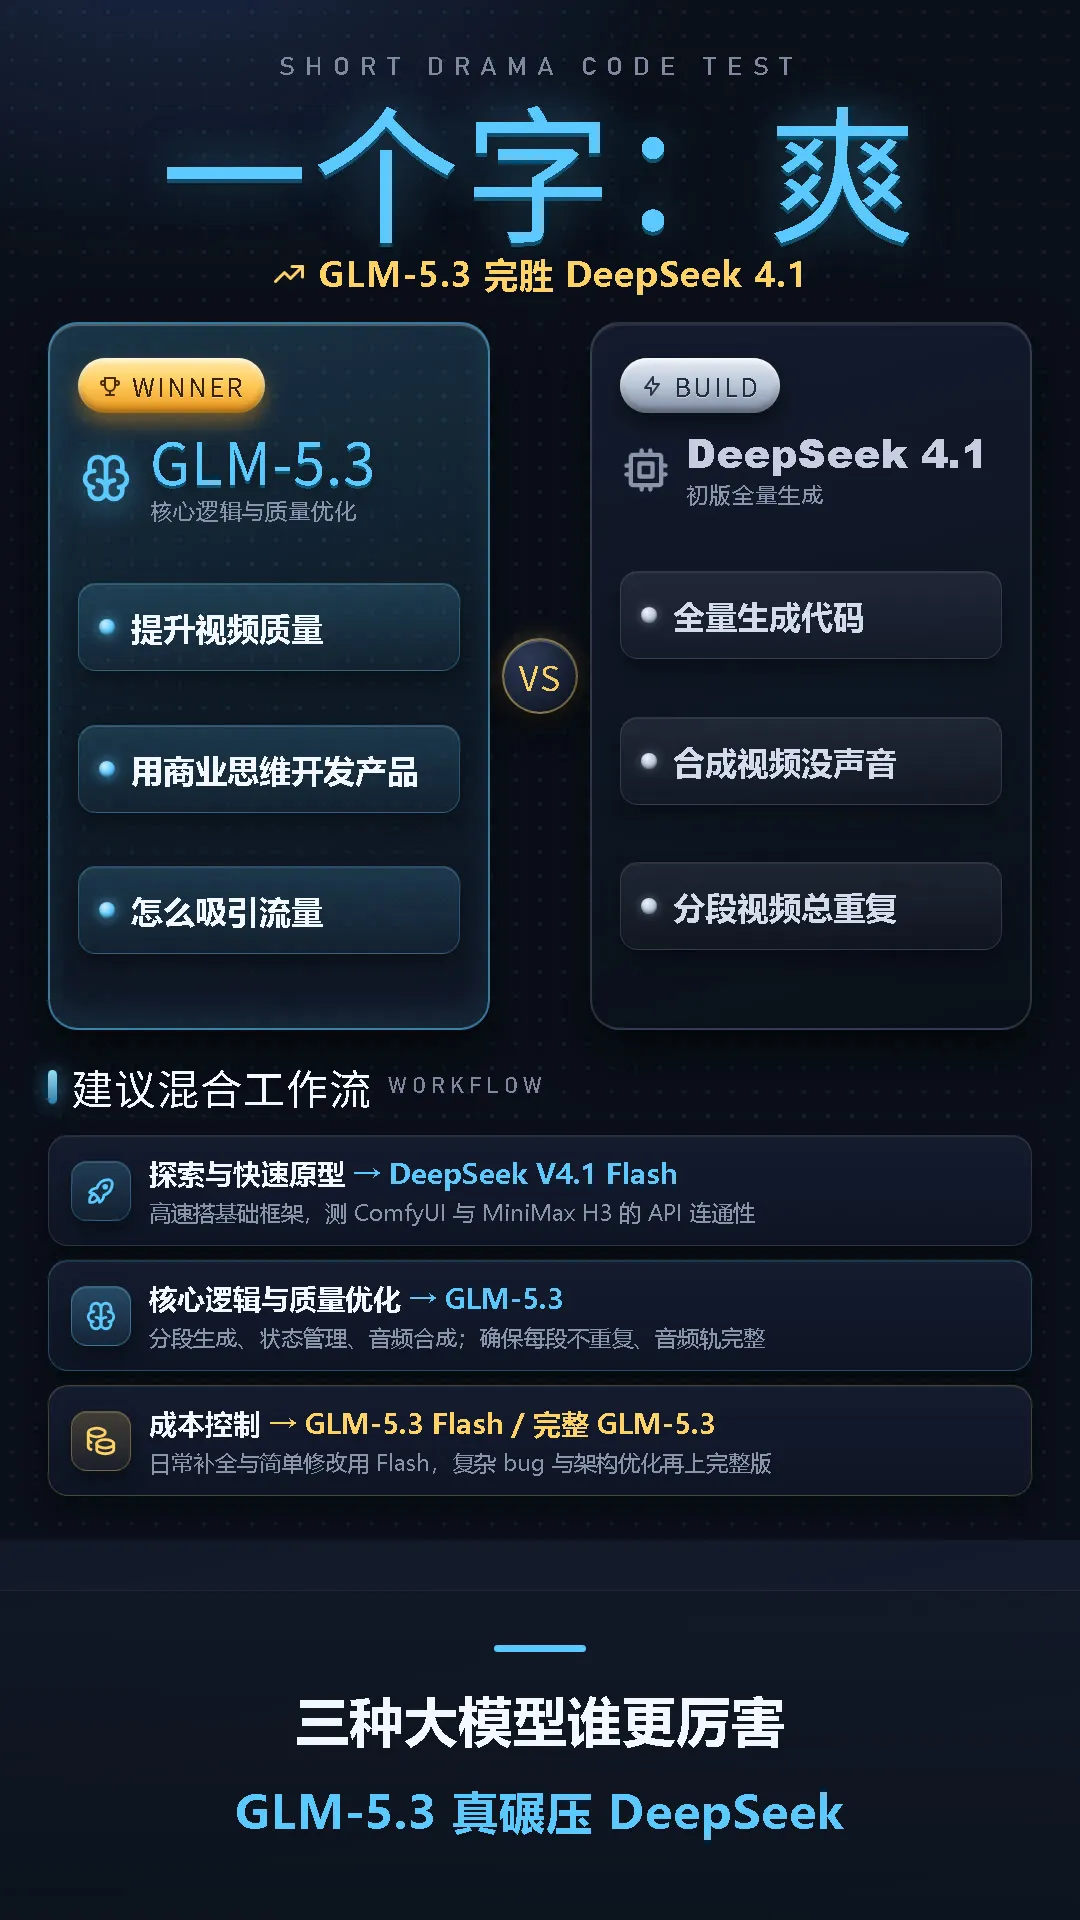
通过做短剧系统,让我知道GLM-5.3确实比DeepSeek4.1更能扛核心逻辑。DeepSeek4.1全量生成代码后,来回优化仍出两个硬伤:合成视频没声音、分段视频总重复。换GLM-5.3后,不只修好,还提升视频质量,顺带把怎么吸引流量也补上。你写复杂系统时,会选快模型还是稳模型?

通过做短剧系统,让我知道GLM-5.3确实比DeepSeek4.1更能扛核心逻辑。DeepSeek4.1全量生成代码后,来回优化仍出两个硬伤:合成视频没声音、分段视频总重复。换GLM-5.3后,不只修好,还提升视频质量,顺带把怎么吸引流量也补上。你写复杂系统时,会选快模型还是稳模型?

通过做短剧系统,让我知道GLM-5.3确实比DeepSeek4.1更能扛核心逻辑。DeepSeek4.1全量生成代码后,来回优化仍出两个硬伤:合成视频没声音、分段视频总重复。换GLM-5.3后,不只修好,还提升视频质量,顺带把怎么吸引流量也补上。你写复杂系统时,会选快模型还是稳模型?
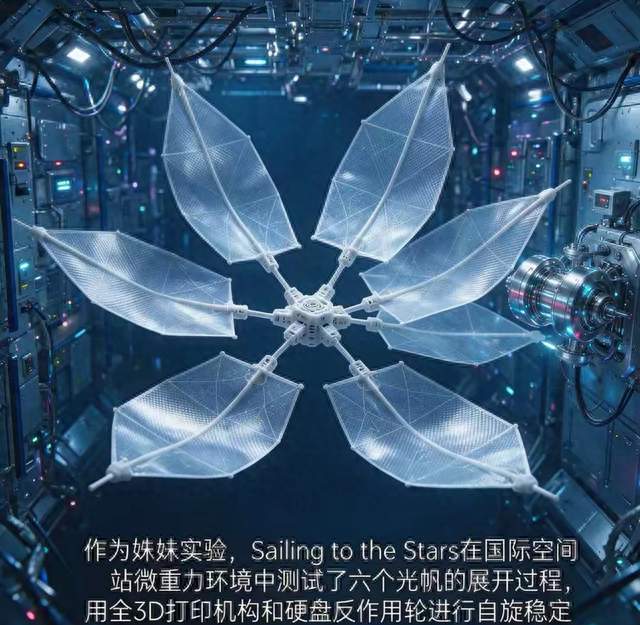
康奈尔学生把光帆送上天,瞄准星际旅行

康奈尔学生把光帆送上天,瞄准星际旅行

康奈尔学生把光帆送上天,瞄准星际旅行
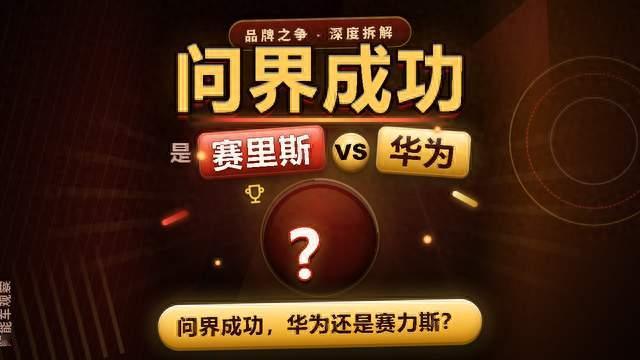
问界的成功,华为和赛力斯缺一不可,但分工极不对等。

问界的成功,华为和赛力斯缺一不可,但分工极不对等。

问界的成功,华为和赛力斯缺一不可,但分工极不对等。
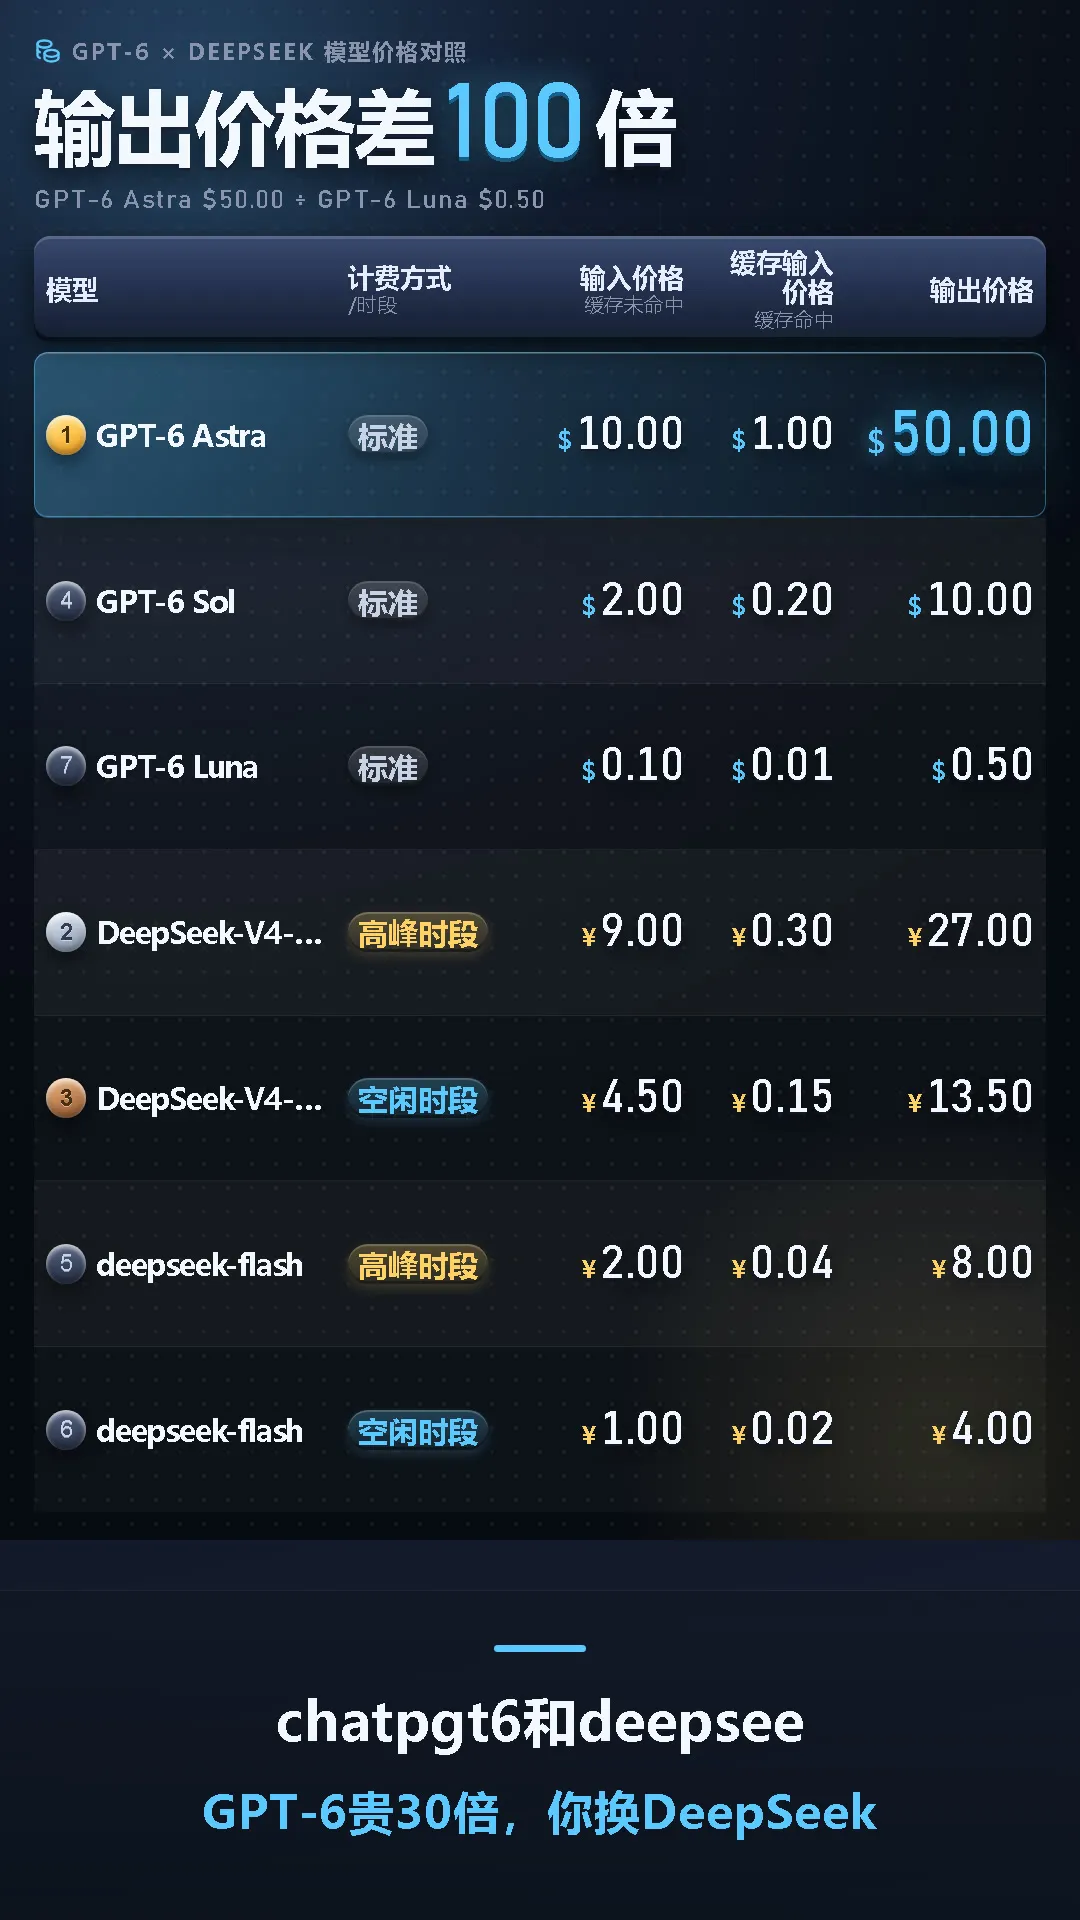
Chatgpt6-luna价格比deepseek4.1还便宜。如果取消禁止我们使用,国内大模型有几个能够活下去

Chatgpt6-luna价格比deepseek4.1还便宜。如果取消禁止我们使用,国内大模型有几个能够活下去

Chatgpt6-luna价格比deepseek4.1还便宜。如果取消禁止我们使用,国内大模型有几个能够活下去
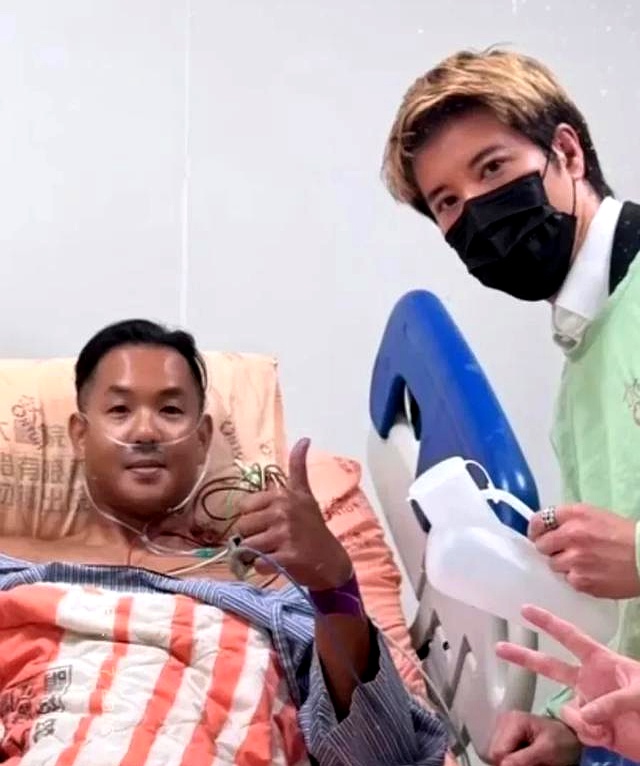
黑人陈建州今天已经从加护病房转到了普通病房,期间还特意接受了媒体采访,术后整个人看着状态还算不错。
 

刚转出来没多久,陈建州就在社交账号上晒出一张合照,王力宏、唐志中一帮兄弟赶到病房探望,大家聚在病床前同框。
 

画面里唐志中扣着棒球帽,一旁的范玮琪满脸憔悴、显得疲惫不堪,这几天守在医院估计也

黑人陈建州今天已经从加护病房转到了普通病房,期间还特意接受了媒体采访,术后整个人看着状态还算不错。 刚转出来没多久,陈建州就在社交账号上晒出一张合照,王力宏、唐志中一帮兄弟赶到病房探望,大家聚在病床前同框。 画面里唐志中扣着棒球帽,一旁的范玮琪满脸憔悴、显得疲惫不堪,这几天守在医院估计也

黑人陈建州今天已经从加护病房转到了普通病房,期间还特意接受了媒体采访,术后整个人看着状态还算不错。 刚转出来没多久,陈建州就在社交账号上晒出一张合照,王力宏、唐志中一帮兄弟赶到病房探望,大家聚在病床前同框。 画面里唐志中扣着棒球帽,一旁的范玮琪满脸憔悴、显得疲惫不堪,这几天守在医院估计也
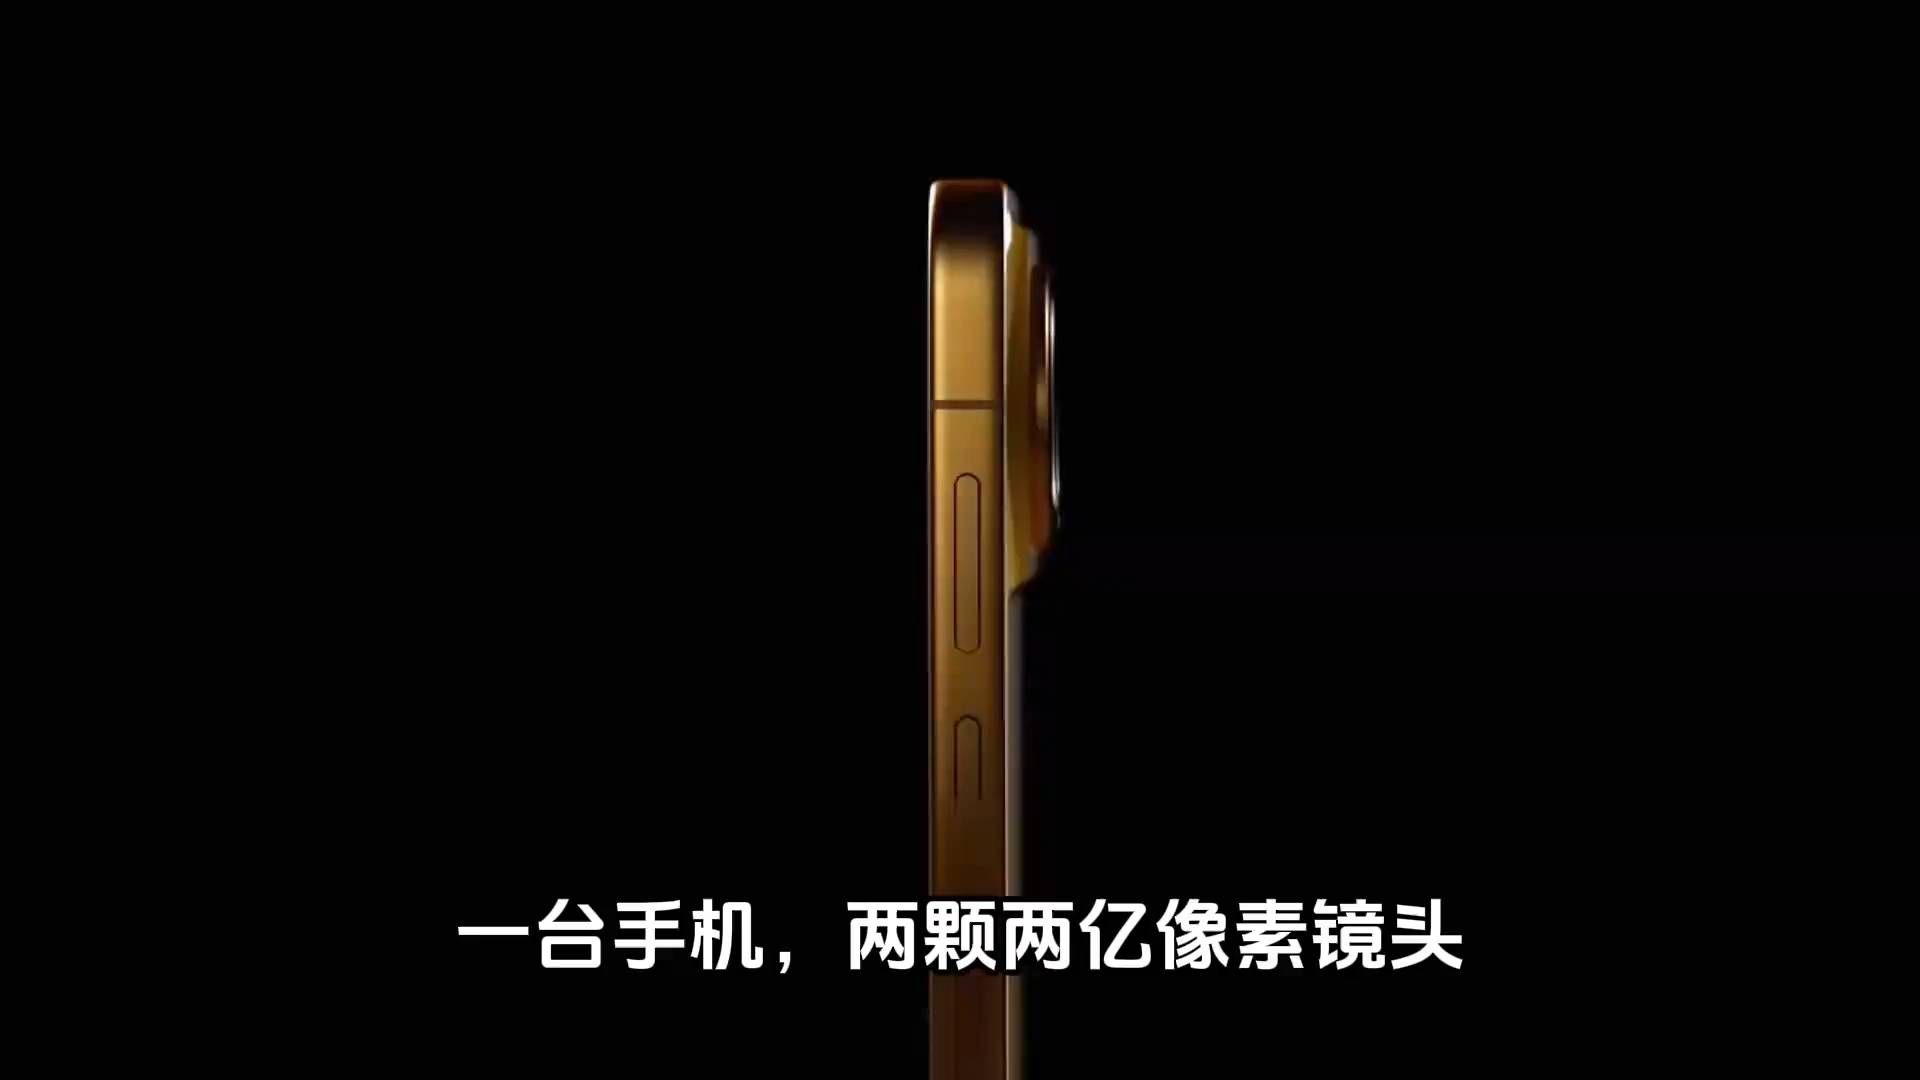
荣耀Magic9携双2亿阿莱,苹果慌吗?

荣耀Magic9携双2亿阿莱,苹果慌吗?

荣耀Magic9携双2亿阿莱,苹果慌吗?
AI智能体手机问世,手机行业迎来颠覆性变革

AI智能体手机问世,手机行业迎来颠覆性变革

AI智能体手机问世,手机行业迎来颠覆性变革
deepseek ,智谱,千问 未来谁活的最好。

deepseek ,智谱,千问 未来谁活的最好。

deepseek ,智谱,千问 未来谁活的最好。
这次轮到中国“定规矩”了。
 

9月16日,中国移动干了一件大事,正式宣布向全球开源了Open-RAIL,这是行业内第一个把VLA/WAM模型和机器人本体连起来的通用工程底座。
 

简单来说就是,以前给机器人装上大模型大脑,不代表它就能干活,不同品牌的机器人关节定义不同、通信协议不同,换一台新机

这次轮到中国“定规矩”了。 9月16日,中国移动干了一件大事,正式宣布向全球开源了Open-RAIL,这是行业内第一个把VLA/WAM模型和机器人本体连起来的通用工程底座。 简单来说就是,以前给机器人装上大模型大脑,不代表它就能干活,不同品牌的机器人关节定义不同、通信协议不同,换一台新机

这次轮到中国“定规矩”了。 9月16日,中国移动干了一件大事,正式宣布向全球开源了Open-RAIL,这是行业内第一个把VLA/WAM模型和机器人本体连起来的通用工程底座。 简单来说就是,以前给机器人装上大模型大脑,不代表它就能干活,不同品牌的机器人关节定义不同、通信协议不同,换一台新机