AI 一开口就是八百字,重点埋在第三段,你划两下就烦了。
我以前也是这么受罪的,直到刷到 GitHub 上一个叫 attention-span 的 skill。
它干的事特别简单:不改 AI 的能力,只改 AI 说话的方式——先给结论,能短就短,废话砍掉。8 月 4 号才建,5 个月 1000 多颗星,还自带中文版。
外网一堆博主都在吹它,但全是"介绍",没几个人真跑过。我本地就有个 Qwen 27B,那就别废话了,直接跑。
【怎么装(30 秒)
它就是个 markdown 文件,丢进你的 agent 配置就行。我拉下来直接喂给本地模型:
curl -sfL https://raw.githubusercontent.com/alexgreensh/attention-span/main/output-styles/attention-kind.md
【我测了什么
同一个问题,喂两次:
"一个新的社交 App,该用 PostgreSQL 还是 MongoDB?给个真实建议 + 取舍。"
第一次:默认状态。第二次:装上 attention-span 的 attention-kind 风格。
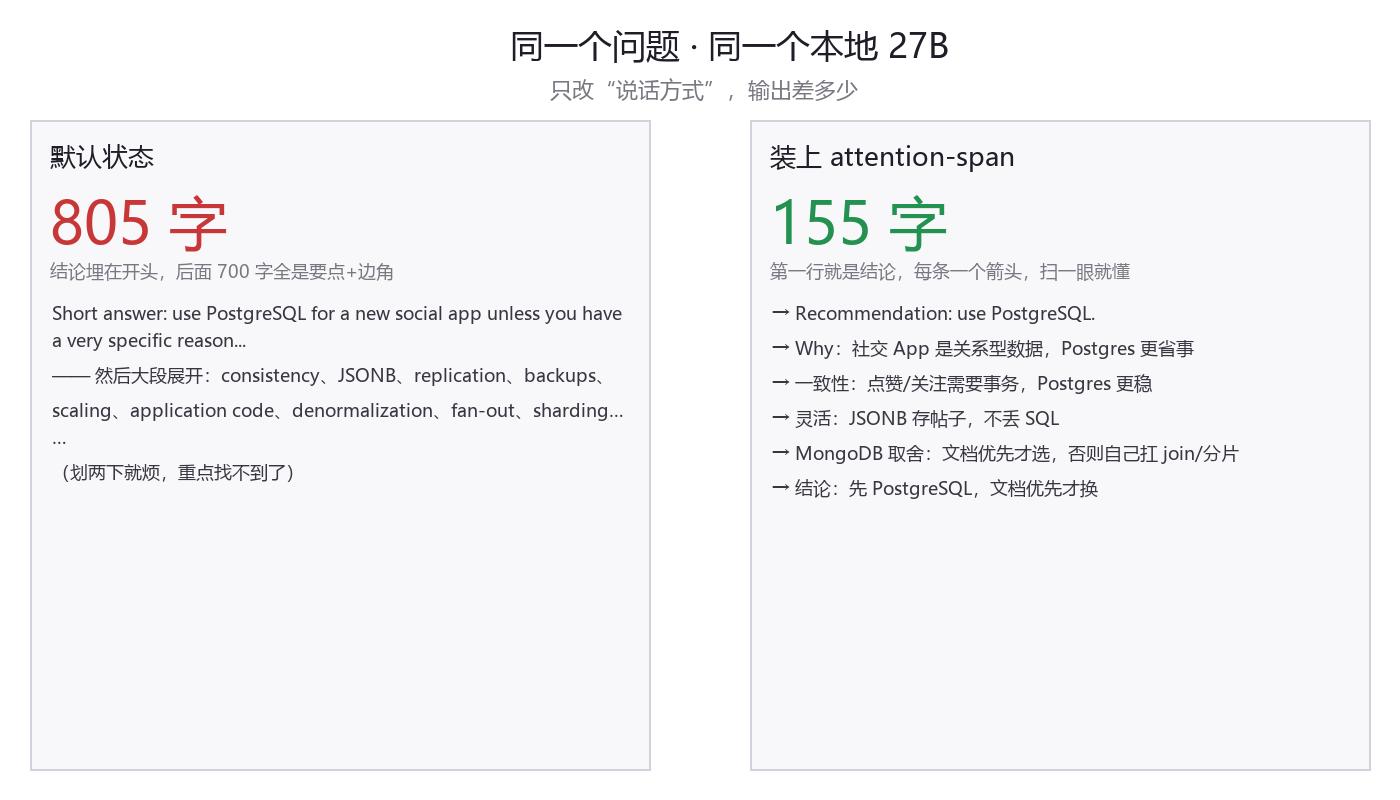
同一个 27B,同一个问题,只改"说话方式"。
【结果(真数据,本地 Qwen 27B)
| | 默认 | 装上 skill || 字数 | 805 字 | 155 字 || 结论 | "用 PostgreSQL"(埋在开头,后面 700 字展开) | "用 PostgreSQL"(第一行就是) || 关键取舍 | 都在,但混在大段里 | 每条一个箭头,扫一眼就懂 |
输出直接砍掉 81%,而且结论、取舍一个没丢。
官方在他们最强模型上测是省 43%,我本地 27B 上省 81%——为啥?因为我们本地模型默认更啰嗦,砍的空间更大。你用的模型越"话痨",这个 skill 越值。
【一个翻车现场(诚实说)
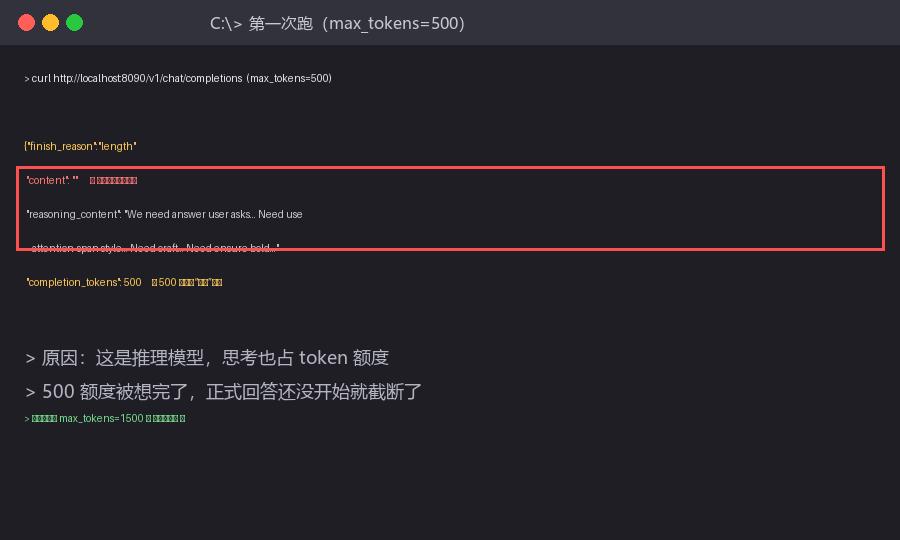
第一次跑,我给它 500 token 上限,结果正式回答一个字没吐——它把 500 token 全花在"思考"上了(这是推理模型,思考也占额度)。我调到 1500 才正常出答案。
所以装之前看一眼你的模型是不是"边想边说"的类型,token 上限给足。
【值不值?我的判断
适合你: 天天被 AI 长回答淹没的、本地跑模型的(空间更大)、给团队做 AI 工具的(交付更干净)。
不适合你: 你就是要 AI 把每个角落都讲透的(它有"你要求深入就放开"的开关,但默认是往短走)。
一句话:能力没动,只是把 AI 从"话痨"调成"先说重点"。免费、开源、一个文件的事。
---
仓库地址:github.com/alexgreensh/attention-span(AGPL-3.0,免费)我的完整实测数据 + 两份输出全文:已存 `D:\AI\hermes\attention-span-experiment.md`下期预告:(占位——下期挖哪个 GitHub skill)签名:"我是 Tfelix,帮普通人把 AI 用起来。每条都真跑过,关注不迷路。"