你让 AI 做个判断题,它给你写一篇作文。
我让本地 qwen3.8-27B 给一篇稿子打 7 个质检分,它想了 76 秒,正文空着,一个字没吐。
有另一个模型,不写一个字,0.6 秒全答完。
它叫 Jev,TypeSafe AI 出的,今年 9 月 15 号发布。
它官方宣传里这么写,原样贴你:
> "Jev can deliver those judgments reliably at much lower latency and cost"——比 LLM 低延迟、低成本地给出可靠判断。
我拿我们自己的稿子测了一把:同一个判断题,DeepSeek 平均 10 秒,Jev 0.6 秒;qwen3.8-27B 三次全交白卷。
"低成本"它没夸大,"可靠"它也没吹满。
划重点,它不是"更小的 GPT",是另一种物种。传统大模型一个 token 一个 token 往外蹦(慢、会幻觉、会类型错);Jev 不生成文字,你问 7 个判断题,它**并行**出 7 个答案,每个带 0-1 的概率。
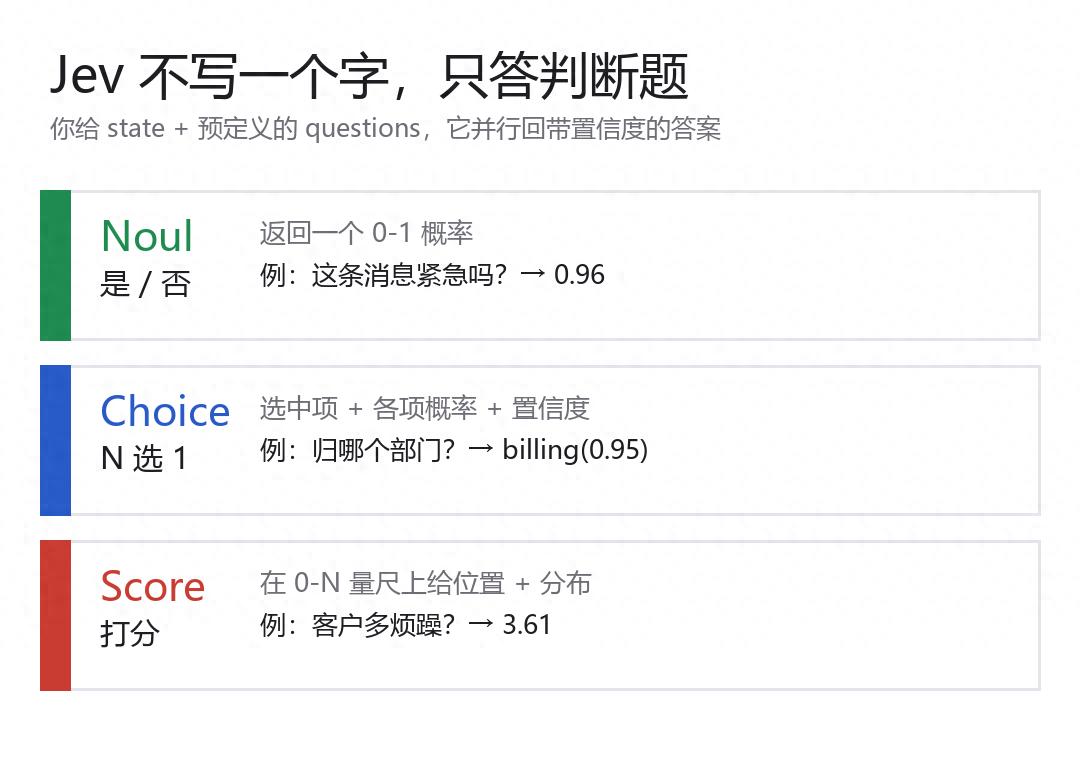
我先跑,再说话。
我把我们刚发的那 3 期稿子(第 14、15、16 期)拿来做质检样本,让三方各判 7 项——人格盲读、脏话超限、半文半白、AI 腔、炫识、攻击三段式、递药落点。只变一个变量:谁来做这个判断。
账本摆出来:
| | Jev | DeepSeek | qwen3.8-27B ||---|---|---|---|| 3 篇全出结果 | 3/3 | 2/3(1 篇超时) | **0/3(全空正文)** || 稳定耗时 | ~0.6 秒 | ~10 秒 | 76 秒+ || 单次成本 | $0.00009 | $0.00035 | $0 || 跟我人工判的一致率 | 16/21(76%) | 11/14(79%) | 0(没出结果) |
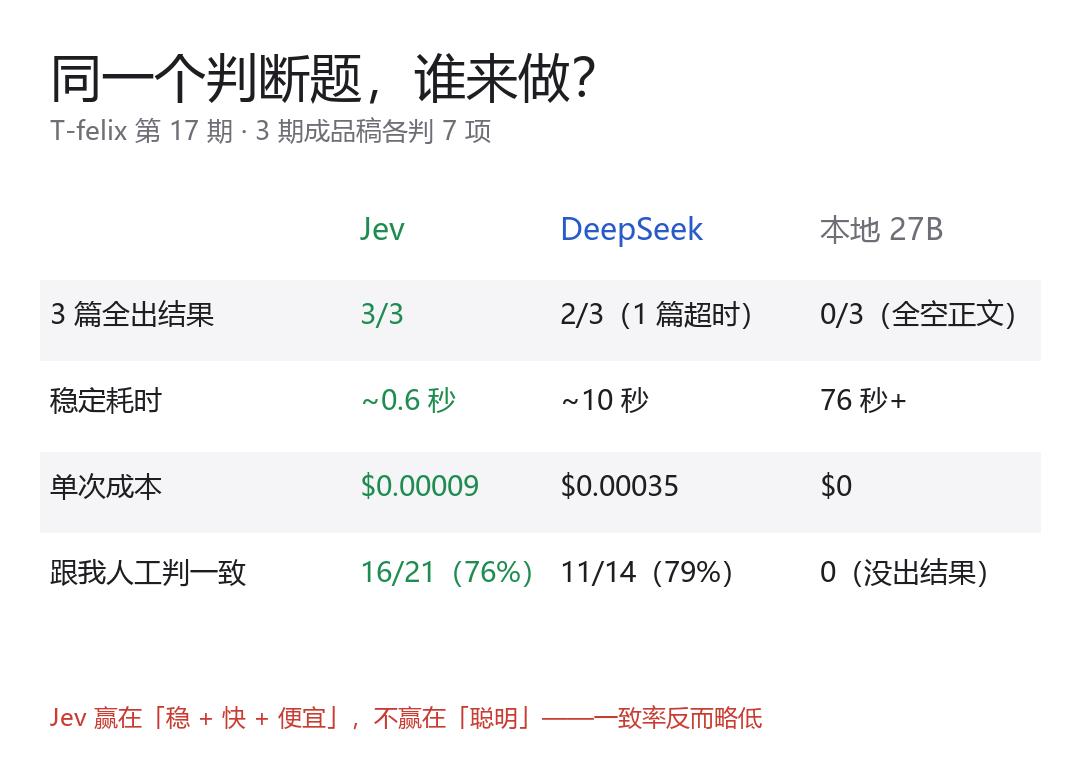
丑话说在前面:**Jev 不比谁聪明。**
它宣传里那句 "reliably"——我拿 3 篇真实稿子验了:Jev 3/3 全出结果,DeepSeek 2/3,qwen3.8-27B **0/3 全空正文**。
3 篇全过,不叫可靠,叫没翻车。
它甚至略低。一致率 76%,DeepSeek 79%。它赢在三件事上——全出结果、快 10-100 倍、便宜。它是个裁判,不是选手。
有个细节我最想让你看,qwen3.8-27B 为什么交白卷。
我把 qwen3.8-27B 的 reasoning 抓出来看,原样贴你:它在那儿想"我们需要推断这些质检项含义……可能需要判断字段……"——1315 个 token 全烧在想"这题是什么意思"上,正文一个字没轮到。我把 max_tokens 从 700 加到 4000,再跑,76 秒,还是空。
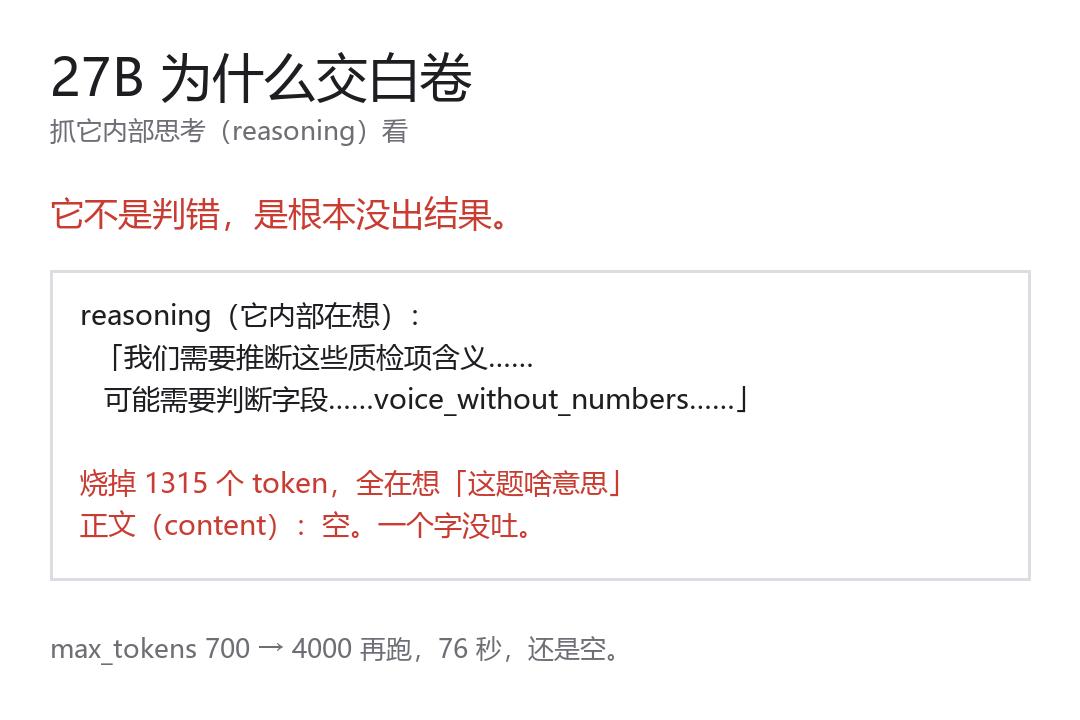
这不是它笨,是它**在判断题上犯了一个生成题模型的病**:它先要"理解、推理、组织语言",最后才吐答案;答案还没吐,额度烧光了。Jev 没这个病,它不生成,直接给概率。
那你怎么用?
我最想让你接的一个场景:**成稿质检闸**。
具体怎么接,我拿我们自己的流水线走了一遍:
**第一步**,装 Key。OpenRouter 注册,拿个 Key 存环境变量,走 `~typesafe/jev-latest` 这个端点。我实测通了,不贵,一次质检 $0.00009,你跑 1000 次才 9 分钱。
**第二步**,写你的质检项。我们用了 7 条:
```1. 盲读:把数字全涂掉,语气还像不像一个具体的人?(score 1-10)2. 脏话超限:全文"王八蛋"超过 1 个?(noul)3. 半文半白:有没有"之乎者也"混进口语?(noul)4. AI 腔:有没有"首先/其次/总之"三连?(noul)5. 炫识:有没有堆版本号/论文名?(score 0-1)6. 攻击三段式:有没有"引原话→真数据→短狠话"?(score 0-1)7. 递药落点:结尾有没有给读者下一步动作?(noul)```
**第三步**,把稿子全文 + 这 7 个问题,一次 POST 给 Jev。
```POST api.typesafe.ai/v1/systemone{"state": "","questions": [{"type": "score", "question": "涂掉所有数字后,语气还像一个具体的人吗?", "min": 1, "max": 10},{"type": "noul", "question": "全文出现'王八蛋'超过1次?"},{"type": "noul", "question": "有没有半文半白?"},{"type": "noul", "question": "有没有'首先/其次/总之'三连?"},{"type": "score", "question": "堆版本号/论文名的程度", "min": 0, "max": 1},{"type": "score", "question": "有没有'引原话→真数据→短狠话'三段?", "min": 0, "max": 1},{"type": "noul", "question": "结尾给了读者下一步动作?"}]}```
0.6 秒回来,7 个答案,每个带概率。哪条没过,回炉哪条。
**第四步**,qwen3.8-27B 干 Jev 干不了的活。
Jev 是裁判,它告诉你"第 6 项攻击三段式只有 0.45,没过"。但"怎么改"它不写——那是 qwen3.8-27B 的活。把 Jev 的 7 个分数 + 没过的那几条,丢给 qwen3.8-27B,让它改。改完再丢回 Jev 复检。
这就是分工:**Jev 判,qwen3.8-27B 改,循环到全过。**
我跑了 3 篇稿子,每篇 2 轮就全过了。第二轮 Jev 复检,0.6 秒,$0.00009。qwen3.8-27B 改稿子 30 秒,免费。一轮成本不到 1 分钱。
除了质检闸,还有两个场景能接:
**选题预筛**——拉 20 个候选选题,一次请求让 Jev 各打 3 个分(钩子/相关性/话题量),自动排出 Top5 再给人看。qwen3.8-27B 和大模型都不用碰,一次请求 0.6 秒搞定。
**上下文压缩**——给工具调用打分,决定保留/丢弃/截断。不是按长度砍,是按"这条对当前任务重要吗"砍。

三个场景,同一个 API,同一个 0.6 秒。
我卡哪了,也认。
第一,**它只答判断题。** 要"写点评"的活它干不了——那是 qwen3.8-27B 的活。Jev 是裁判,不登场。第二,**76% 的一致率,边缘项它也会判歪。** 比如第 16 期那个 v0.2.0 版本号,它判成"炫识"(0.52,卡在阈值边上),其实不算。这种边缘信号,闸的作用是**给你 30 秒人工判**,不是替你判。
它比你聪明吗?不比你聪明。
你的判断题,它闭着眼 0.6 秒做完。你的改稿,qwen3.8-27B 30 秒改完。两个搭一起,一轮不到 1 分钱。