国产AI都在憋大招吗 好像国产AI一直在暗处蓄力,等着一个石破天惊的瞬间。但从最近密集的动作来看,真正的“大招”未必是某一个碾压级的模型,而是几条线在同时逼近一个临界点。
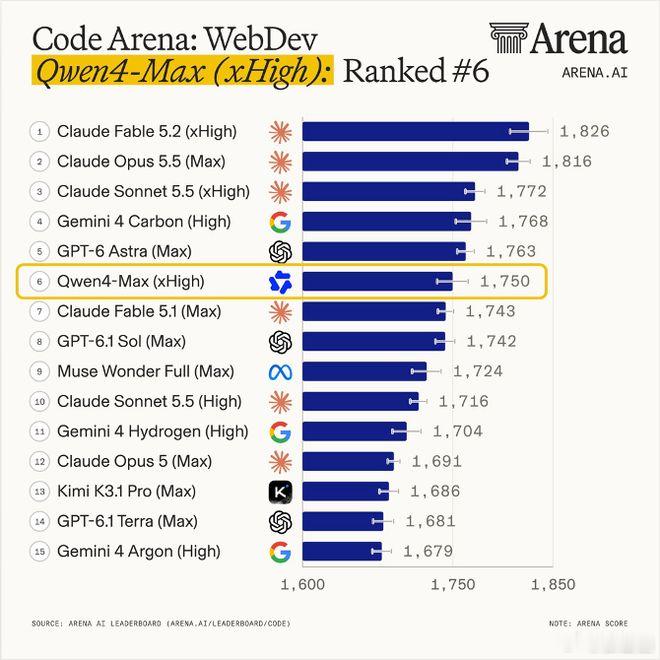
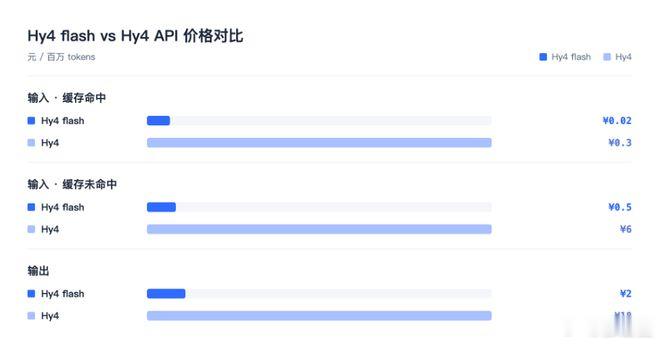
第一条线,是“把智能做便宜”的能力。阿里Qwen4-Max完成单任务的平均费用较上一代大降58%,腾讯Hy4 flash的单任务成本甚至只有DeepSeek-V4.1-Flash的八分之一。这背后不是简单的价格战,是架构效率的硬突破——Qwen4-Max用2.4T总参数只激活71B,每Token激活参数减少25%,专业编程评测里Token用量减半、得分反而从38.9分升到48.5分。
第二条线,是“国芯国模”从口号变成量产。 美团LongCat-2.5,1.6万亿参数,训练全程由国产算力完成,长上下文训练中单卡吞吐量提升86%,接近翻倍。科大讯飞星火X2.6首次在全国产算力平台上完成训练,代码和智能体长程任务能力实现重大突破。范式智能的Phai-A1在昇腾平台完成全流程训练优化,代码智能体任务上响应速度较Qwen 27B提升8到10倍,且支持在个人电脑本地部署。
第三条线,是Agent从“能聊”到“能交付”。 千问办公2.0让AI进入工作群、了解项目进展、按规则自动干活,甚至在电脑关闭后继续运行。百度文心闪电深度思考模型为搜索场景量身打造,连接智能体、调用工具完成复杂任务。商汤办公小浣熊累计服务人数已超2000万。下一个让人有感知的“大招”,大概率不是某个模型在榜单上多考了几分,而是你团队里那个AI同事,第一次不用你盯着就把活干完了。
第四条线,是开源生态的持续输出。 Kimi K3以2.8万亿参数成为全球最大开源模型,DeepSeek V4系列以MIT协议开放,阿里也宣布Qwen4系列中小尺寸模型将陆续开源。开源不是做慈善,是在定义下一代AI基础设施的默认选项。