一张显卡放不下大模型,为什么多张 GPU 就能跑起来?
AI大模型基础第81期:Tensor Parallel(张量并行)。
以一个 70B 参数的大模型为例,使用 FP16 精度,仅模型权重就需要约 140GB 显存,还没算 KV Cache、中间张量和运行时开销。
单张 24GB、40GB,甚至 80GB 显卡,都无法直接完整容纳。
怎么办?
答案之一,就是 Tensor Parallel(张量并行)。
它不是把不同请求分给不同 GPU,而是把同一层的权重矩阵拆开,让多张 GPU 协同完成一次计算。
比如一个 4096×16384 的权重矩阵,采用 TP=4,就可以拆成4份,每张 GPU 保存约四分之一的权重。
具体怎么计算?
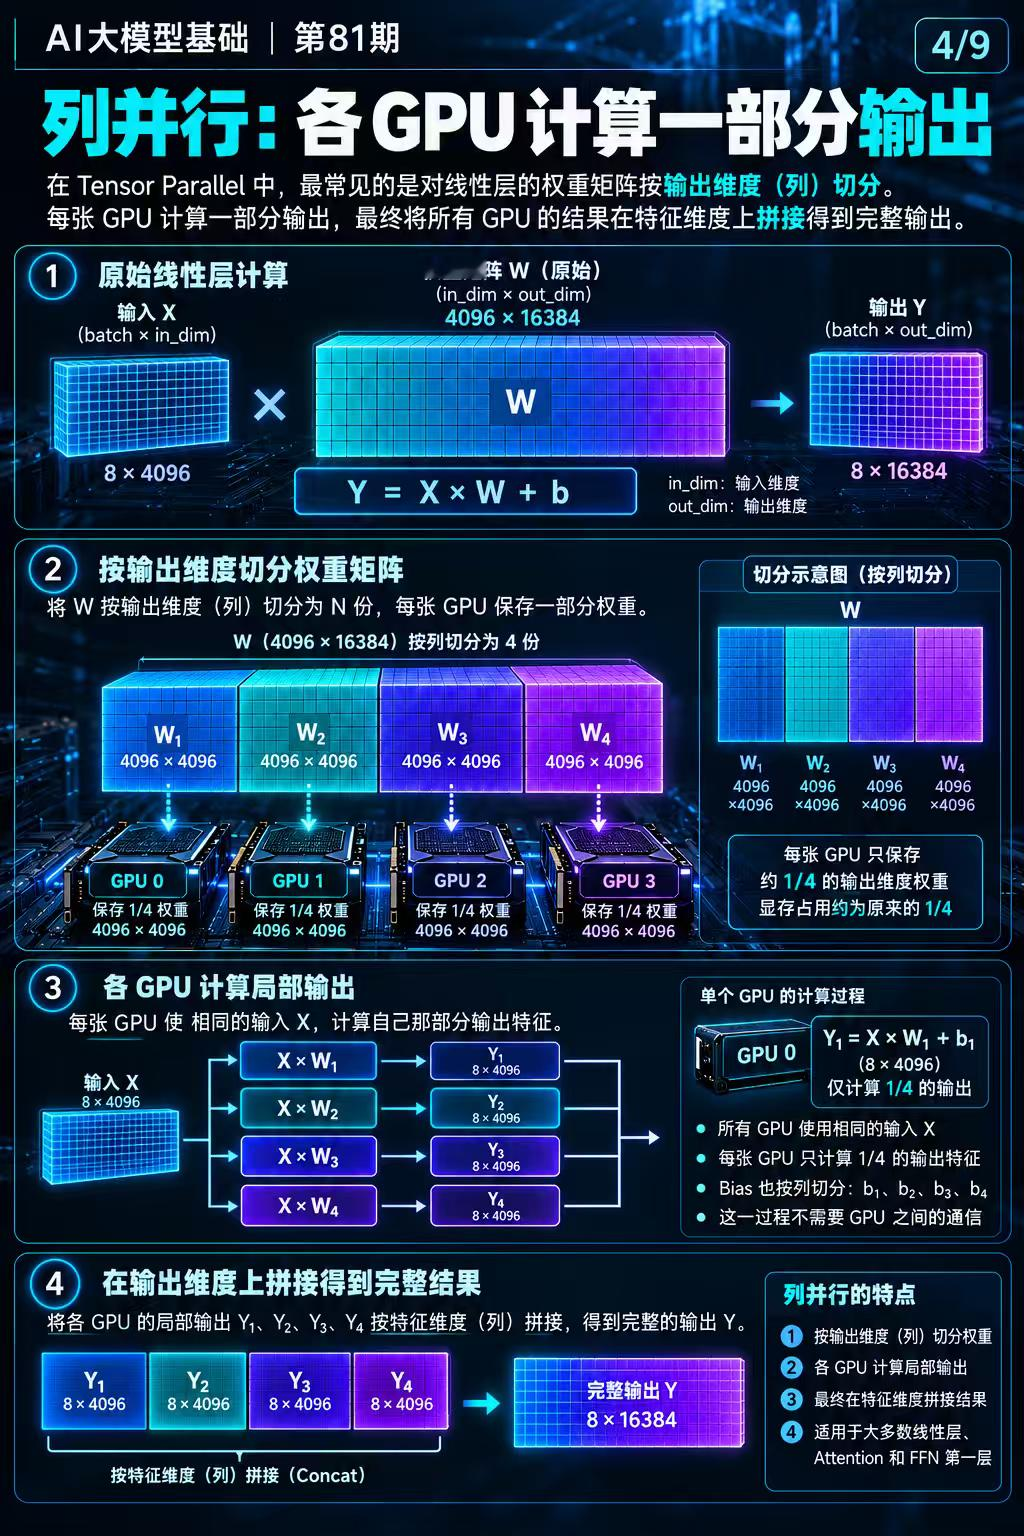
第一种:列并行(Column Parallel)
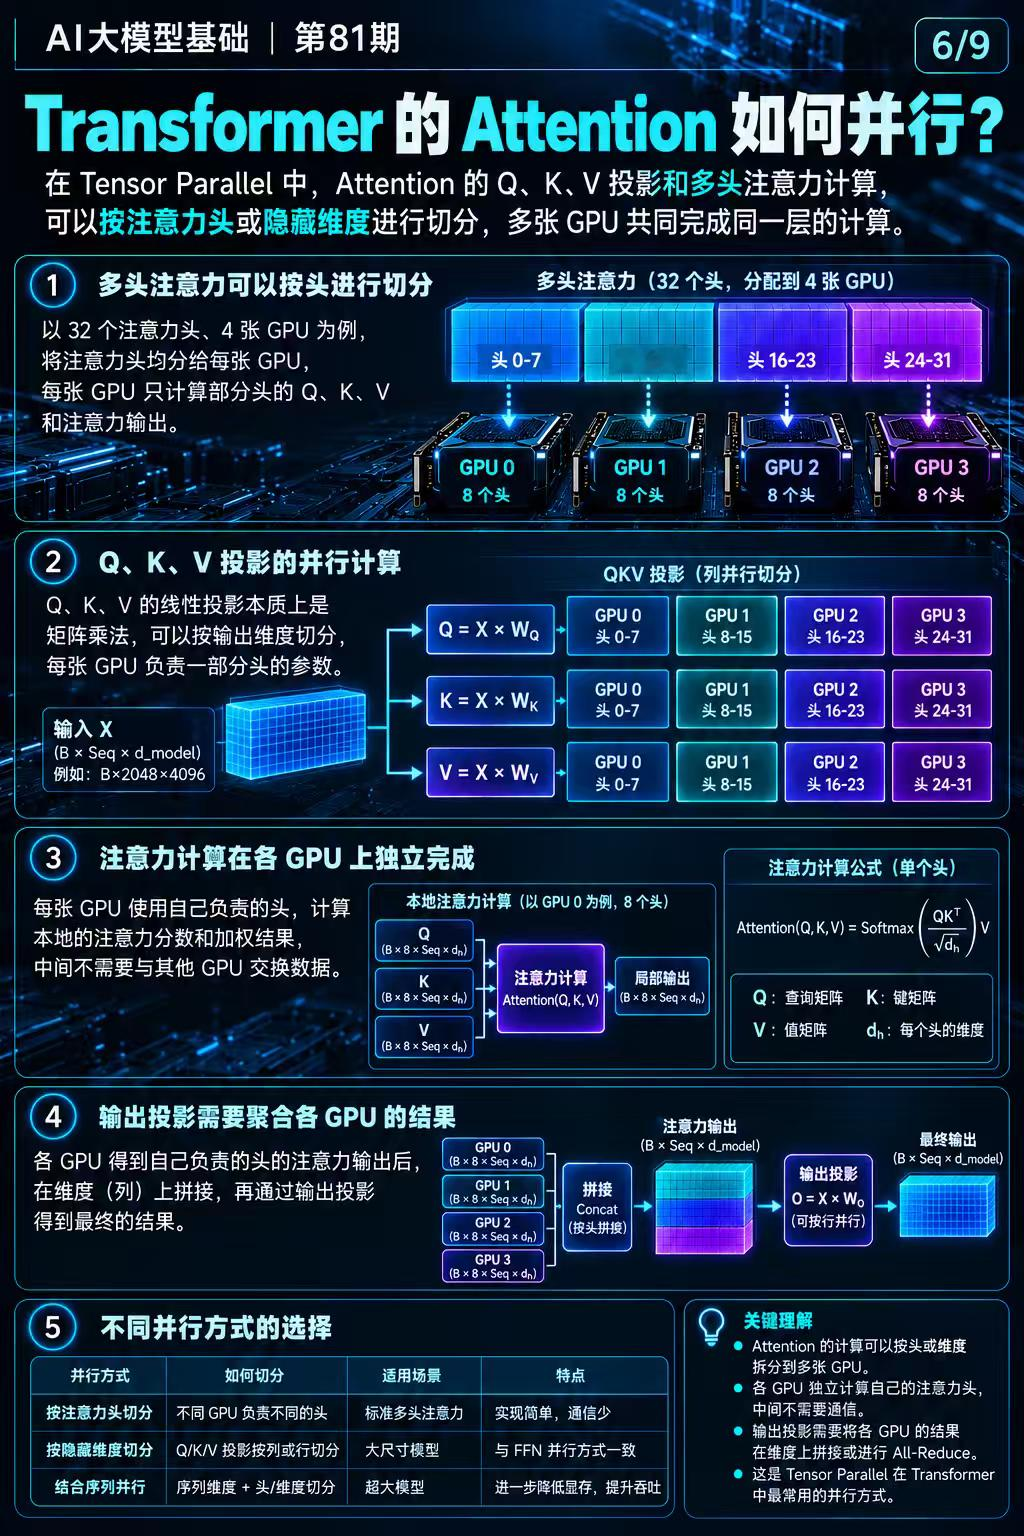
把权重按输出维度切分,每张 GPU 接收相同输入,分别计算一部分输出,最后按需拼接。
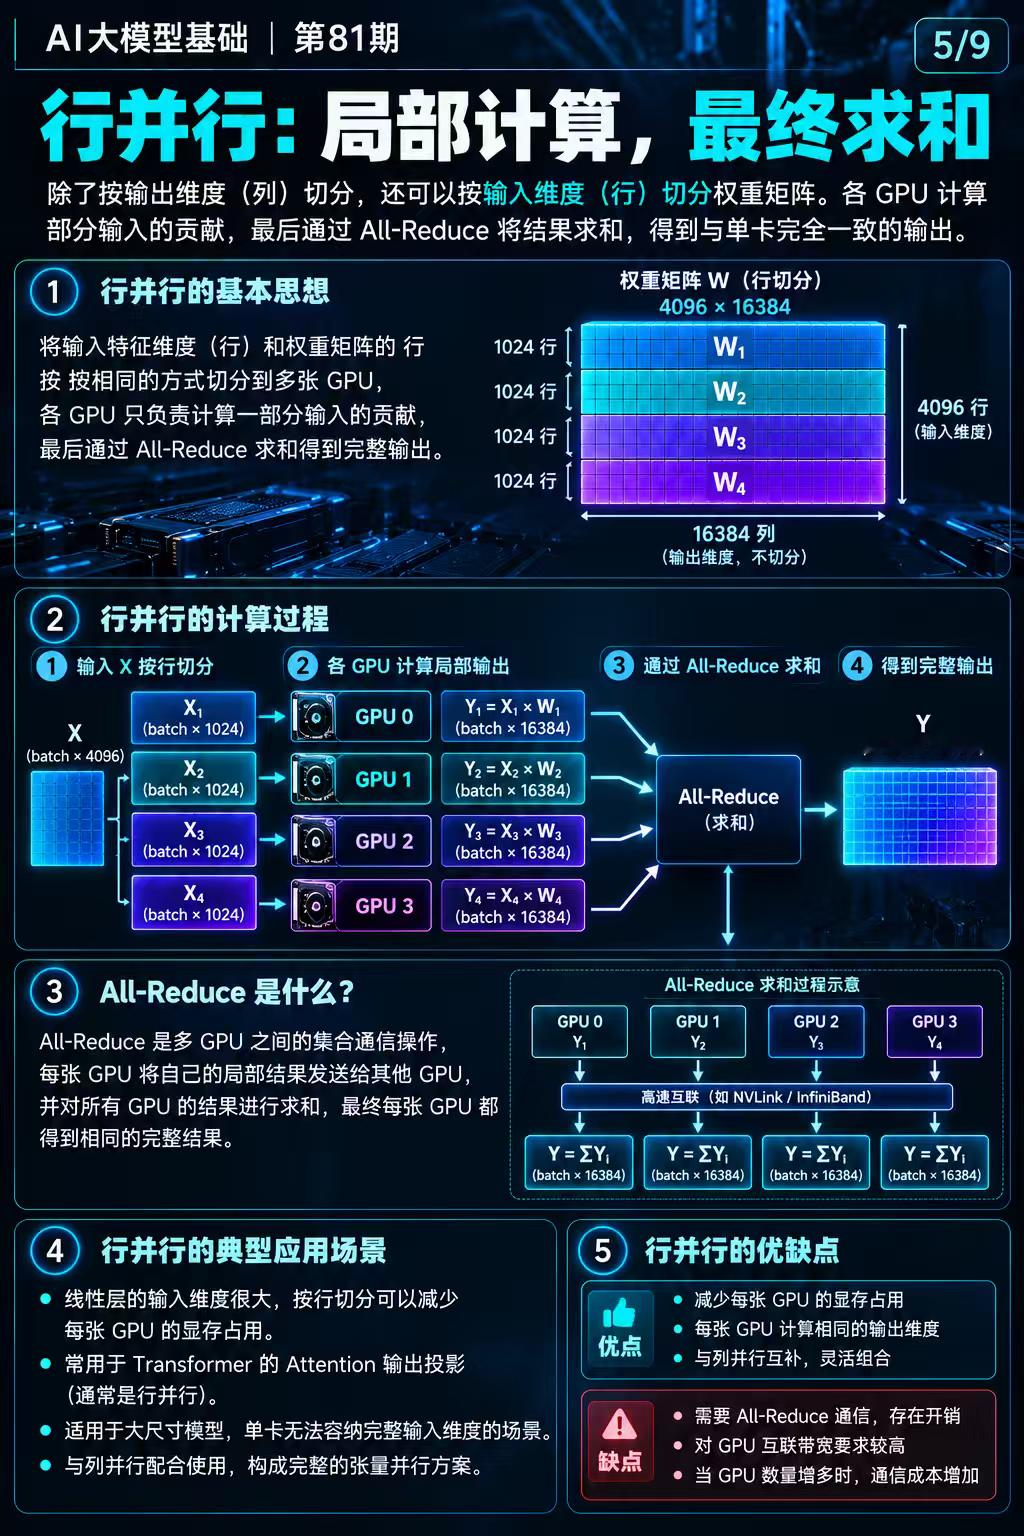
第二种:行并行(Row Parallel)
把输入特征和权重按输入维度切分,每张 GPU 计算部分结果,最后通过 All-Reduce 求和,得到完整输出。
在 Transformer 中,这两种方式通常配合使用。
Attention 的 Q、K、V 投影可以采用列并行,不同 GPU 处理不同注意力头。
Attention 输出投影通常采用行并行。
FFN 也类似:第一层列并行,激活函数在本地计算,第二层行并行。
但有一个问题:
GPU 越多,推理就一定越快吗?
不一定!
Tensor Parallel 虽然降低了单卡显存压力,也能分摊计算,但 GPU 之间需要频繁通信。
All-Reduce、网络带宽、通信延迟,都可能成为新的性能瓶颈。
这也是为什么 NVLink、InfiniBand 等高速互联在大模型部署中非常重要。
记住一句话:
Tensor Parallel 解决的是“同一层怎么让多张 GPU 一起算”,不是简单地增加显卡数量。
真正的性能提升,需要在模型规模、并行度、通信开销和硬件拓扑之间找到平衡。
下一期,第82期:Pipeline Parallel(流水线并行)——如果不拆同一层,而是把 Transformer 的不同层分配给不同 GPU,又会发生什么?
关注我,系统学懂 AI 大模型底层原理。
AI大模型基础 TensorParallel 张量并行 Transformer 大模型推理 GPU AI技术科普 大模型部署