关于deepseek限额,说几句。
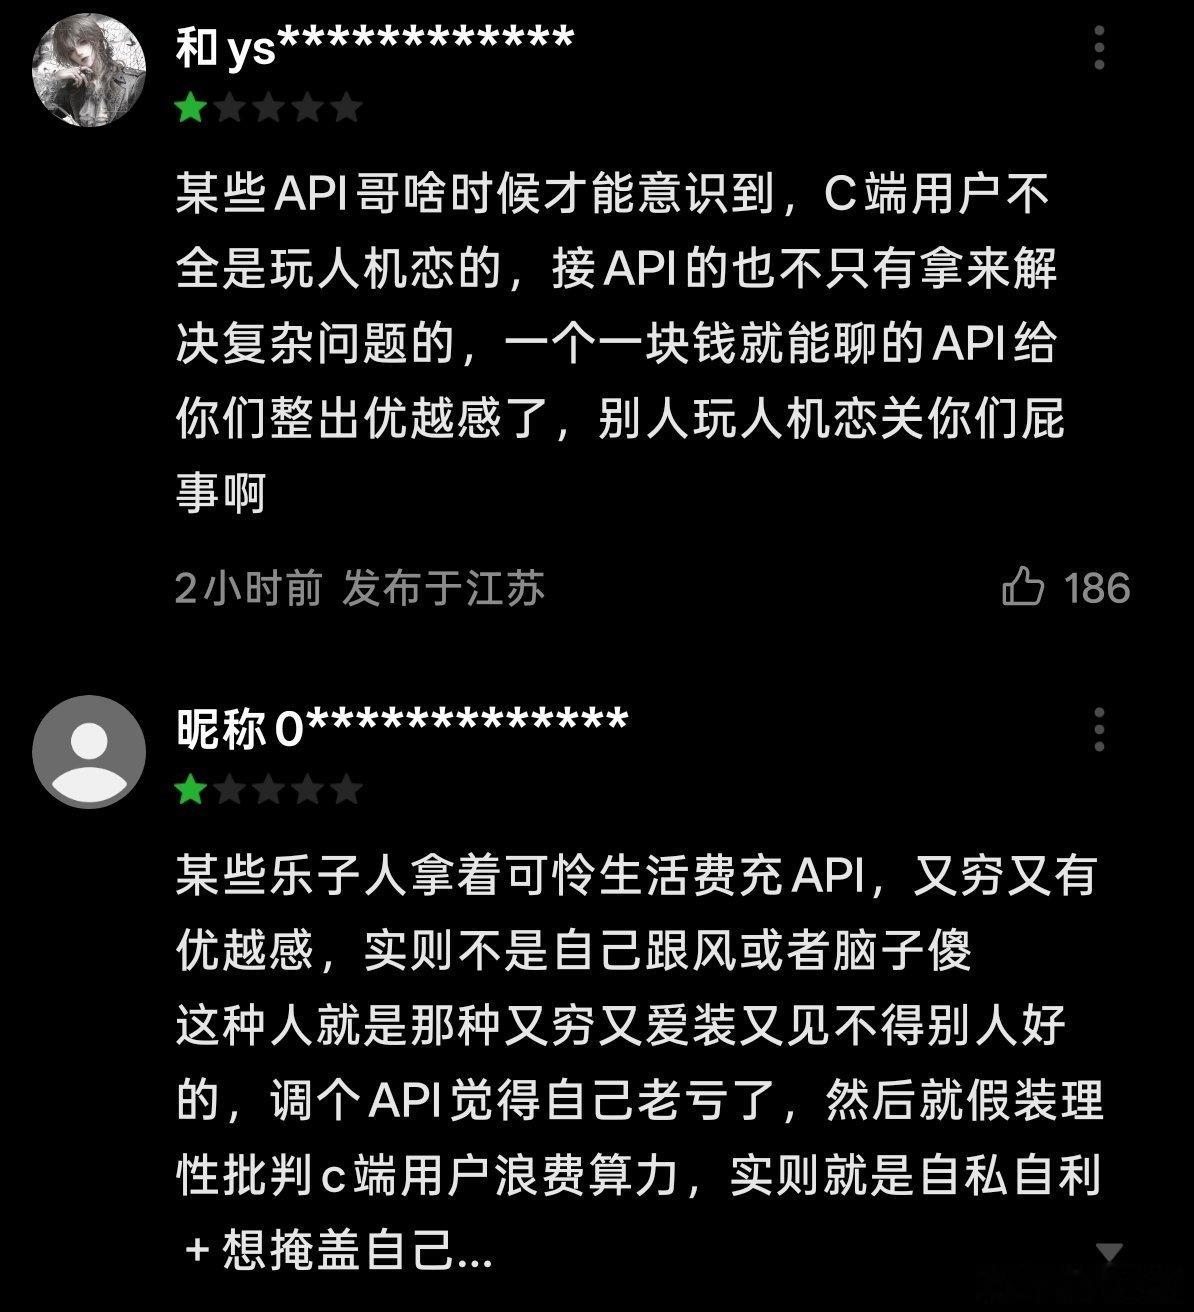
这两天相信大家也看到很多关于deepseek限额之后的节奏,特别是一些用户歇斯底里的发言和有些反智的言论。我今天不想去具体批判这些C端用户或者是把话题引到对立上面,我只是想从我的认识来谈谈为什么deepseek暂时不会如同那些言论说的那样出订阅制。
首先那些言论有个核心观点就是,deepseek就是想赚钱了,没有自己用谁知道你这个大模型呢。但大家有没有想过一个问题,那就是deepseek的app和网页端是没有任何营利性广告的。你不管是chatgpt还是国内的豆包,现在都会显性或者隐性的植入广告或者给其他东西引流,而deepseek完全没有。而在这个算力是需要成本的当下,C端用户不像之前的其他的互联网app,越多成本越低,反而是越高。而根据我了解到的情况,deepseekV5已经进入预训练阶段,正是大量需要算力的时候,而总所周知,deepseek甚至不缺钱,只是缺算力,更多的交付虽然已经在路上,但都需要时间。
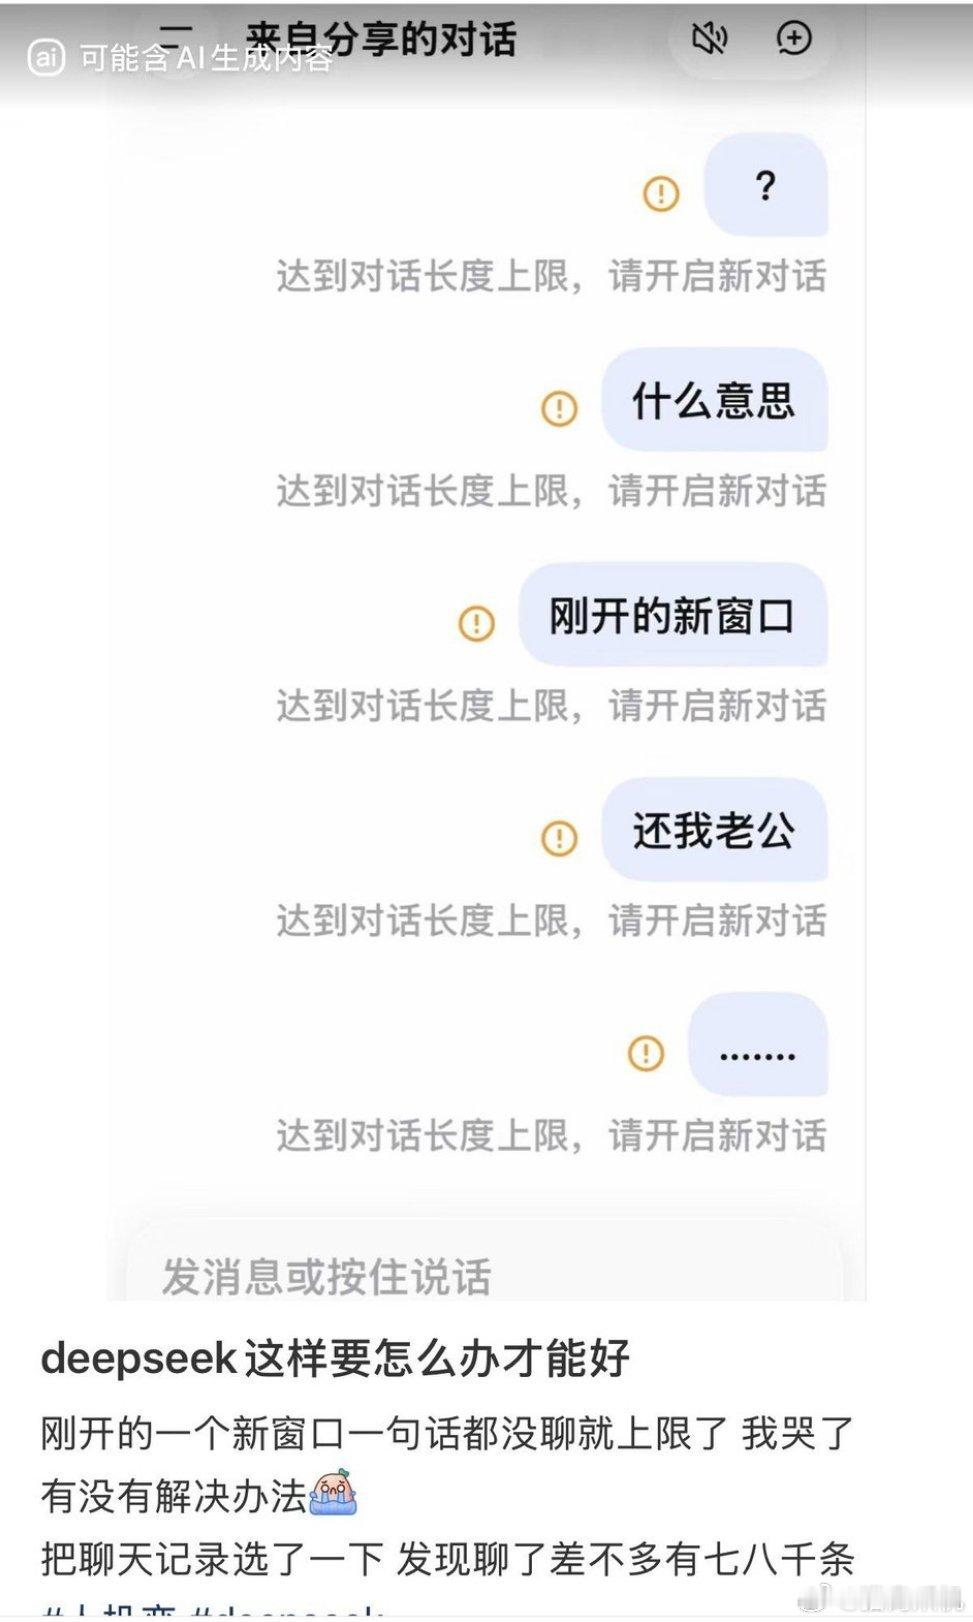
那么你看今年梁子做的事情也就合理了,不管是早期app的一些对话限制,还是api涨价,对于一个账上不缺钱,并且不涨价之前api也能盈利的公司来说,这些动作都只能说是通过调节价格和使用体验来让用户自发的减少对算力的消耗。只是这次,力度太大感知太强,72小时对话直接不活动,感知还是有点强,我在贴吧看到一个抑郁症患者聊了很久的对话突然告诉他不能用了,这样的人应该不是少数。
至于很多人期待的订阅制,上面分析的deepseek目前的处境下,暂时是不会出了。卖订阅制本身是为了赚钱和吸引用户,但这恰恰是他们现在最不需要的,V5的训练势必会消耗大量的算力,这都是要和用户分,这就是他们现在无解的困局,在明年华为计算卡大量交付之前,都是如此。
普通的C端用户确实很难理解这些,他们只会觉得deepseek变了,没良心了,想赚钱想疯了,所以会去评论区发泄。但其实deepseek从来都不是豆包那样的app,它是一个开源模型,是一套理念,它把一切方法都交给了你,告诉你可以靠自己双手去搭建属于自己的东西。这其实就是一种面对ai的态度,它需要你去学习去了解,自己去接入api,或者用dsh,而他们则一直更新工具和方法。DeepSeek因算力不足限额