CoReMem:让Coding Agent的记忆真正省步骤!
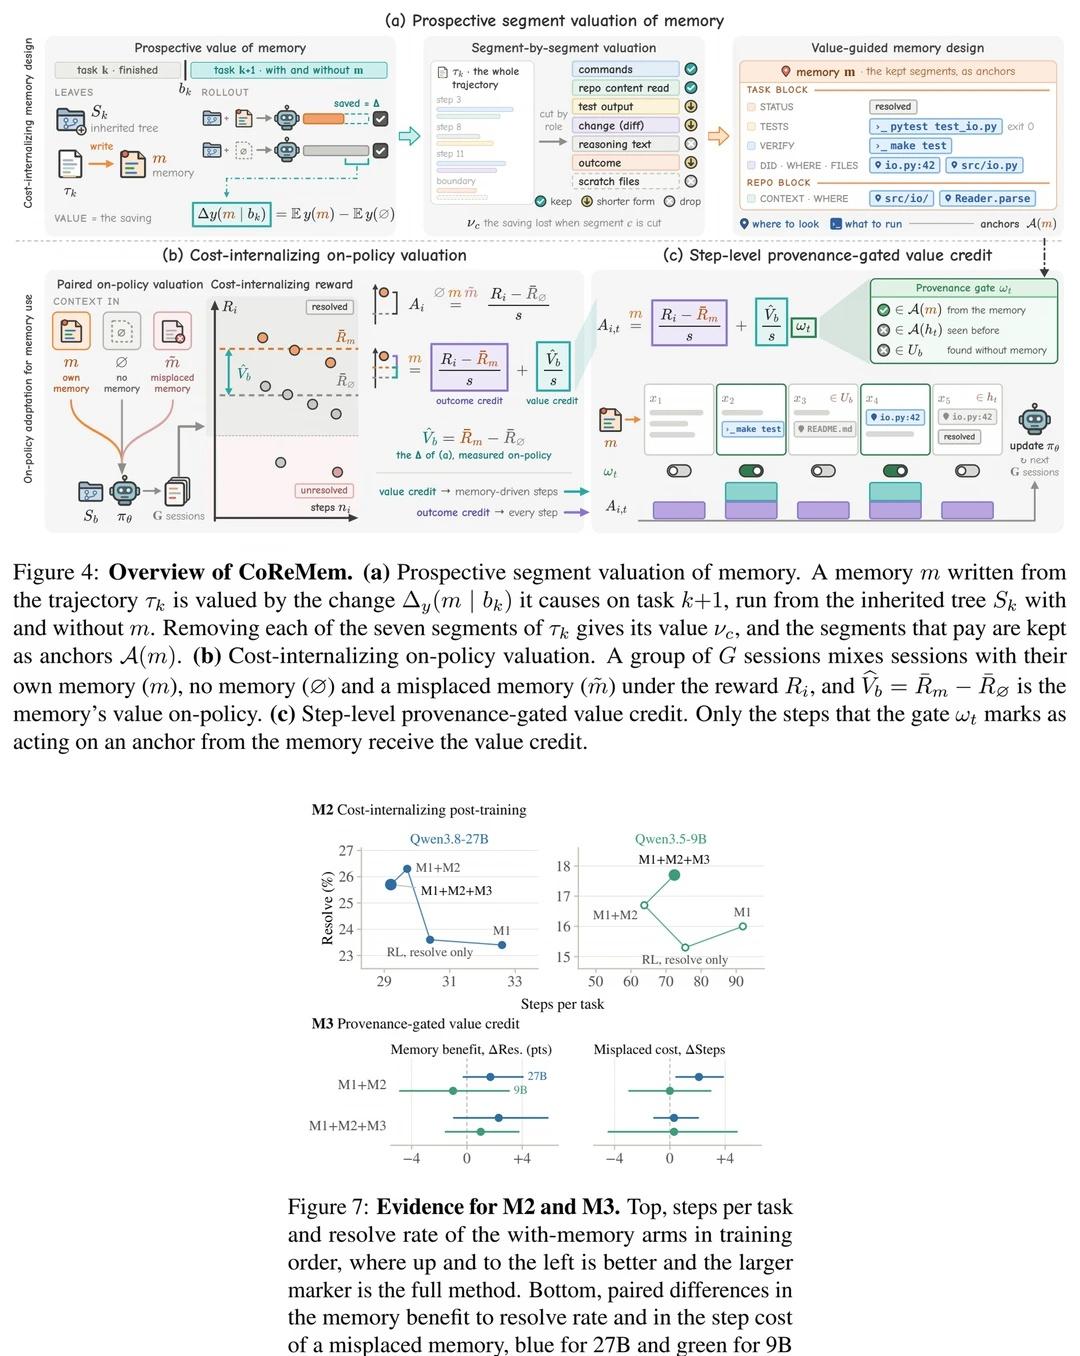
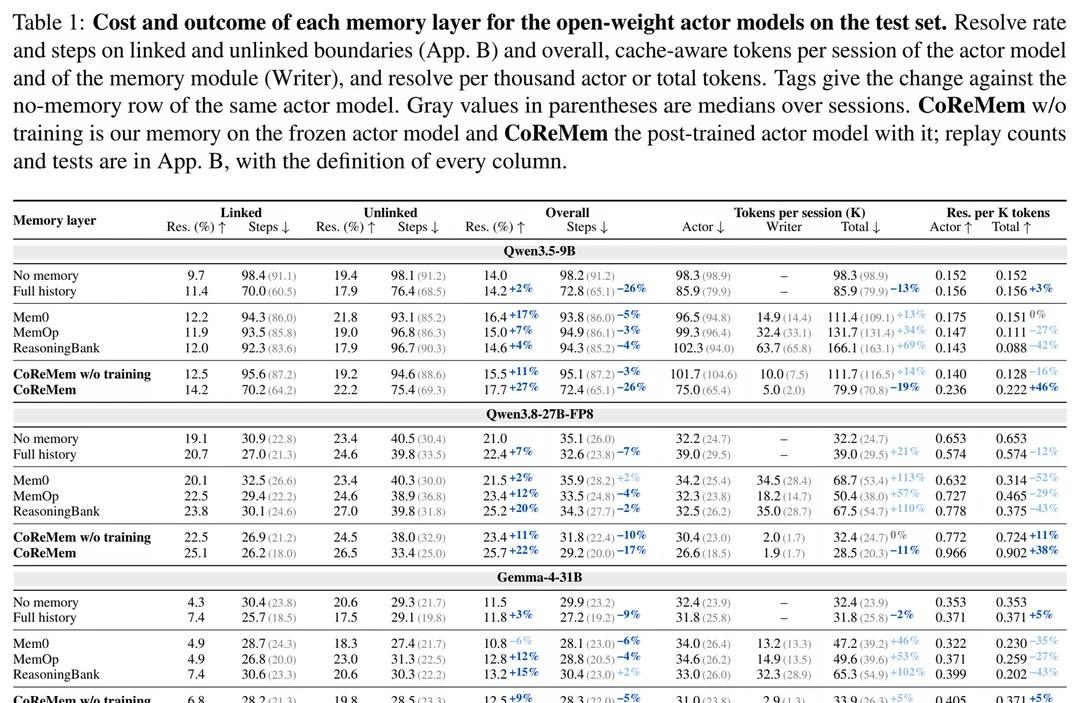
Coding Agent 连续修改同一仓库时,记忆写得多不一定省成本。耶鲁提出CoReMem 框架,在相同继承状态下,对比下一任务有无记忆的执行,筛出代码位置与可运行检查,再训练代理按实际收益使用这些锚点。ChainSWE上,27B模型解决率从21.0%升至25.7%,增加4.7个百分点;步骤减少17%,包含记忆模块调用的缓存感知总Token减少11%,支持了“记忆内容与使用行为需要共同优化”的判断。
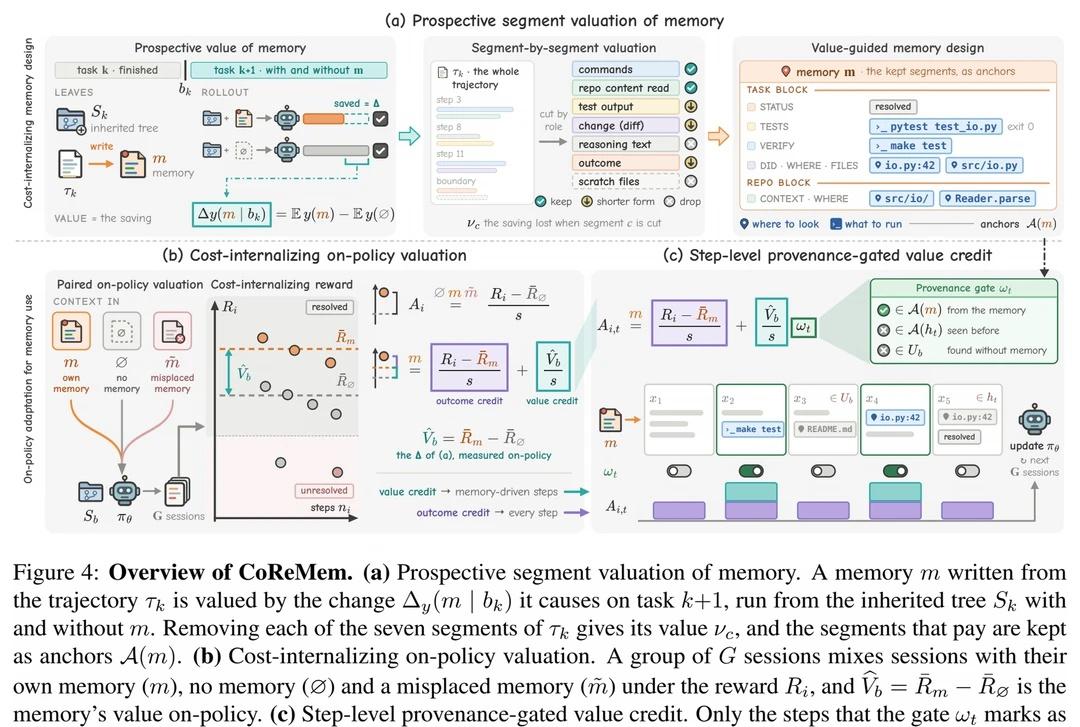
用下一任务的收益决定记什么:
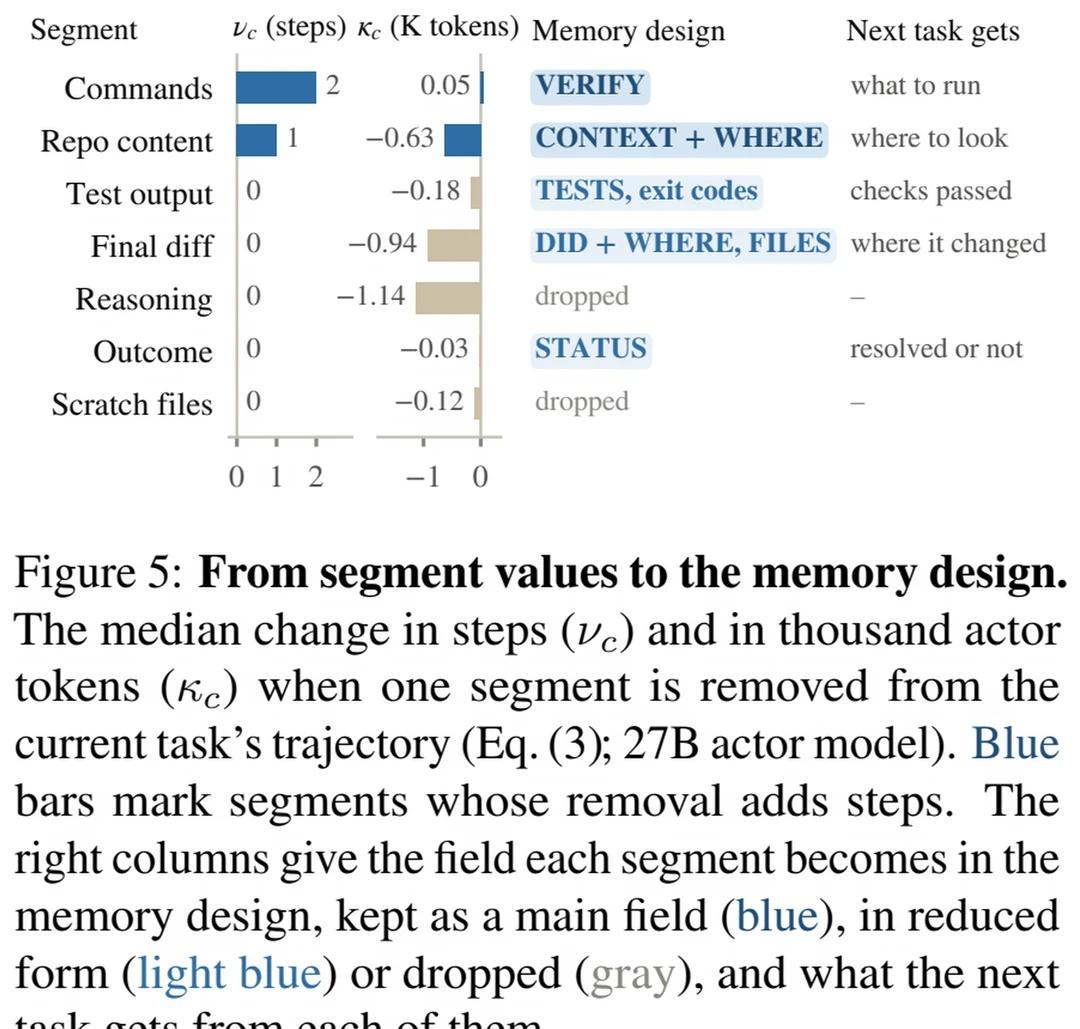
下一任务尚未发布,当前任务的总结质量无法直接代表未来价值。作者在训练边界上,把轨迹分成命令、仓库内容、测试输出、最终修改、推理、结果、临时文件七类,逐类删除,再从相同仓库状态执行下一任务,测量步骤与Token变化。删除命令和仓库内容分别增加中位数2步、1步,删除推理文本不增加中位数步骤,并节省1.14K Token。由此把轨迹压成“任务块+仓库块”,主要留下路径、符号、检查命令及退出码,缩写修改和结果,丢弃推理叙述与临时文件。组装后的记忆仅用完整轨迹6%的字节,保留其中位数步骤收益;这支持保留可执行线索,而非完整叙事。
把记忆收益分给真正使用它的步骤:
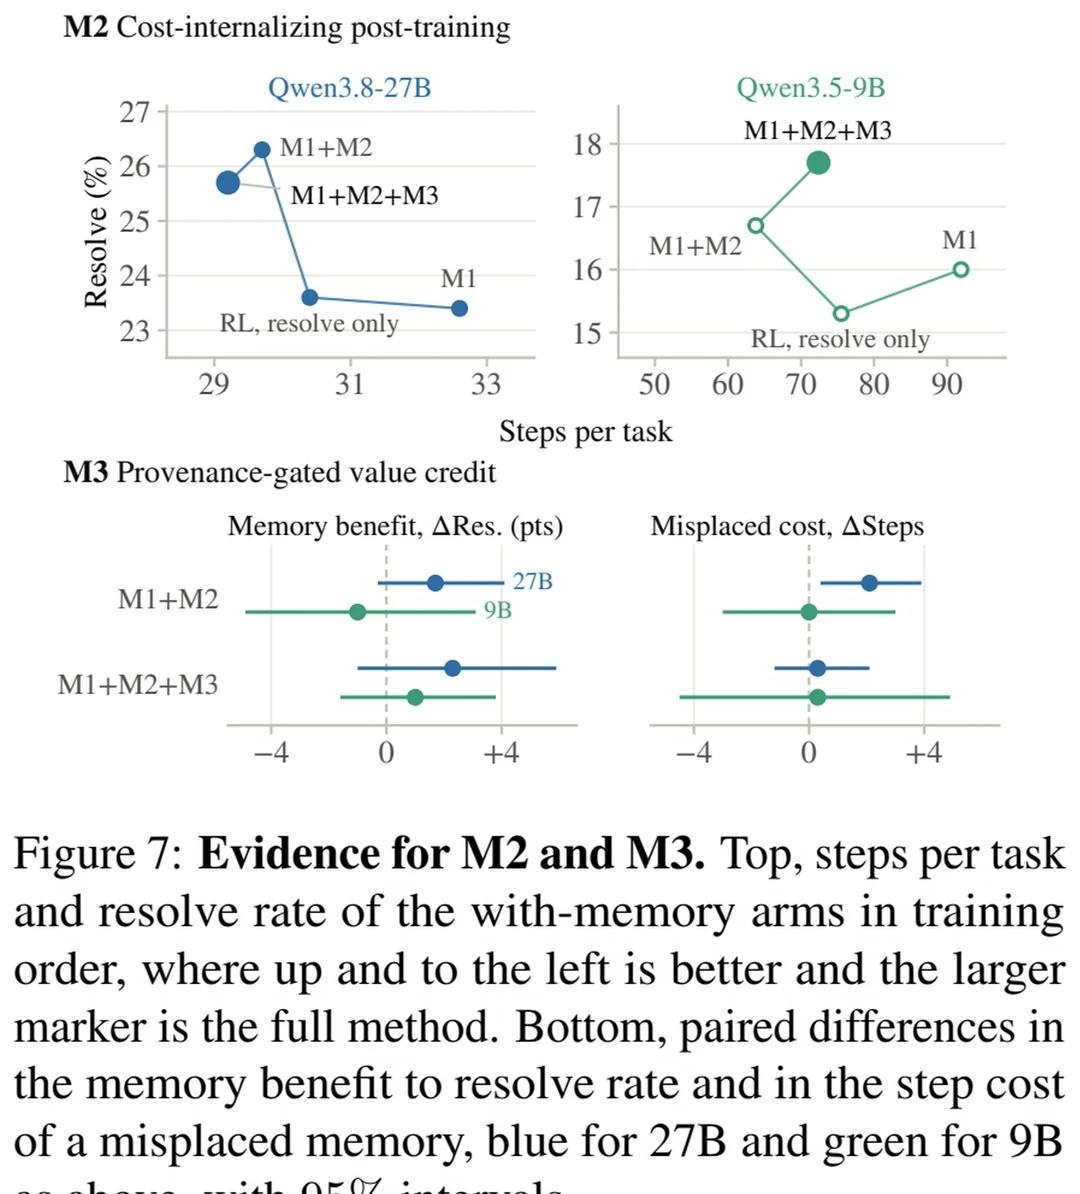
有记忆不等于会用。训练把正确记忆、无记忆、其他仓库的错置记忆放进同组执行;reward保证成功优先,只在成功轨迹内扣步骤,再用有无记忆的平均奖励差估计当前策略下的记忆价值。所有步骤保留结果reward,额外价值仅分给首次使用记忆锚点、且无记忆执行早期未发现该锚点的步骤。门控标记可追踪使用,不证明单步因果贡献。27B消融中,加入门控后错置记忆额外步骤从2.1降至0.3,记忆带来的解决率收益从1.7增至2.3个百分点;但完整方法并非在每个模型上都最省步骤。
关键结果:
27B总Token由32.2K降至28.5K,已计入记忆写入成本;仅接入记忆、未经训练时为32.4K,说明节省并非只靠压缩文本。三种开源权重模型的每Token解决效率平均提高41%。主要实验限于Python仓库,后训练仅覆盖三种模型;论文未报告墙钟延迟或能耗,长期记忆累积与刷新仍待验证。
智能体 CodingAgent 智能体记忆 CoReMem 大模型论文