中科曙光敲警钟:集群规模越大,可能浪费越大!
“卡越多,算力越强”,这句话到了万卡、十万卡阶段,差不多该过期了。
昨天北京参加超级算力大会,现场发布的《万卡级智算集群网络技术发展与国产化研究报告》,给国内万卡建设潮泼了一盆很有必要的冷水:MoE模型进行大规模专家并行训练时,网络通信可能占整体训练时间的30%至50%。如果卡有接近一半时间都在等数据,规模越大,不是优势越大,而是浪费越大。
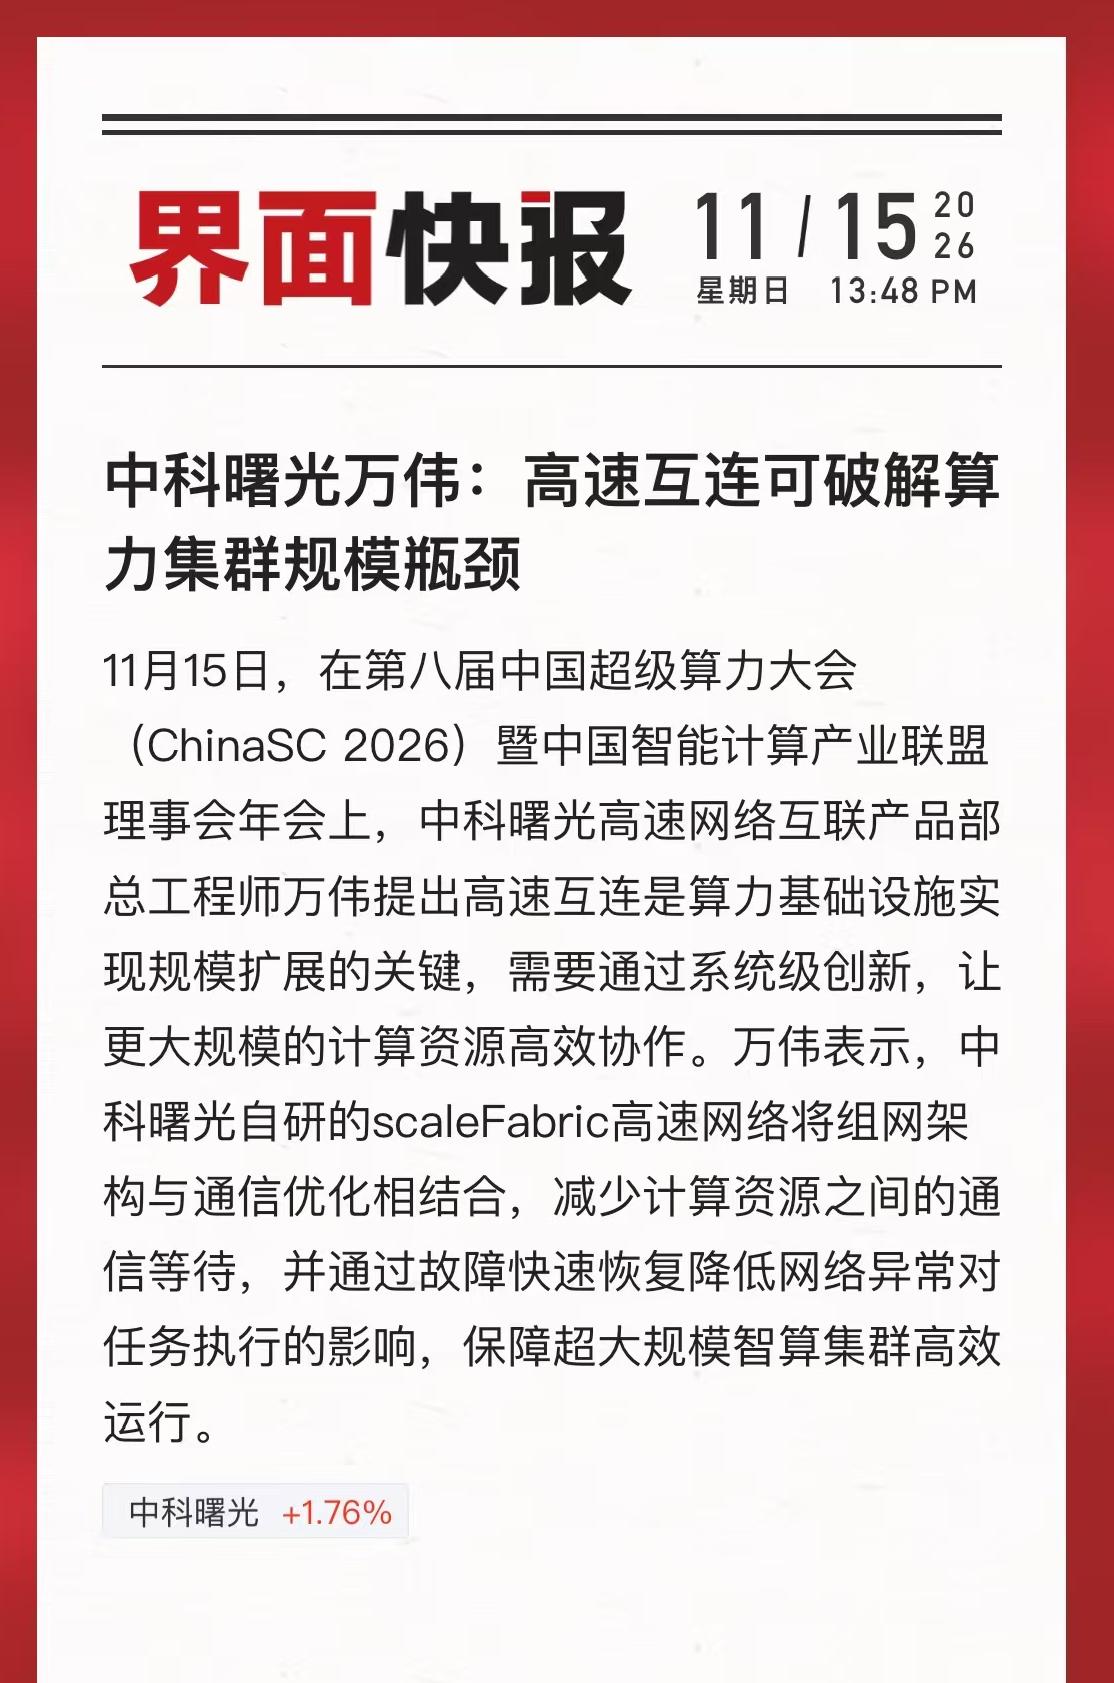
现场听万伟拆解曙光8000,我觉得最值得讲透的不是十万卡,而是它如何压缩这部分等待。
通过Scale-up,让频繁交换数据的计算单元靠得更近,减少跨节点通信;再通过scaleFabric完成Scale-out扩展。其400G原生无损RDMA网络,单一子网可覆盖超过11.4万卡,避免十万卡被切成大量小网络,少走几层转发,也减少一层管理复杂度。
网络把卡组织起来,ParaStor分布式存储和FlashNexus集中式存储再把数据及时送到计算侧;Fabricview负责网卡的配置、监控和故障恢复。万卡级报告把曙光8000列为典型案例,看中的正是这条完整链路。
全国已有42个万卡级智算集群,接下来最怕的不是项目不够多,而是出现一批卡数惊人、效率平庸的“虚胖集群”。
卡数可以买,利用率买不来。能让十万卡少等待、多计算,才算真正过了万卡这一关。
超级算力大会 有效算力 曙光8000中科曙光