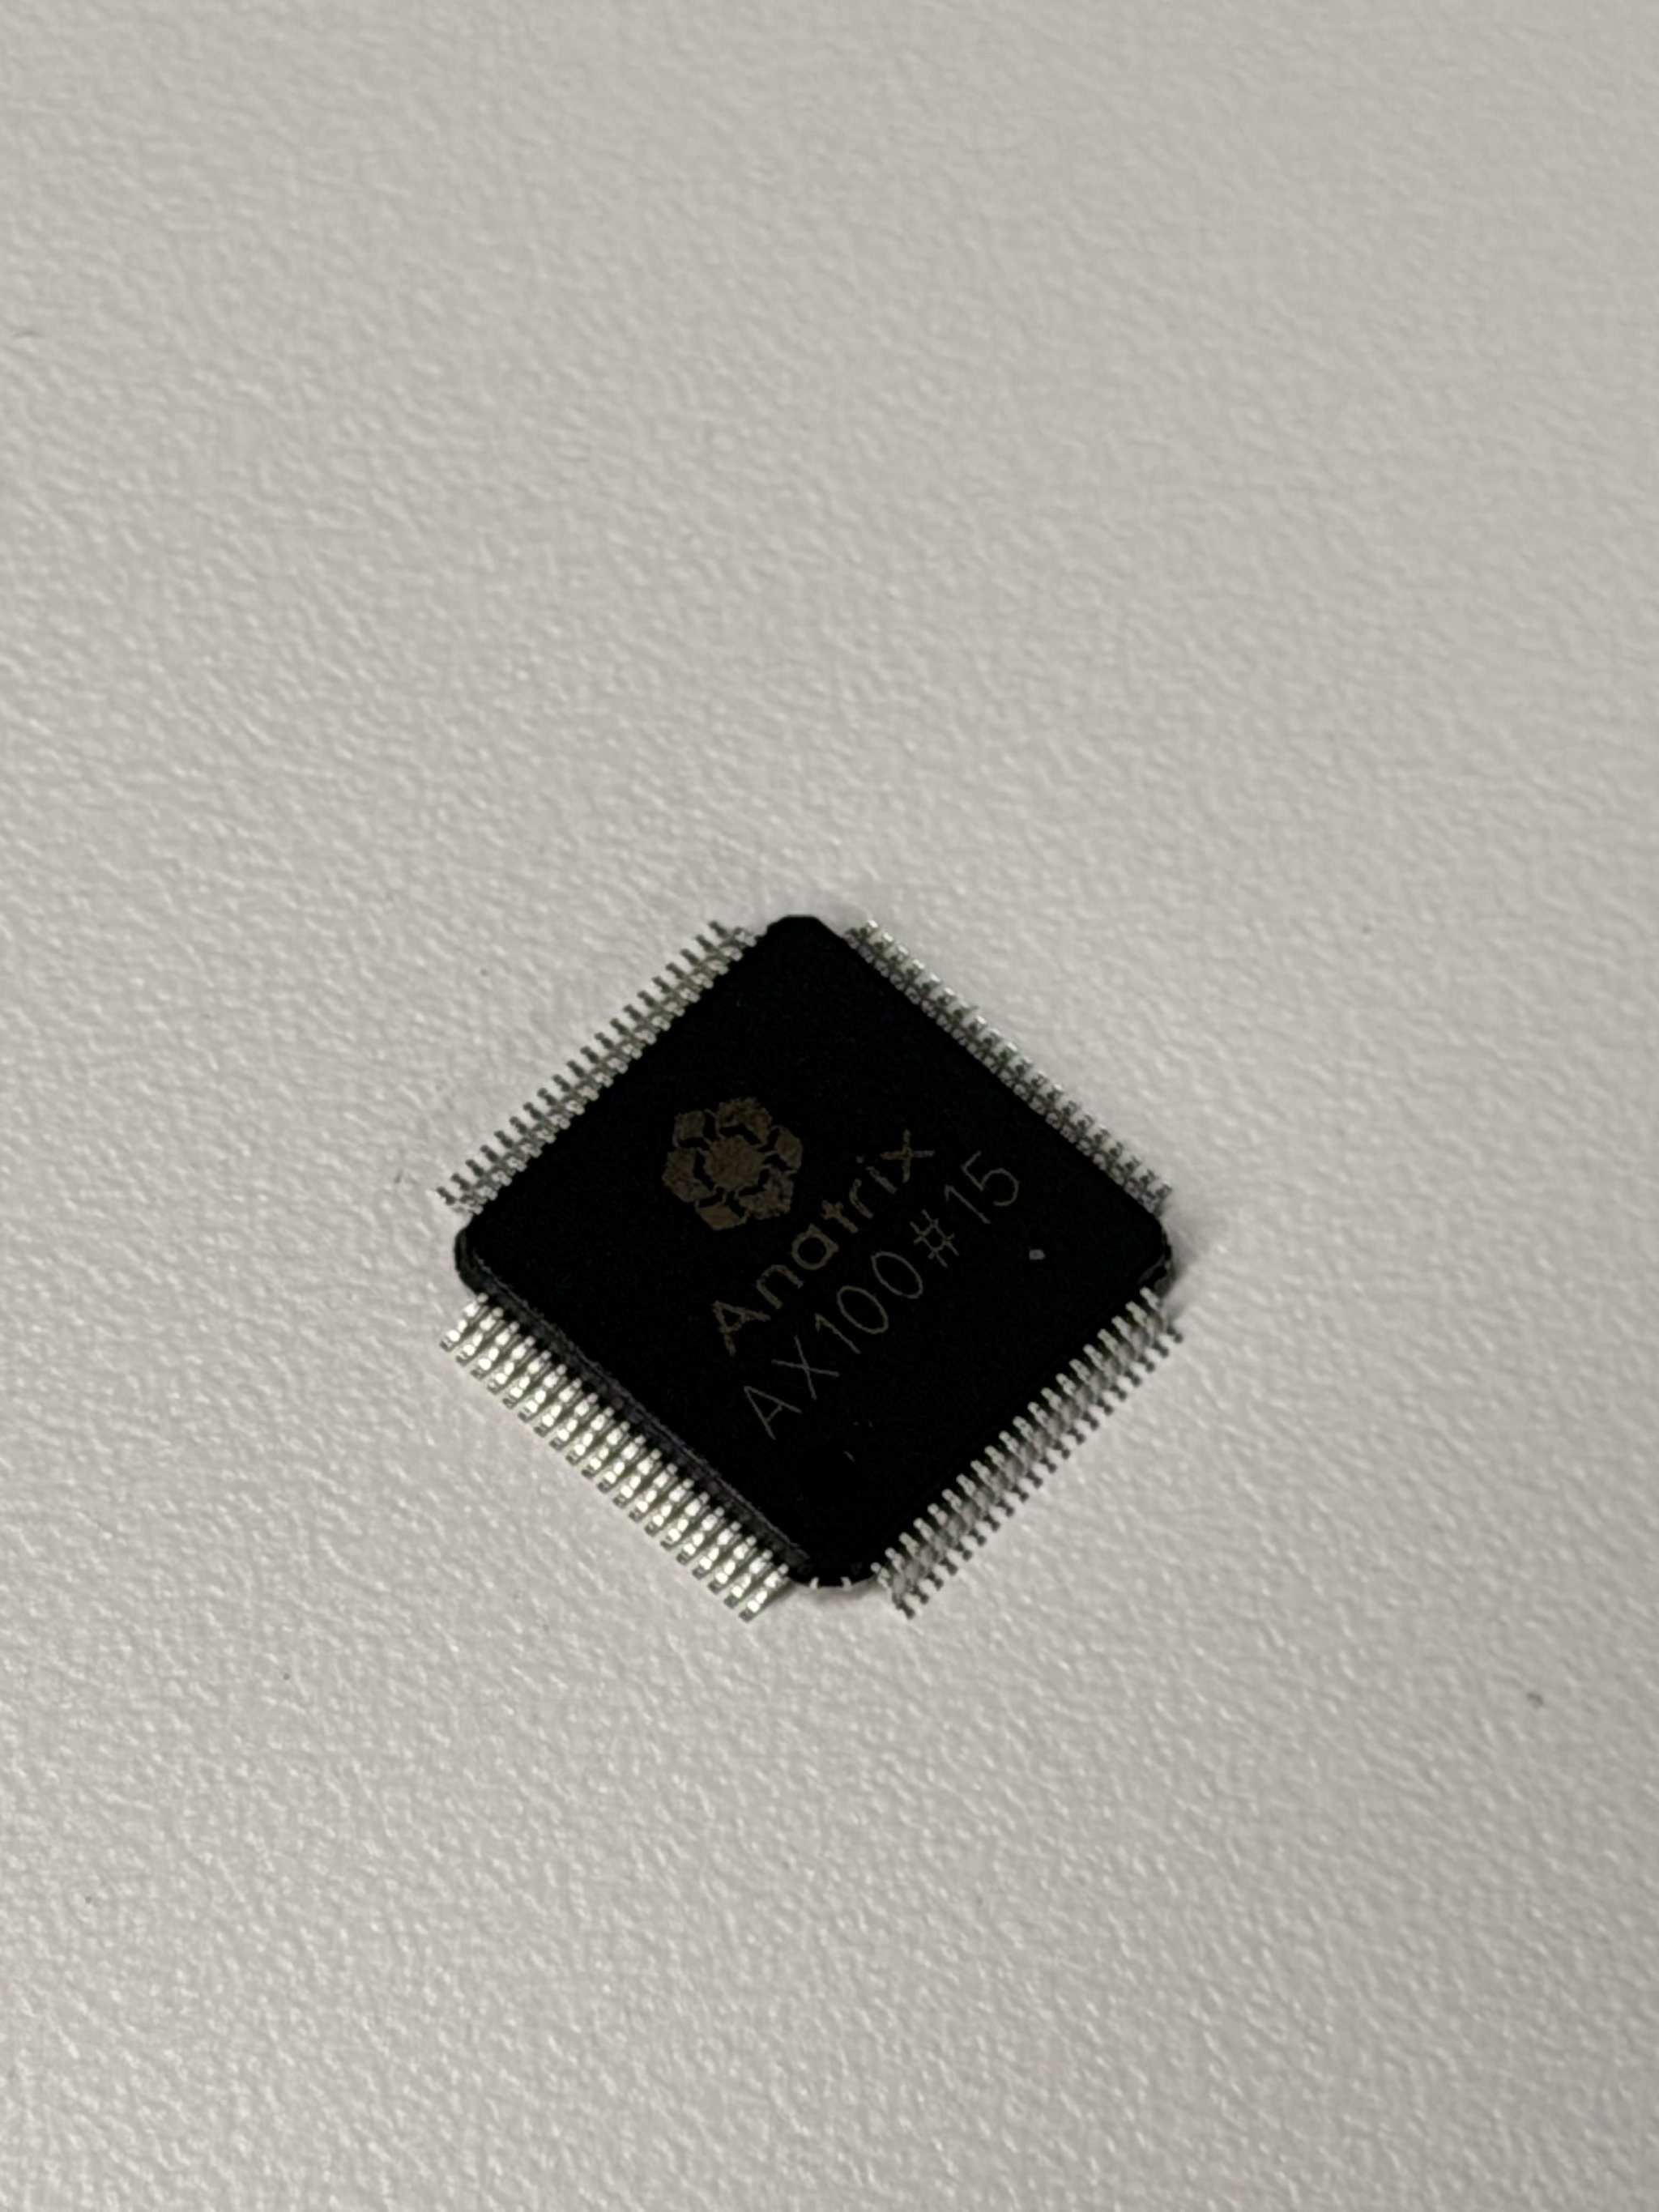
世界首颗全集成一步求解矩阵方程模拟计算芯片,国产安纳智芯AX100芯片!
单次求解不到100纳秒,功耗只有约80毫瓦,还不依赖先进制程。上述性能均为流片后测试数据,不代表已量产商用。
这颗芯片是2026年11月15日由科技日报报道披露的,安纳智芯自主研发的AX100已在2026年10月完成流片。流片可以理解为芯片从设计图纸变成实物的第一次试生产,说明设计已经在真实工艺上跑通,但还不等于已经量产。
技术源头来自北京大学人工智能研究院孙仲团队。2025年10月,他们在《自然·电子学》发表论文,把模拟计算精度从此前的百分之一量级提升到千万分之一量级,对应论文中的24位定点精度,相对误差可低至10⁻⁷量级,解决了模拟计算长期“算得快但算不准”的难题。
我们平时看到的AI大模型训练、机器人控制、通信信号处理,底层很多任务都在解复杂的矩阵方程。传统数字芯片像拿着计算器一遍遍乘加迭代,512阶矩阵方程大约要算5亿次,耗时几十到上百微秒。AX100则把矩阵方程直接映射成电路,电路自平衡后一次读出结果,不需要反复迭代。简单说,就是让物理电路“自己算完”。
它的全球领先优势很集中:
世界首颗全集成一步求解矩阵方程模拟计算芯片,首次把高精度模拟计算从实验室推向产线。
单次求解时间小于100纳秒,单次功耗约80毫瓦,速度比传统数字迭代方式快得多。
不依赖先进制程,采用成熟工艺即可实现全链路自主可控。
在128×128信道格拉姆矩阵场景下,等效吞吐较现有数字ASIC/GPU提升20至207倍,等效能效提升27.6至61.3倍。
在具身智能场景下,机器人运动控制与规划端到端算法提速150%至500%,三维重建与SLAM核心算法环节提速200%至500%。
在大模型训练验证中,293万参数Autoencoder模型和272万参数Transformer模型的训练更新消耗分别减少92%和56%。
需要说明的是,AX100不是通用GPU,也不是要替代所有数字芯片。它更像专门啃“矩阵方程求解”这块硬骨头的协处理器,未来更可能和现有数字算力协同工作。
从全球对比看,国外也有模拟矩阵计算探索,但AX100面向的是更难的矩阵方程求解,并且已在国内成熟工艺下完成流片验证。这意味着国产算力在“不唯制程”的新路线上拿到了先发机会。
当然,流片成功只是第一步。后续还要看量产良率、长期稳定性、软件工具链和真实客户场景验证,不能把当前测试数据直接理解成已经大规模商用。
但它的方向价值很清楚:当全球算力都被功耗、成本和制程约束卡住时,中国团队用“物理电路换算力”的思路,为不依赖先进制程的算力路线提供了新验证。
图为安纳智芯 AX100 芯片的流片测试样品(Anatrix AX10015)实拍照片。该芯片于2026年10月完成流片,是目前全球首款全集成一步求解矩阵方程的模拟计算芯片。图片来源:科技媒体及网络公开披露的国产芯片AX100流片实拍图,本文章仅作科普技术交流与事实说明使用。