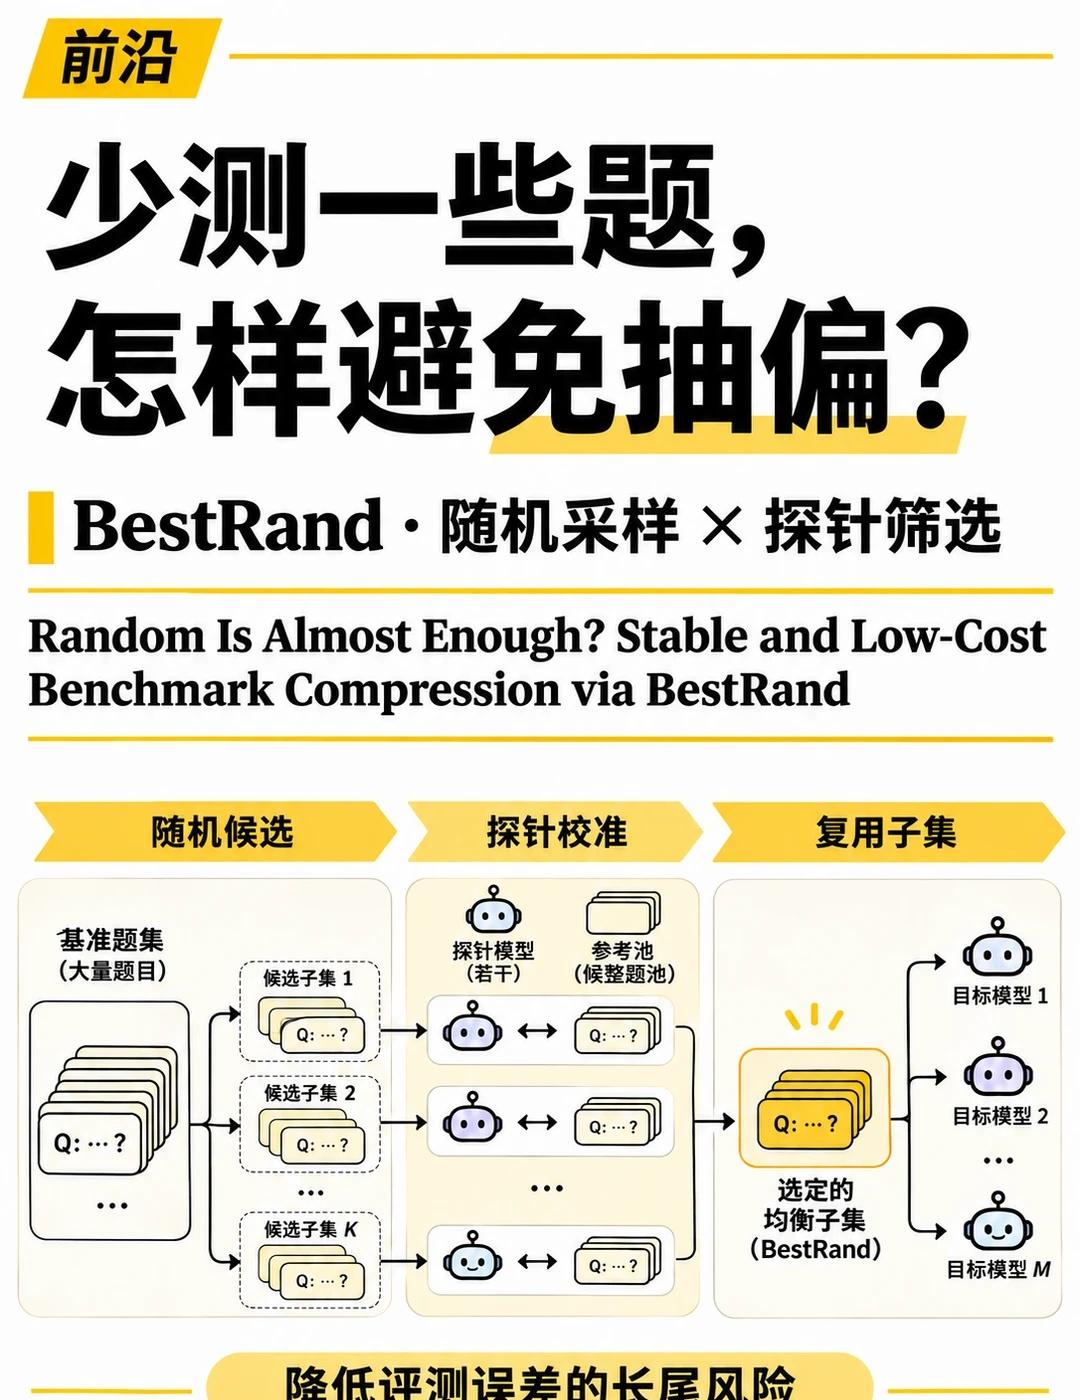
BestRand:少测题怎样避免抽偏?
评测一个模型,往往要跑成千上万道题。如果只抽一小部分,能否估出完整基准上的分数?BestRand研究的是基准压缩:用更少题目估计完整分数,并减少抽样带偏的风险。
随机抽题其实常常已经不错。问题在误差分布:多数子集误差较小,少数子集却偏得很远,形成长尾。如果多个模型擅长和不擅长的题相似,一组偏容易的题会把它们的估计分数一起抬高。再增加相似模型,也未必能把这种共同偏移平均掉。
论文在模型分数相关等近似假设下,分析子集分数与全量分数的误差,并用实验检查这些预测。方法因此把重点放在筛掉高误差抽样,而不必先训练复杂的分数预测器。理论描述的是特定假设下的近似行为,有限样本仍有剩余误差。
BestRand先从基准随机抽一个候选题池,让少量探针模型在池内作答,记录每题分数;随后反复从池中抽取目标大小的候选子集,比较各子集的探针平均分与题池平均分,选差异最小的一组。最终,待评测的目标模型只跑这组子集,并直接平均分数。
直觉是:如果某个子集让几位探针模型都比在参考池中表现得更好,它可能偏容易;让平均表现更接近参考池,有助于压低共同偏移。筛选依据探针而非目标模型的得分,不需预先取得目标模型的全量答案。
默认配置用5个探针、128组候选,题池大小最多为子集的4倍,并受完整基准大小限制。关键是候选之间复用已经缓存的探针分数,比较更多候选只需计算均值,不会每次都新增模型调用。题池太小则会让参考均值本身不够准确。
实验主表覆盖70个基准,包括44个文本、16个多模态和10个智能体基准,测试2%至50%的六档保留率。保留20%题目时,文本组平均绝对误差从随机抽样的约2.11个百分点降到1.73个百分点。这衡量全量分数估计得有多准,并不表示模型答题能力提升。
论文还报告,相对数据依赖型方法,平均构造记录量约为51.3%。这里按“模型—题目”分数记录计成本,总费用还受输出长度与硬件影响。跨模型家族、分数区间和时间划分的实验也显示更低的平均误差。
边界是,探针必须提供有用信号,未被它们解释的偏差不会凭空消失。实际使用仍需检查新模型上的误差分布、尾部风险与关键能力覆盖,避免把一份便宜的小题集当成永远可靠的全量替代。
模型评测 机器学习