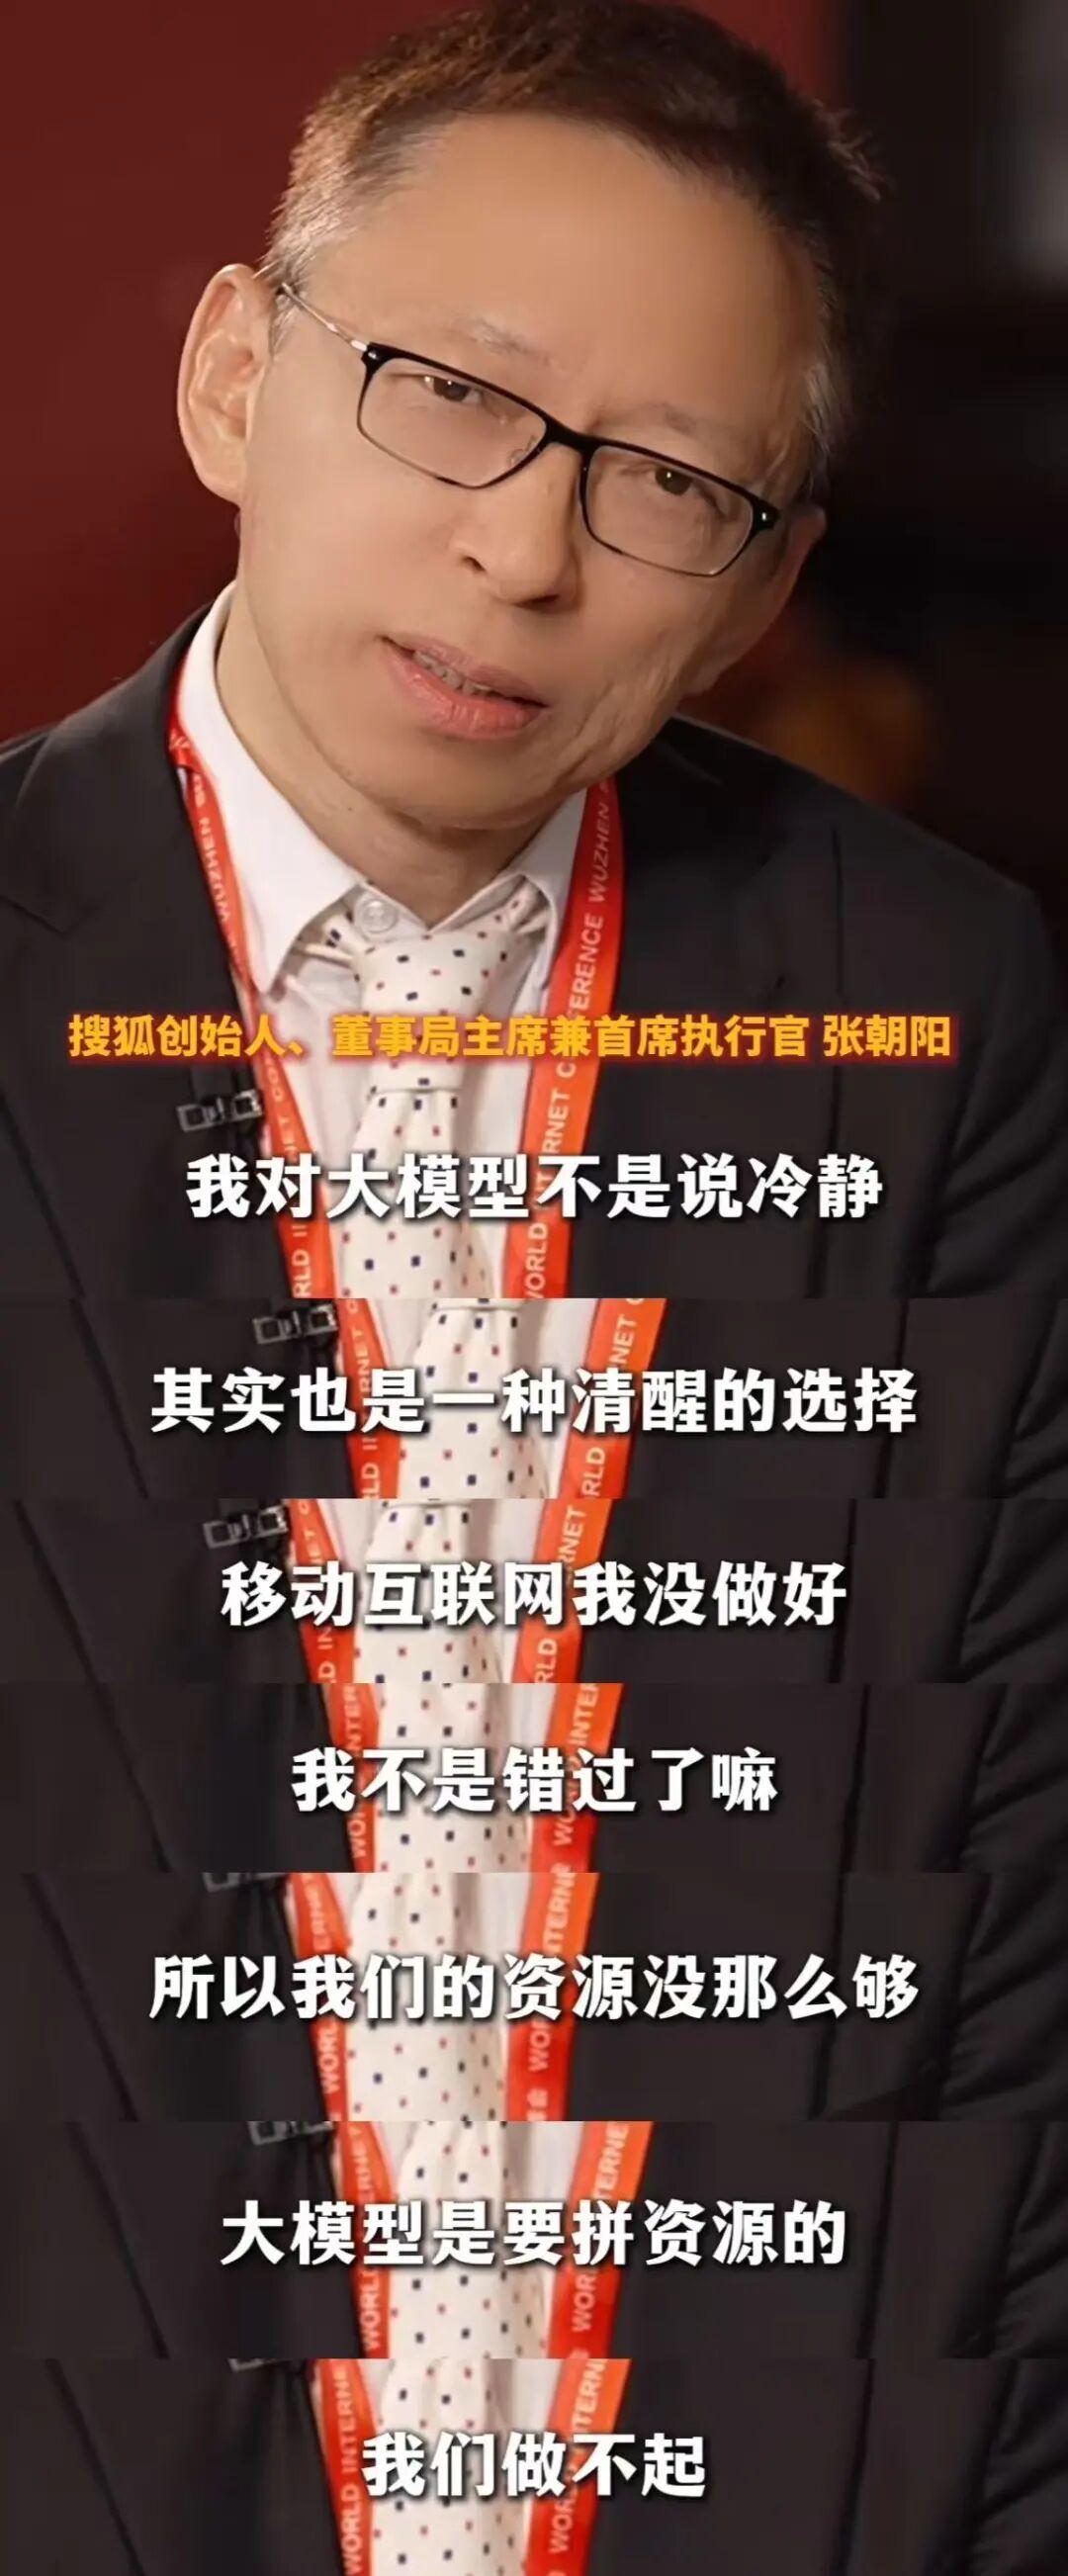
在2026年乌镇世界互联网大会的现场,搜狐创始人张朝阳说了一句久违的大实话:“我们做不起大模型。”
他坦言,因为自己当年错过了移动互联网,导致搜狐如今积累的资源有限。而大模型是一场极度依赖算力和资金的资源游戏,“我们资源没那么多,做不起。”
张朝阳在乌镇丢了一句大实话:“我们做不起大模型。”这话传出来,不少人第一反应是搜狐掉队了。但仔细想想,一个在互联网圈摸爬滚打快三十年的人,公开承认自己做不起一件事,其实比硬着头皮说“我们也要做”要难得多。
他后面补了一句,因为当年错过了移动互联网,手里资源没攒够,而大模型是拼资源的游戏,所以不跟了。这不是认怂,是一个打过几轮仗的人,看了一眼弹药库,决定不往那个方向冲。
大模型贵在哪,很多人其实没概念。
它跟开一条产品线完全两码事。前沿模型的训练成本动辄上亿美元,而且不是一次性砸完就完了,后续的算力维持、人才储备、数据迭代,每一环都在持续吸金。
行业里有个说法很形象:做基础大模型,烧钱的速度比赚钱的速度快一个数量级。巨头可以用主业的现金流去填,可以用资本市场的耐心去扛,但一家体量中等的公司拿什么跟?
用利润去追,追到哪一年算头;用融资去赌,赌输了谁来兜底。所以问题不是“大模型有没有未来”,而是当一张门票的价格可能把整家公司拖进危险区的时候,选择不买票,本身就是一种财务上的清醒。
更有意思的是,张朝阳说“做不起”之后,紧接着的动作不是躺平,而是把方向调到了AI工具的应用落地上。
这个转身其实点破了一层很多人没掰扯清楚的事:做基础大模型和用大模型,是两件成本完全不在一个量级的事。
基础模型越来越像水电气一样的基础设施,少数玩家负责把东西造出来,大多数公司要做的是接上管子,把它引到自己的场景里去用。
政策层面也在往这个方向使劲。
上海、成都、河南等地在推的算力券、模型券,说白了就是帮中小企业把“用”的成本打下来,让一家小公司不必自己建机房、不必从头训模型,也能调用现成的能力做自己的事。
这意味着产业正在自然分层:塔尖上站几个人,底下是一大片做应用、做工具、做场景的公司。承认自己属于底下这一层,不寒碜。寒碜的是明明够不着塔尖,非要借钱搭梯子往上爬。
回头看这轮大模型热潮,前两年“百模大战”喊得震天响,好像谁不发布一个大模型谁就被时代甩下了。但热闹退潮之后,真正留在基础模型牌桌上的,来来去去就是那几张老面孔。
大多数跟风入场的公司,钱花了,模型发了,然后发现找不到可持续的活法。这跟胆量没关系,跟算账有关系。
每一轮技术浪潮里,最不缺的就是“你必须做”的声音,缺的是有人冷静下来算一笔账:这件事我到底扛不扛得住,扛不住的话,我有没有别的路可以走。
张朝阳把“做不起”说出口,实际上是替很多同样扛不住却不敢说的公司,把那层窗户纸捅了。
产业要健康,从来不是靠所有人都挤在同一个环节上。有人负责攻坚底层,有人负责把底层的成果变成能用的东西,有人负责把东西卖到具体的行业里去。
每个环节都需要人,每个环节也都有活路。能看清自己该站在哪个位置,然后踏实站住,比喊一句“我也在做大模型”要实在得多。
参考信源:
搜狐:《张朝阳坦言搜狐做不起大模型:自己错过移动互联网,资源不多》,2026年11月6日
人民网:《多地发放算力券“红包” 促进人工智能赋能千行百业》,2025年7月30日
人民网:《多措并举破解企业“算不起”困境》,2025年8月26日
上观新闻:《大模型的风吹向哪里?专家:从技术狂热回归价值理性》,2025年7月27日