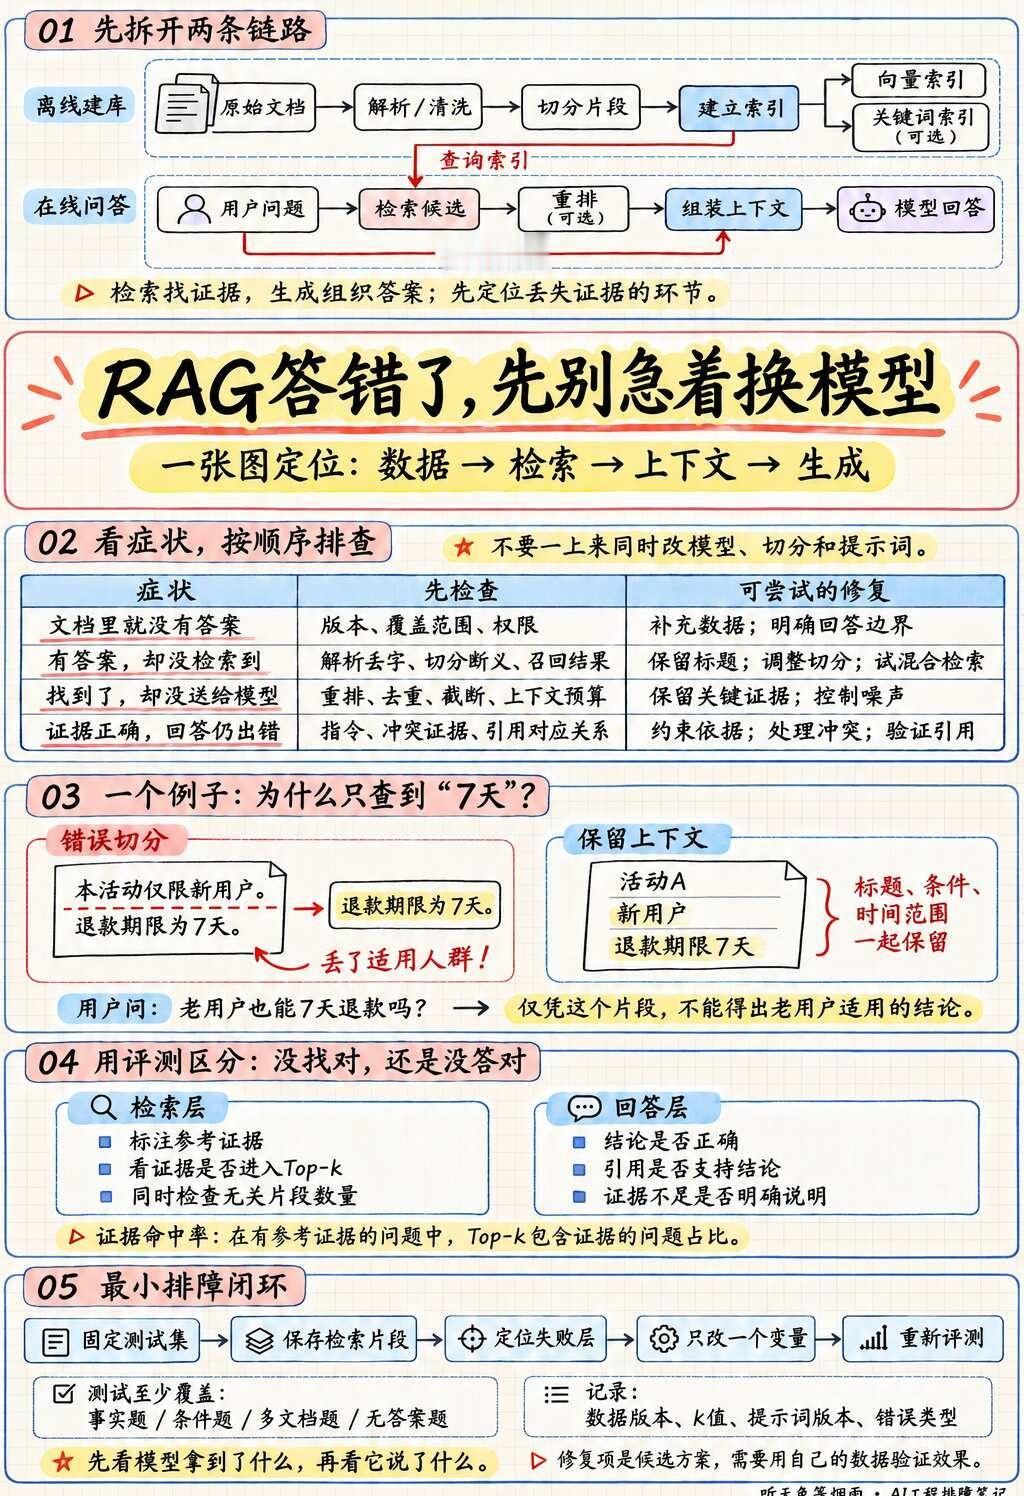
一张图排查RAG:评测到底哪里的问题?
RAG能跑通,不代表能答对。遇到错误,先保存这次检索结果和真正发给模型的上下文,别急着同时改模型、切分和提示词。
我把排查过程整理成了一张图👇
① 数据层:文档里真的有答案吗?
检查数据版本、覆盖范围、权限和解析结果。原始文档有信息,不代表解析后的文字还完整。
② 检索层:答案所在的片段被找到吗?
查看候选片段,尤其关注切分是否把标题、适用对象、时间条件拆散。可以尝试保留上下文、调整切分或混合检索,再用自己的测试集验证。
③ 上下文层:找到的证据真的送给模型了吗?
重排、去重、截断和上下文预算,都可能影响最终内容。不要只检查检索界面,还要看模型实际收到的输入。
④ 回答层:证据正确,模型是否仍然误读?
检查指令、冲突信息、引用是否支持对应结论,以及证据不足时有没有明确说明。
图里的例子:原文写“本活动仅限新用户,退款期限为7天”,如果只检索到“退款期限为7天”,就不能据此回答老用户也适用。检索不只是找相似句子,还要保留影响结论的条件。
最小闭环:固定测试集 → 保存检索片段 → 定位失败层 → 只改一个变量 → 重新评测。
测试至少包含事实题、条件题、多文档题、无答案题。分别检查检索有没有找到参考证据,回答有没有被证据支持。
先看模型拿到了什么,再看它说了什么。
你做RAG时更常卡在“检索不到”,还是“找到了却答错”?
RAG 大模型应用 Agent开发 AI工程 知识库 计算机专业 技术干货