OpenAI 和 Anthropic 这两年没少宣传自家模型在 AI for Science 上的突破,但确实也有吹牛的成分在,他们会把某一个点上的优势挑出来放大了说。
到底怎么客观评估前沿模型在科学研究方面的真实水准?
我看到有家涉猎 AI 科学研究的创业公司,牵头推出了一套 Benchmark,叫 Science Prediction Universe,简称 SPU。
SPU 会重点关注 AI 模型参与科学研究任务时,能否根据已有的科学知识和实验条件,预测不同实验方案可能得到什么结果。
从科学发现的视角来看,这个能力几乎是决定性的。
打个不那么技术的比方。
假设我面前有五条路,都有可能通往终点。
正常情况下,科学家会根据已有的科学规律、经验,以及目前掌握的事实,推演哪条路更有可能走通,然后优先投入时间和资源去探索。这样就能尽可能缩小范围,减少不必要的试错。
有人可能会觉得这没必要。完全可以让 AI 把这五条道迅速地跑一次,毕竟 AI 的执行和计算效率远超过人类。
不行。因为刚才说的只有五条路,如果摆在面前的是五十条、五千条,甚至五百万条路呢?
这个时候,即使 AI 的执行效率再高,如果不能提前缩小探索范围,最后可能还是要消耗大量算力和实验资源,像大海捞针一样去寻找答案。
UniPat AI 就是从这个问题出发,设计了前面说的 SPU Benchmark。
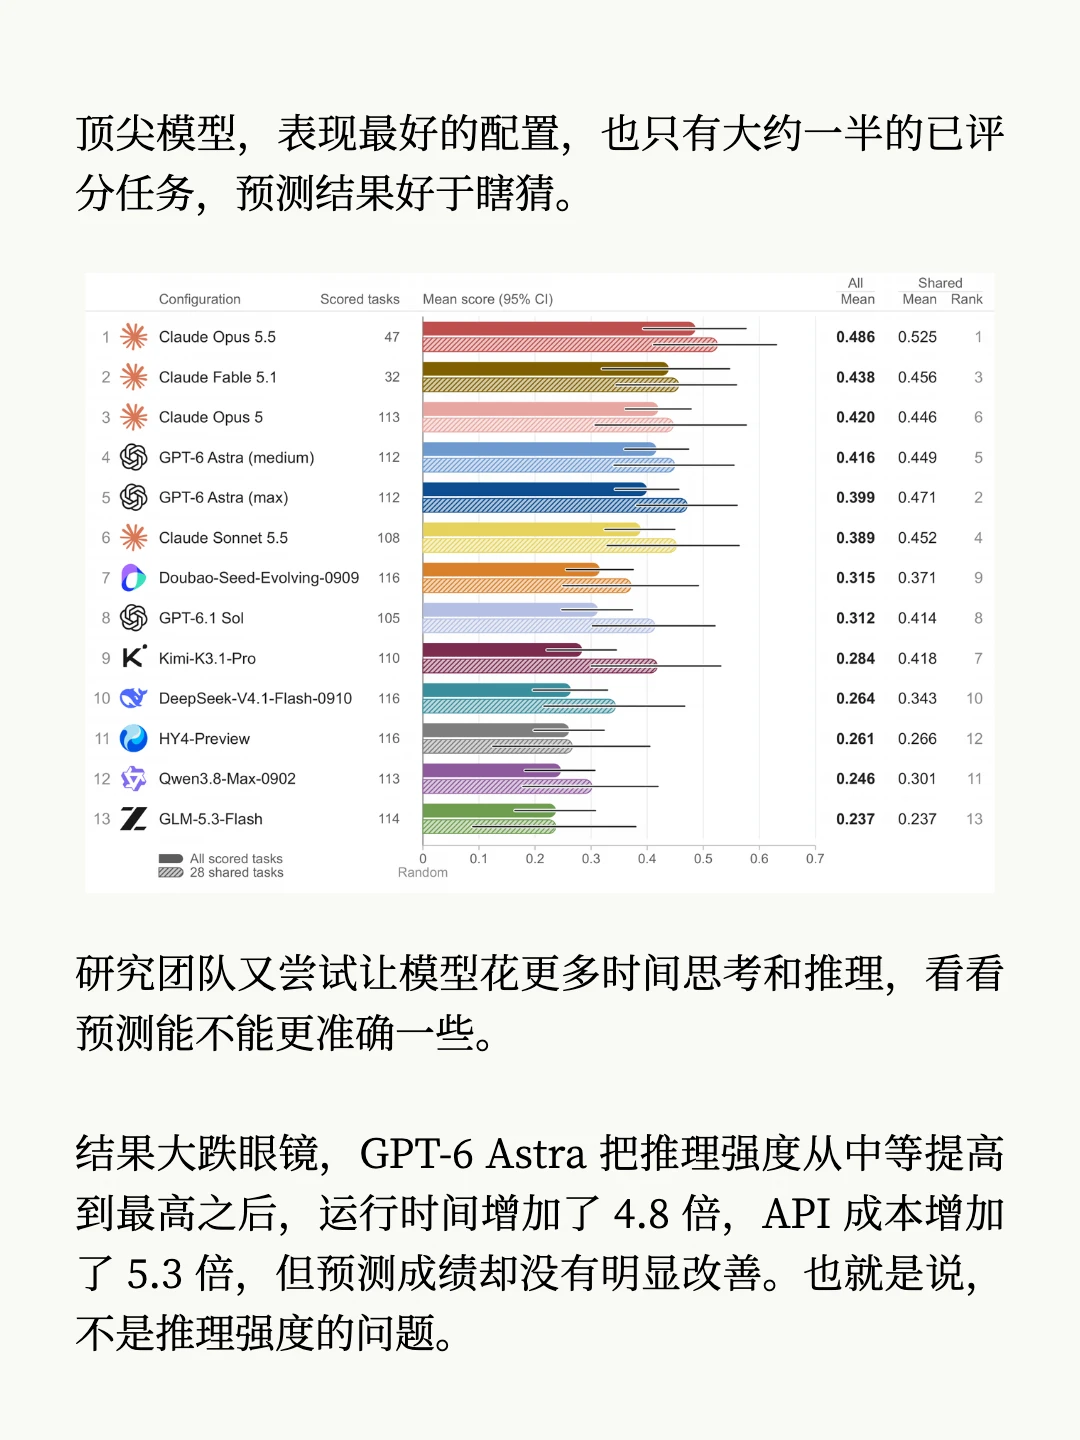
反正从这次测试来看,结果并不理想。即使是 GPT-6 Astra、Claude Fable 5.1 这些顶尖模型,表现最好的配置,也只有大约一半的已评分任务,预测结果好于瞎猜。
研究团队又尝试让模型花更多时间思考和推理,看看预测能不能更准确一些。
结果大跌眼镜,GPT-6 Astra 把推理强度从中等提高到最高之后,运行时间增加了 4.8 倍,API 成本增加了 5.3 倍,但预测成绩却没有明显改善。
也就是说,不是推理强度的问题。模型花了更多时间推理,仍然还是预测不准。
为什么?
为了搞明白这个问题,他们又进一步分析了不同模型的表现。
虽然前面提到所有模型的成绩都不算理想,但模型之间还是存在明显差距的。
对照分析了执行任务的具体过程,他们发现真正拉开差距的能力,其实是模型能否找准影响实验结果的关键因素。