ACL26 | Image-Grounded CoT 综述
🎉 背景
① 传统多模态 CoT 通常依赖文字推理,但遇到细粒度视觉信息时,如何避免遗漏关键证据?
② 在游戏、几何与规划任务中,模型如何想象尚未观察到的状态,并利用这些状态完成多步推理?
③ 已有方法涉及提示工程、监督微调和强化学习,但它们分别适合哪些任务,又存在怎样的数据与计算成本?
✨ 综述
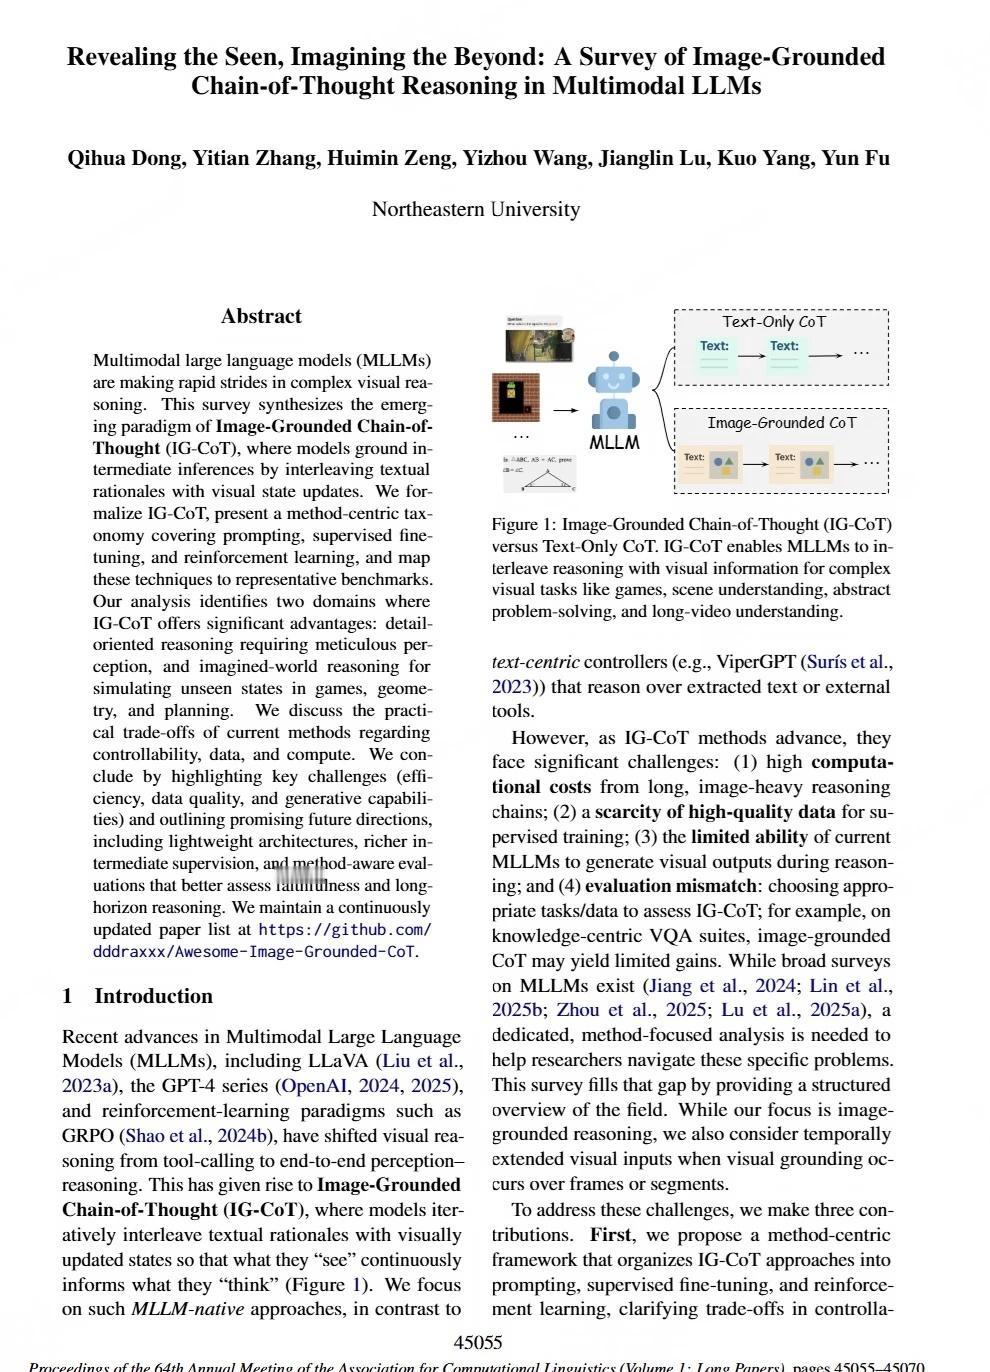
作者提出Image-Grounded CoT,IG-CoT的统一视角:让模型在推理过程中交替进行文本思考与视觉状态更新,使视觉信息持续参与推理,而不是只在开始时看一次图。
① 核心机制包括图像裁剪、放大、视觉草图和想象帧生成,通过视觉中间状态支持推理与修正;
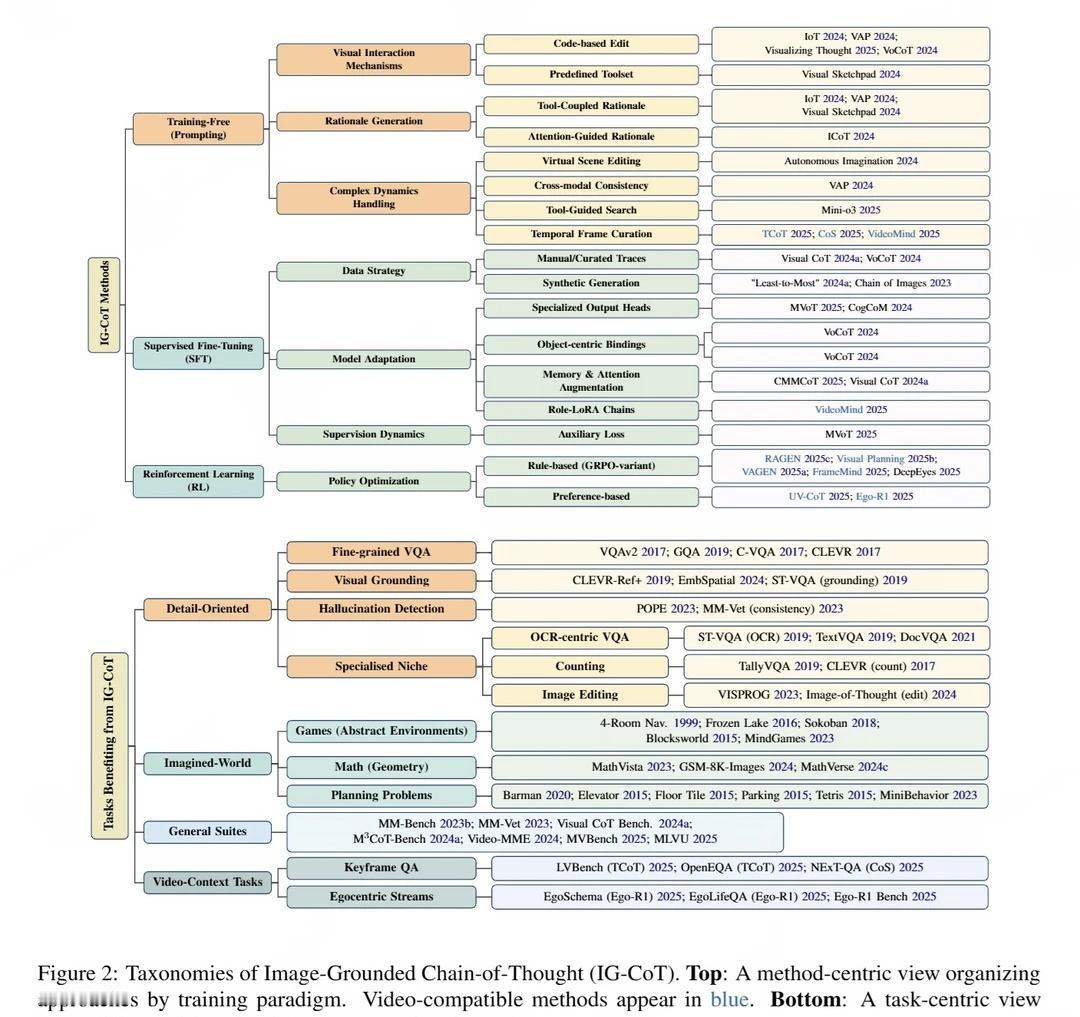
② 方法分类为无需训练的提示方法、监督微调(SFT)和强化学习(RL),比较不同路线的可控性、数据需求及计算成本。
③ 任务分为细节导向推理与想象世界推理,并扩展至视频和通用多模态评测;
④ 进一步归纳视觉中间状态、逐步视觉验证和强化学习泛化能力三个可检验假设。
acl-long.2087
多模态推理 图文交错推理 视觉状态更新 视觉想象 强化学习