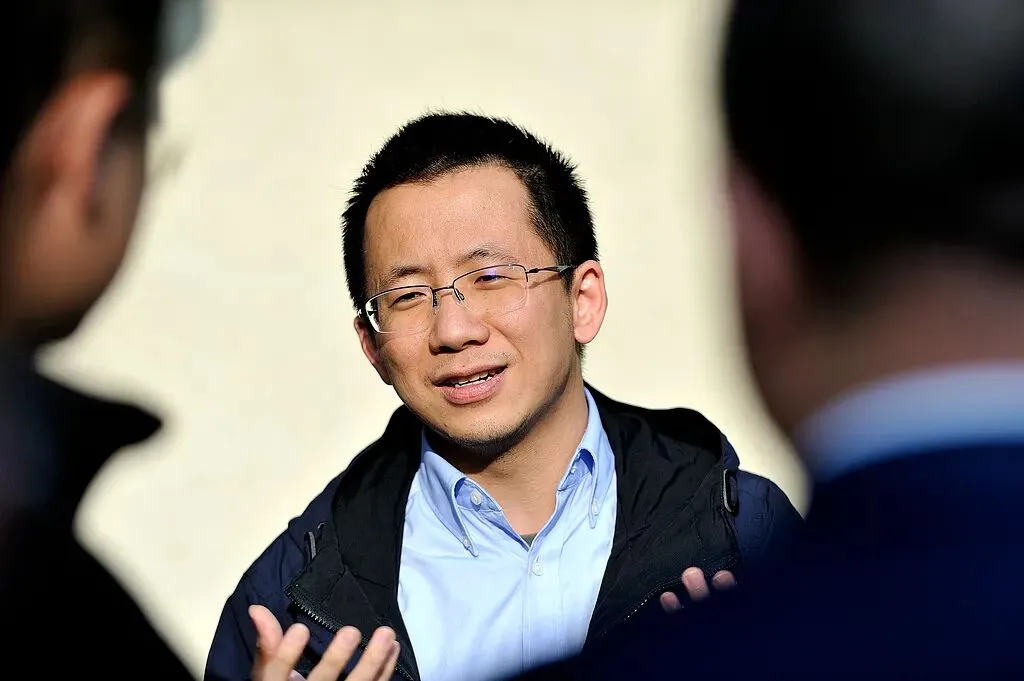
张一鸣在字节跳动内部全员会上罕见的交了底:字节有能力在前沿领域与 OpenAI、Anthropic 正面较量,但基础大模型想要真正追上,至少要等到 2029 年,甚至 2030 年。
卡住字节脖子的,不是钱,也不是算力,而是数据。
这番话在业内引起不小震动,毕竟字节眼下的 AI 成绩单看着相当体面。
先把这份体面掰开看。
C 端这边,豆包是国内用户规模最大的 AI 聊天应用,背靠抖音流量和长期免费策略,日活月活都排在前头;截至 2025 年 12 月,豆包大模型日均 Token 调用量超过 50 万亿,半年涨了 200%,同比是 10 倍增长,全球只排在 OpenAI 和 Google 后面。
视频生成那边,Seedance 一直卡在全球头部梯队,OpenAI 收缩 Sora 相关服务后,它顺势补上了不少空白。
聊天应用跑得欢,视频模型站得住,这成绩放哪家都拿得出手。
但问题也藏在这份热闹里。懂行的人都清楚,应用层爆发,很大程度靠产品运营、推荐算法、流量分发和真金白银买量,而不是底层模型跟对手拉开了几代差距。
翻到基座这层,节奏就平缓得多,Seed 语言主模型最近一次大版本,还停在 2026 年 6 月的 2.1。
台前烈火烹油,台下基本功还在慢慢补。
再说回张一鸣点名的软肋 —— 数据。
大模型说到底是靠喂资料喂出来的,喂什么、喂多少、喂得精,直接决定它后来能长多高。
他在会上说得很直接,Seed 预训练数据集的规模,比美国顶尖对手少了一大截。背后还有层结构性难处:中国工程院研究显示,全球通用大模型训练集里,高质量中文语料占比只有 1.3%,绝大部分是英文和其他语言。
想拿全球范围优质、多语言、高知识密度的语料,绕不开版权壁垒和地域限制。
跟 GPU 不一样,显卡可以谈价下单、拉集群,高质量语料却没法靠加急采购一夜搬回来,标注、清洗、合规,每一步都得一天天熬。
更少见的是,字节主动把一条捷径堵上了。
这条捷径叫蒸馏,说白了就是拿更强模型生成的答案训练自己的模型,成本低、见效快,跑分很快就能好看。
但这就像背别人整理好的答案考试,短期名次上去了,自己脑子里并没真学会。
张一鸣重申 Seed 训练不走蒸馏,内部还靠 API 异常检测、过滤开源模型数据等手段,防止有人私下调用第三方输出当训练集。
CEO 梁汝波在年中会上也把话说开:坚持自研,做好基本功,接受短期落后,把时间花在长期上。
把这些拼到一起,2029 年甚至 2030 年这个时间表就不玄了。
Seed 团队大约有 1000 名研究人员和工程师,由 2025 年从 Google DeepMind 加入的吴永辉带队;2026 年 10 月单独成立安全与对齐部门;公开信息里,字节还讨论过 2026 年在 AI 基础设施上最高投入 700 亿美元,建数据中心、囤算力。
能花的钱都在花,能挖的人都在挖,但数据鸿沟、人才梯队、安全对齐这些壁垒,不会因预算翻番就自动消失,何况 OpenAI、Anthropic 那边也没停下迭代,没人会原地等你 3 年。
当然,字节也不是只有苦熬。它攥着别人很难复制的一张牌 —— 视频数据。
抖音、TikTok 攒下全球体量最大、最新鲜的视频素材库,喂给视频生成模型正好对口,Seedance 才能在这条赛道直接站到前沿,眼下就能变现,反哺底层研发。
接下来几周,字节还打算推出一款类似 Meta Muse 的 AI 助手,从聊天框往穿戴式智能体走,产品形态上没打算躺平。
所以这份 2029 年的判断,与其说是认输,不如说是把账算明白了:应用层负责赚钱占用户,底层模型慢慢补课,中间用算力、人才和长期耐心一点点填坑。
前沿竞争里从来没那么多弯道超车,更多是漫长、昂贵又要忍住寂寞的长跑。
只要现金流不断、方向不偏,能不能准时跑到终点不好说,但至少它没靠捷径给自己画一张已经追上的饼。