Transformer很水的,看完这61页你就🐮了
🔥AI 必学|Transformer 模型超通俗解析
搞 NLP、大模型的同学绕不开的核心模型!
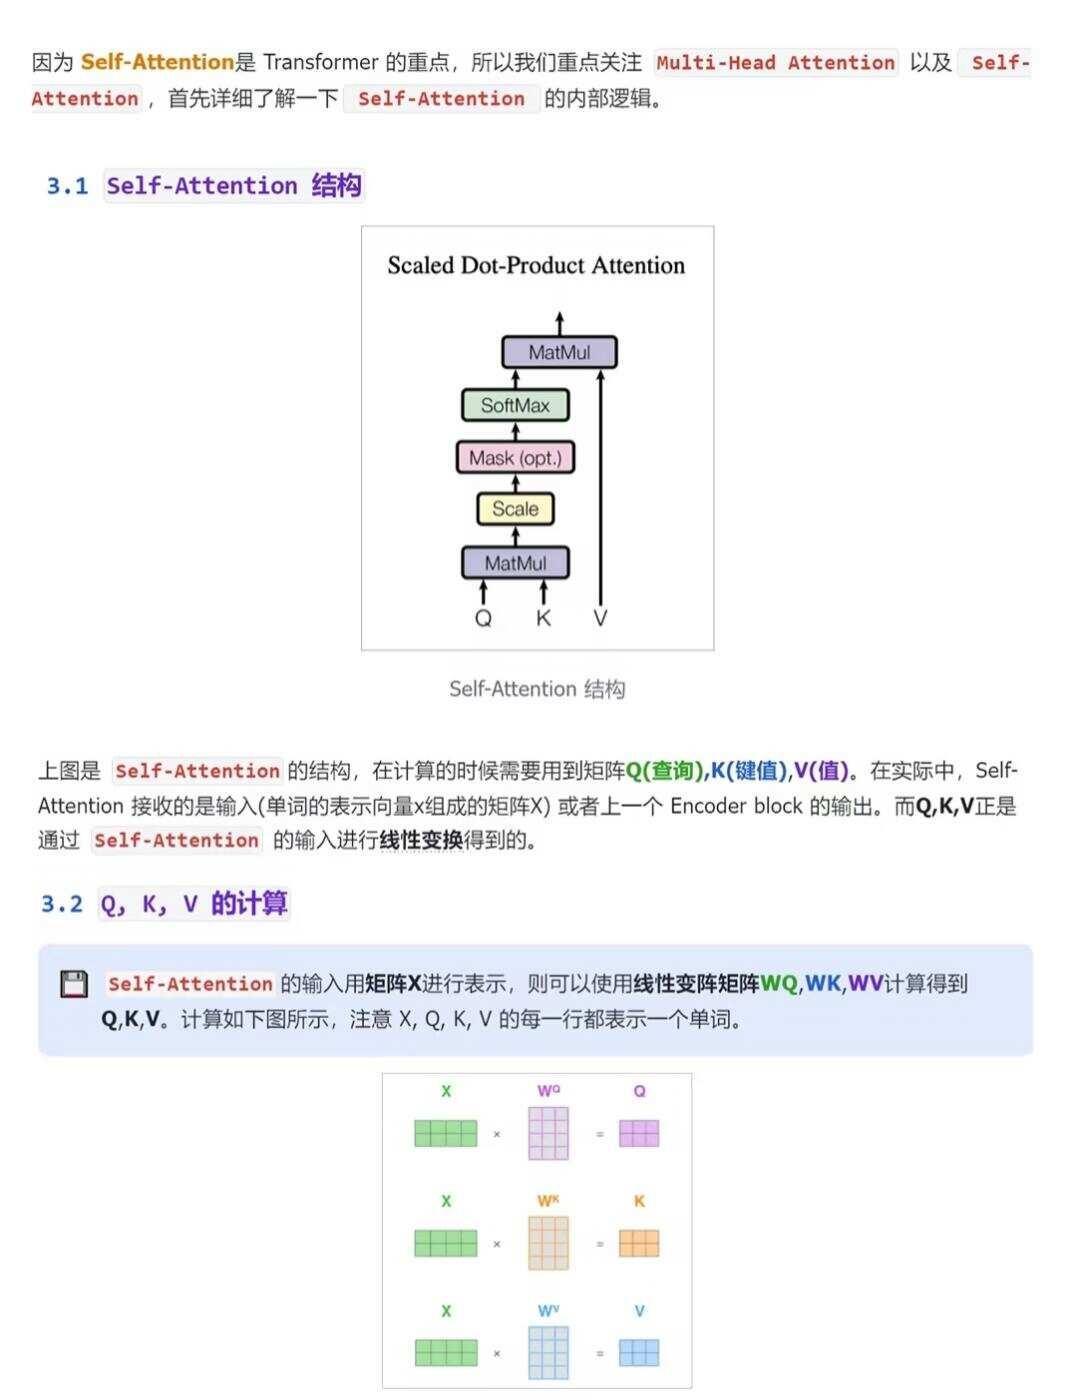
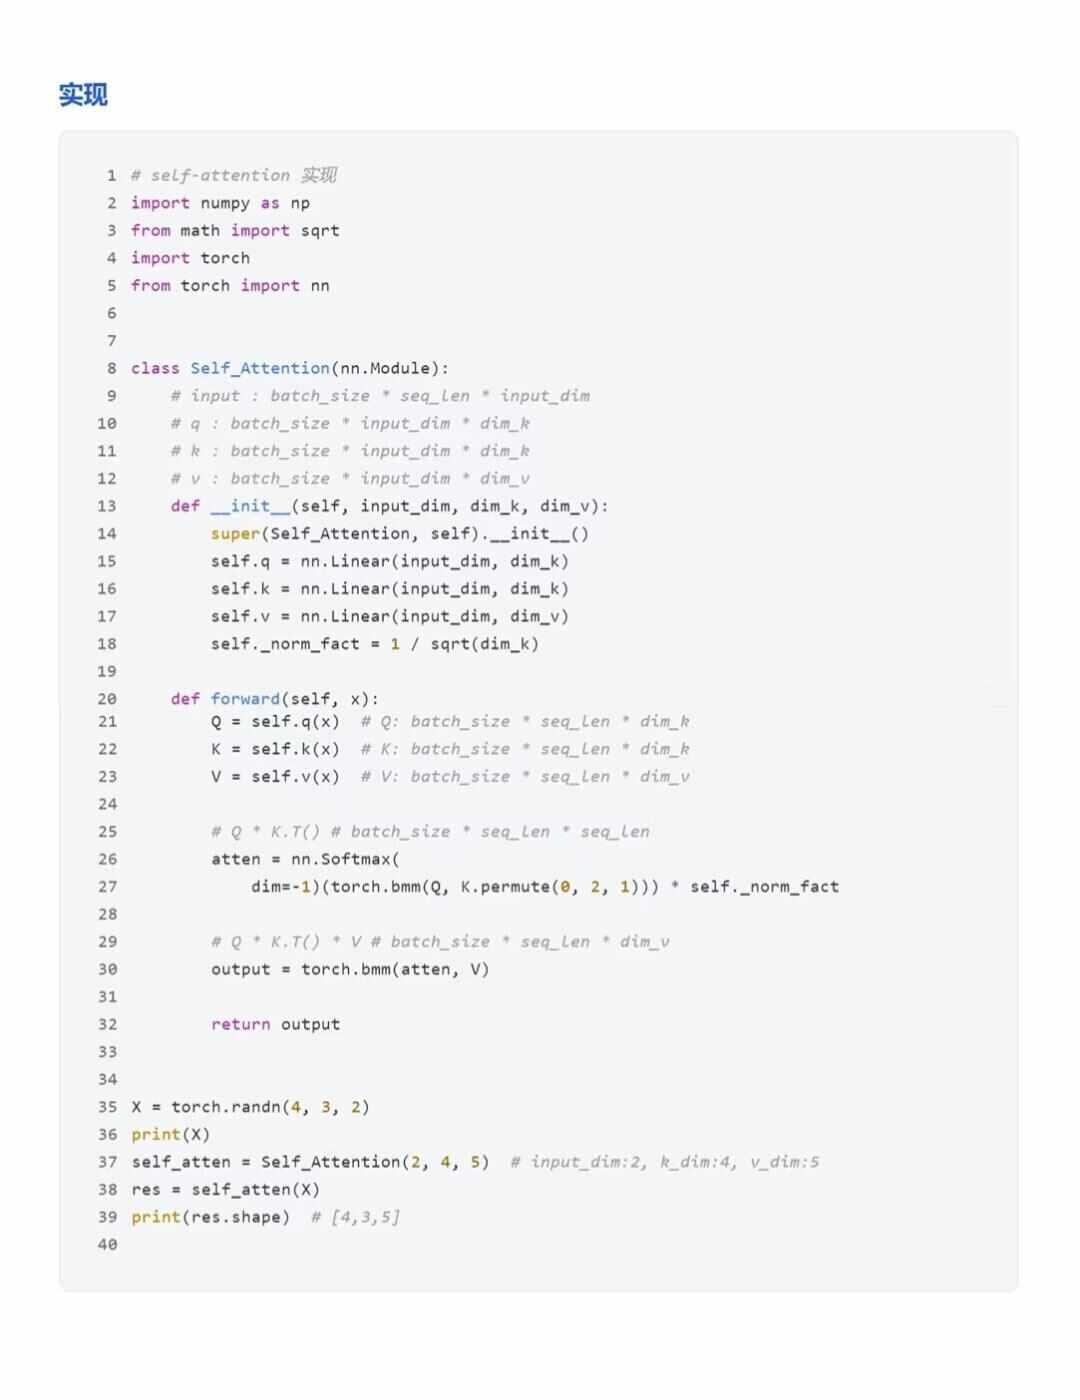
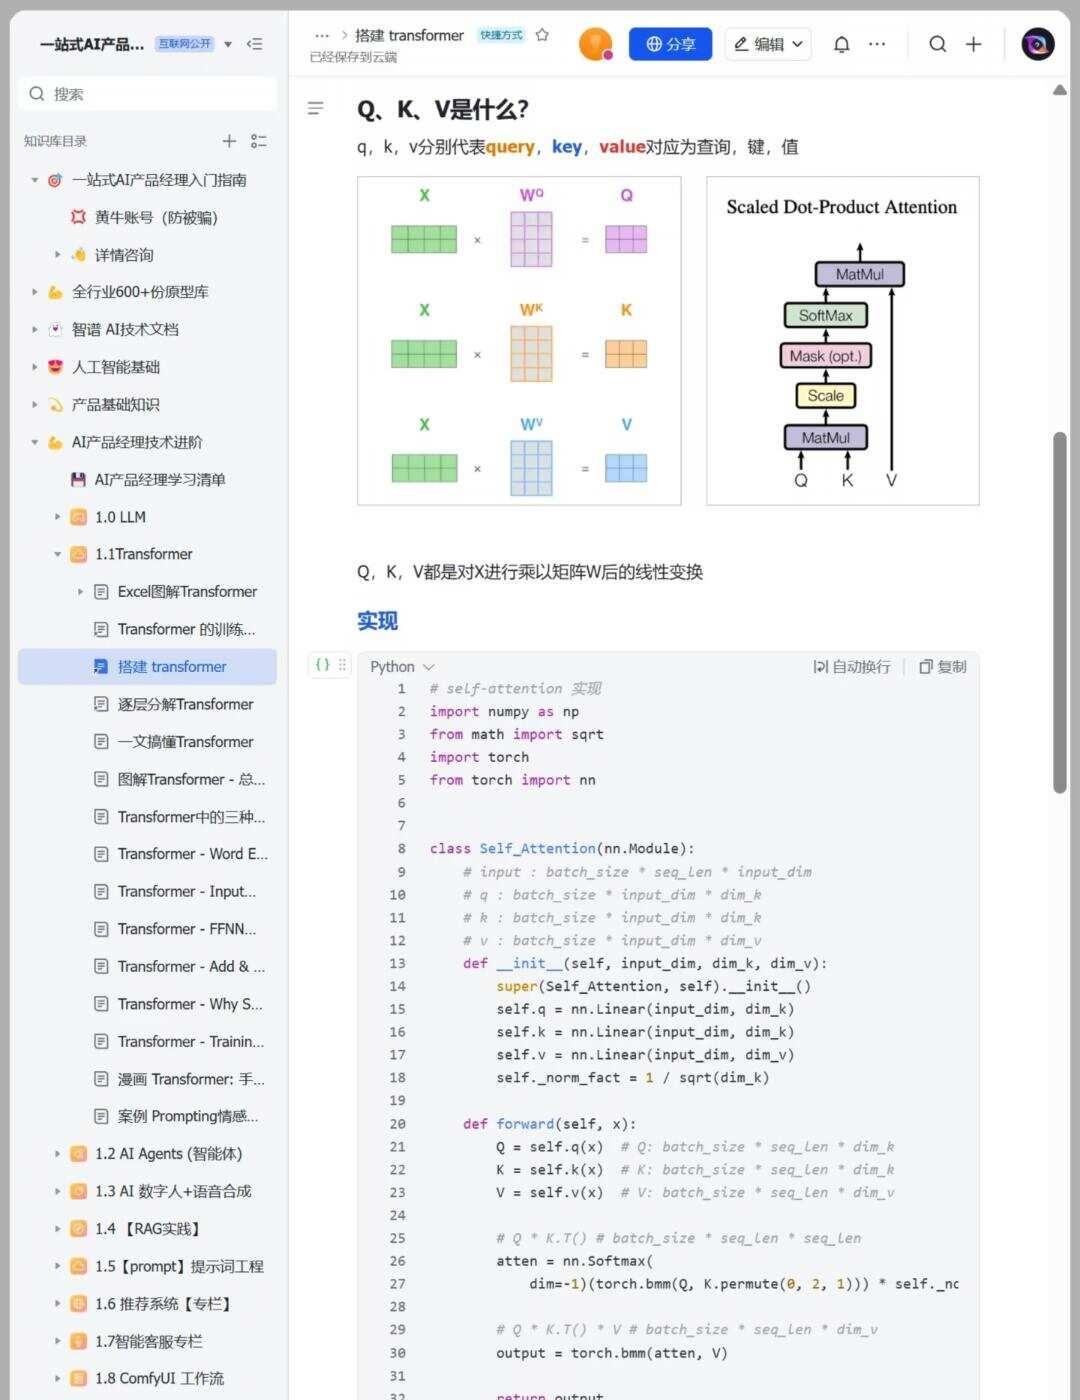
它出圈的杀手锏就是**自注意力机制**✨
可以跨序列不同位置,抓取元素之间的关联关系
也是大模型理解语言的底层关键
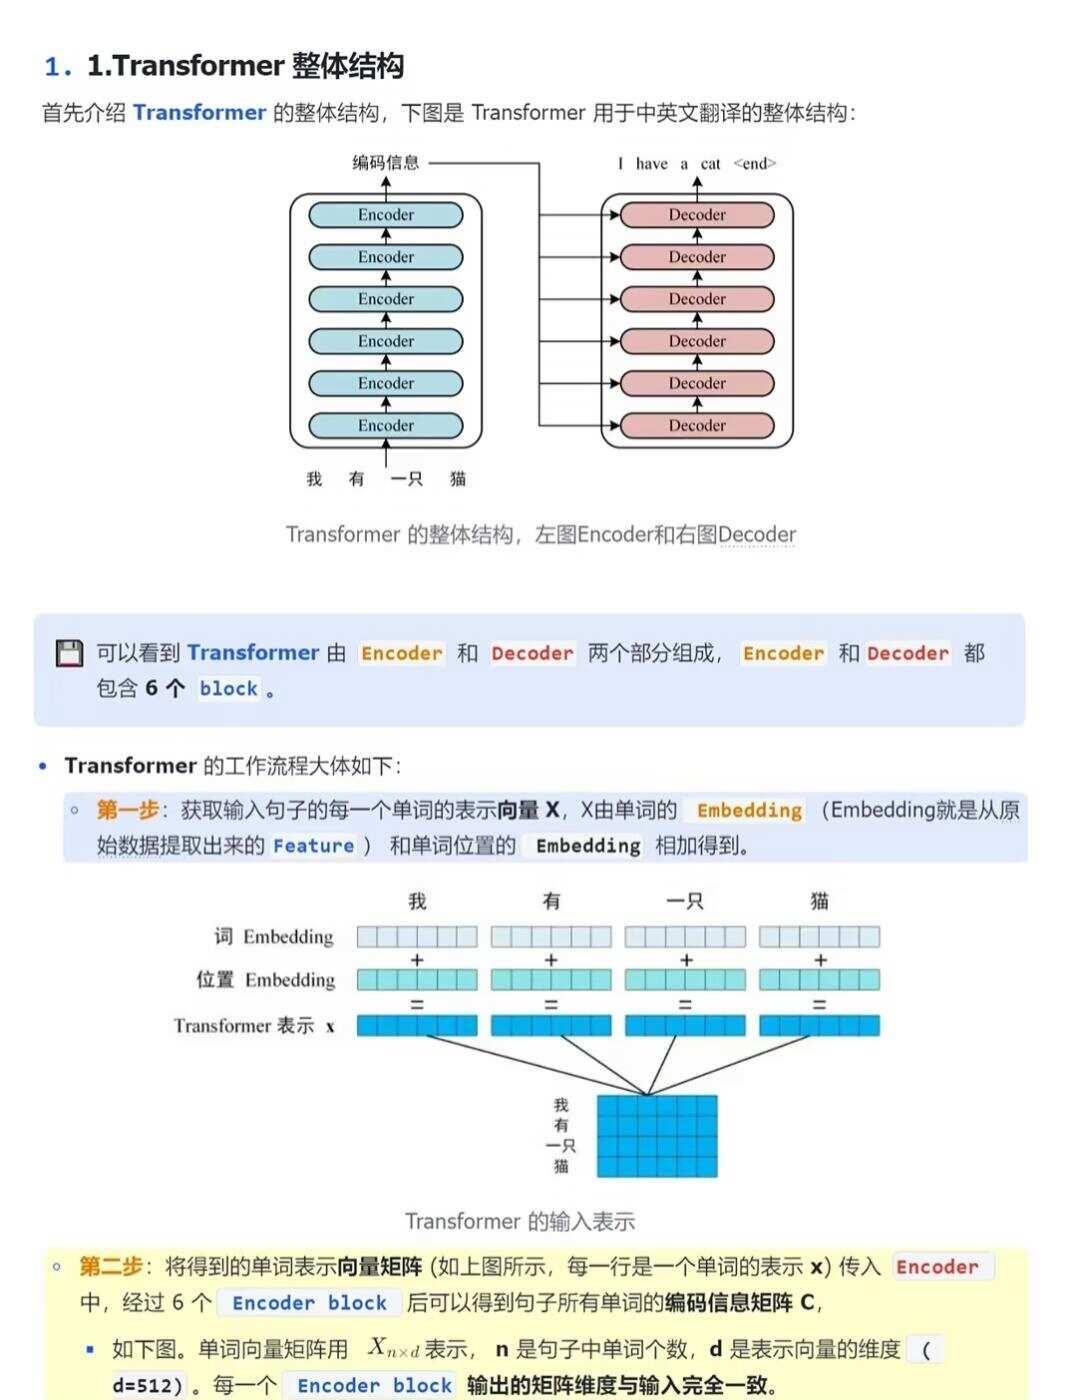
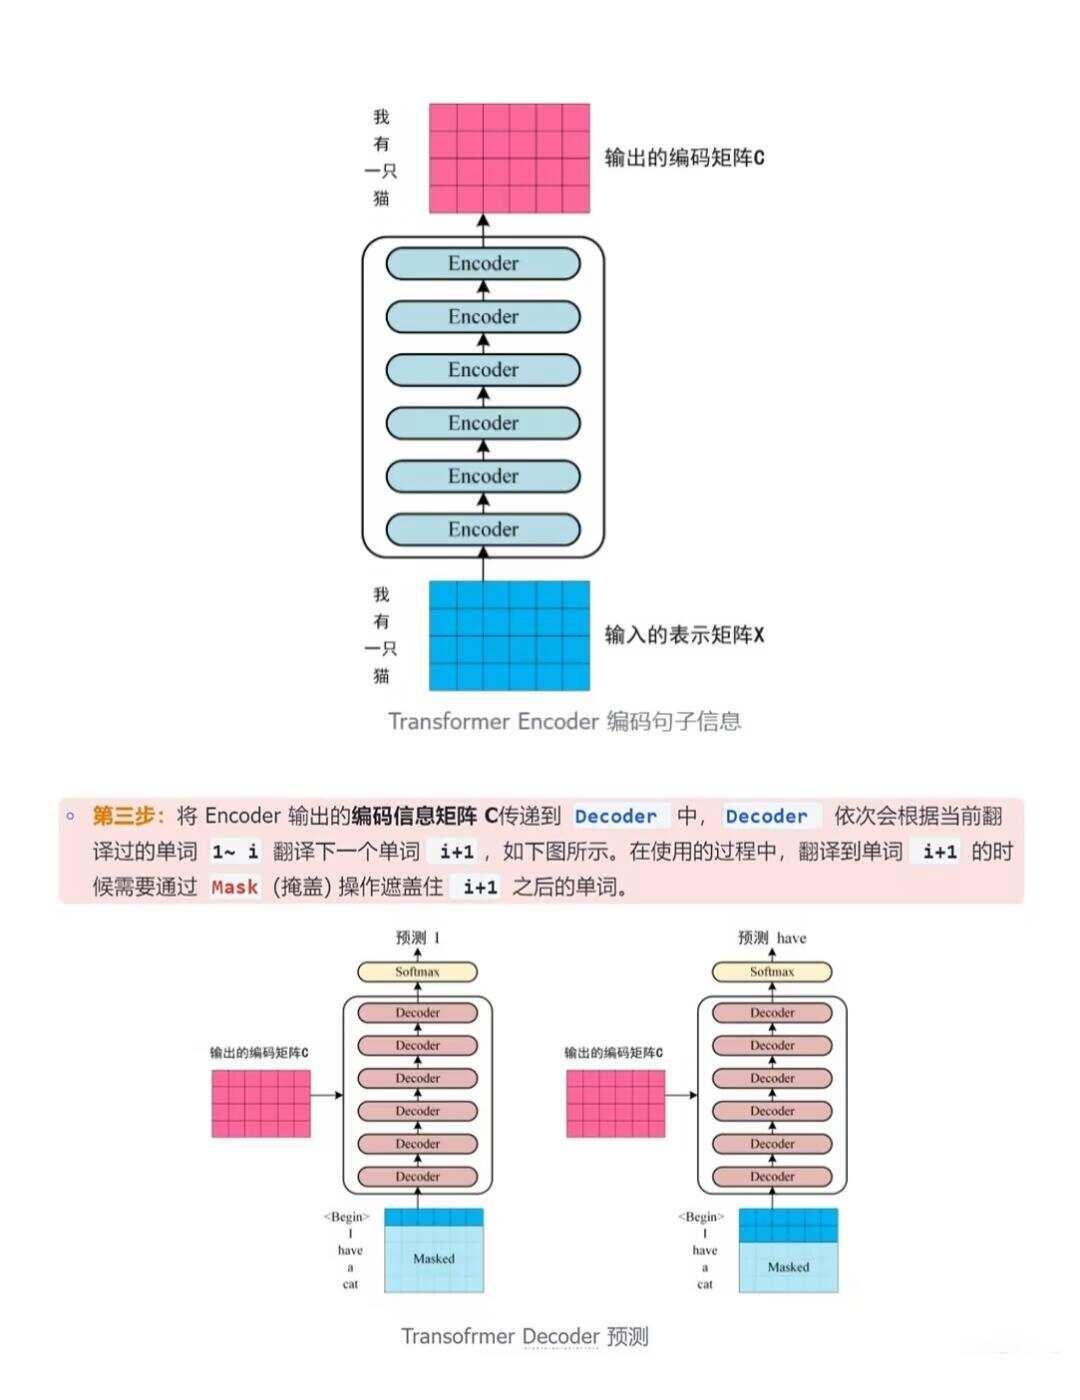
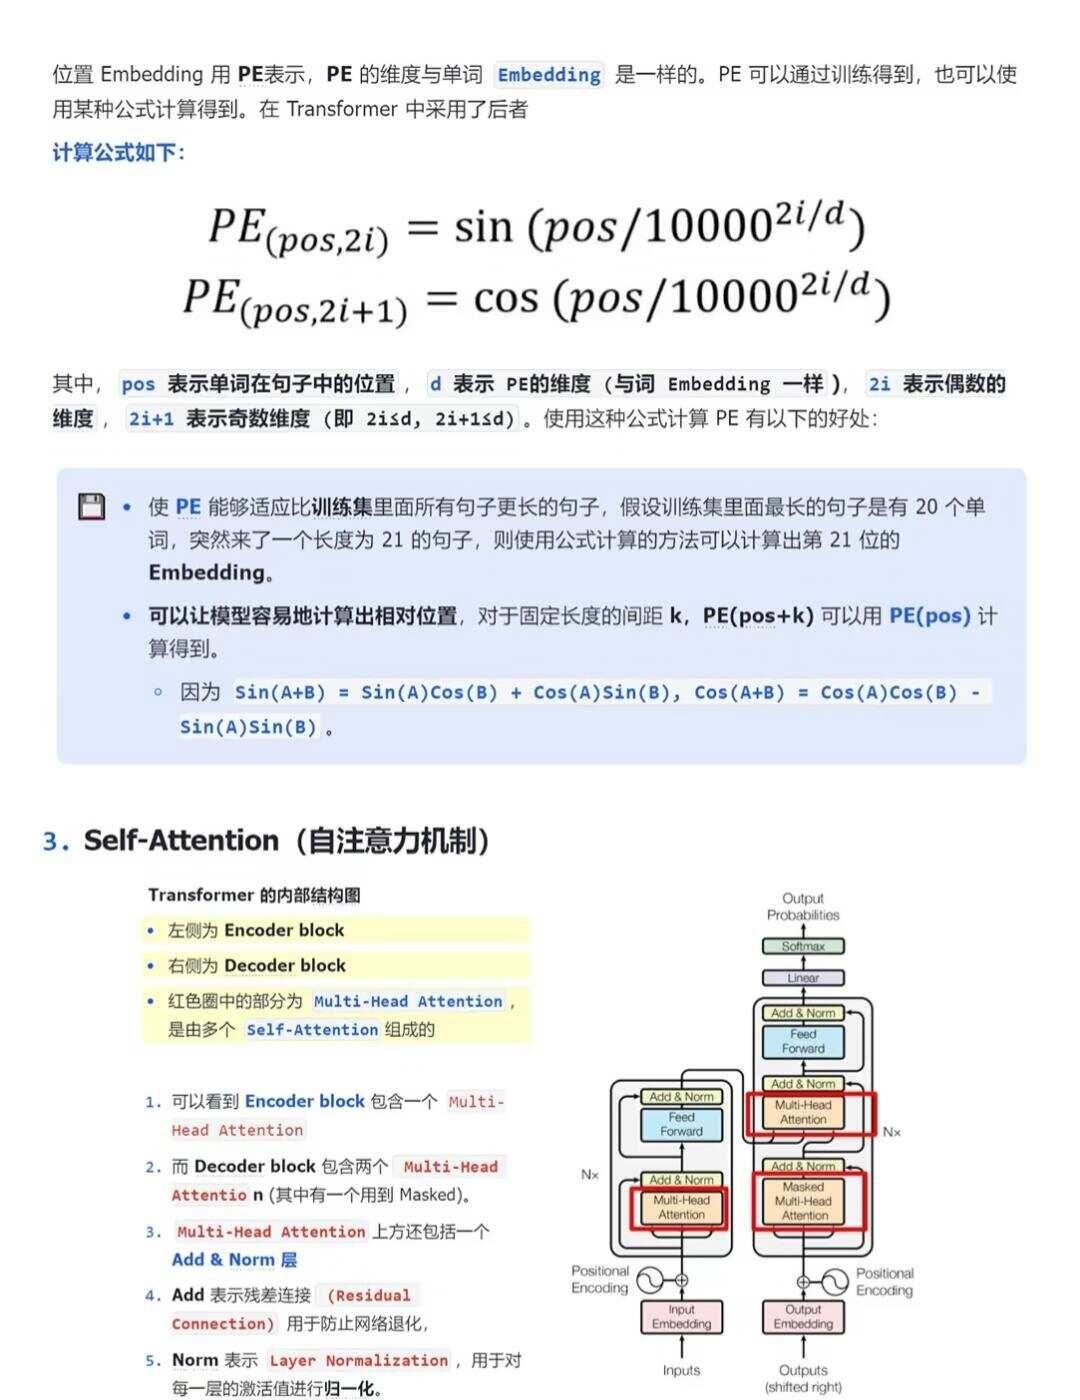
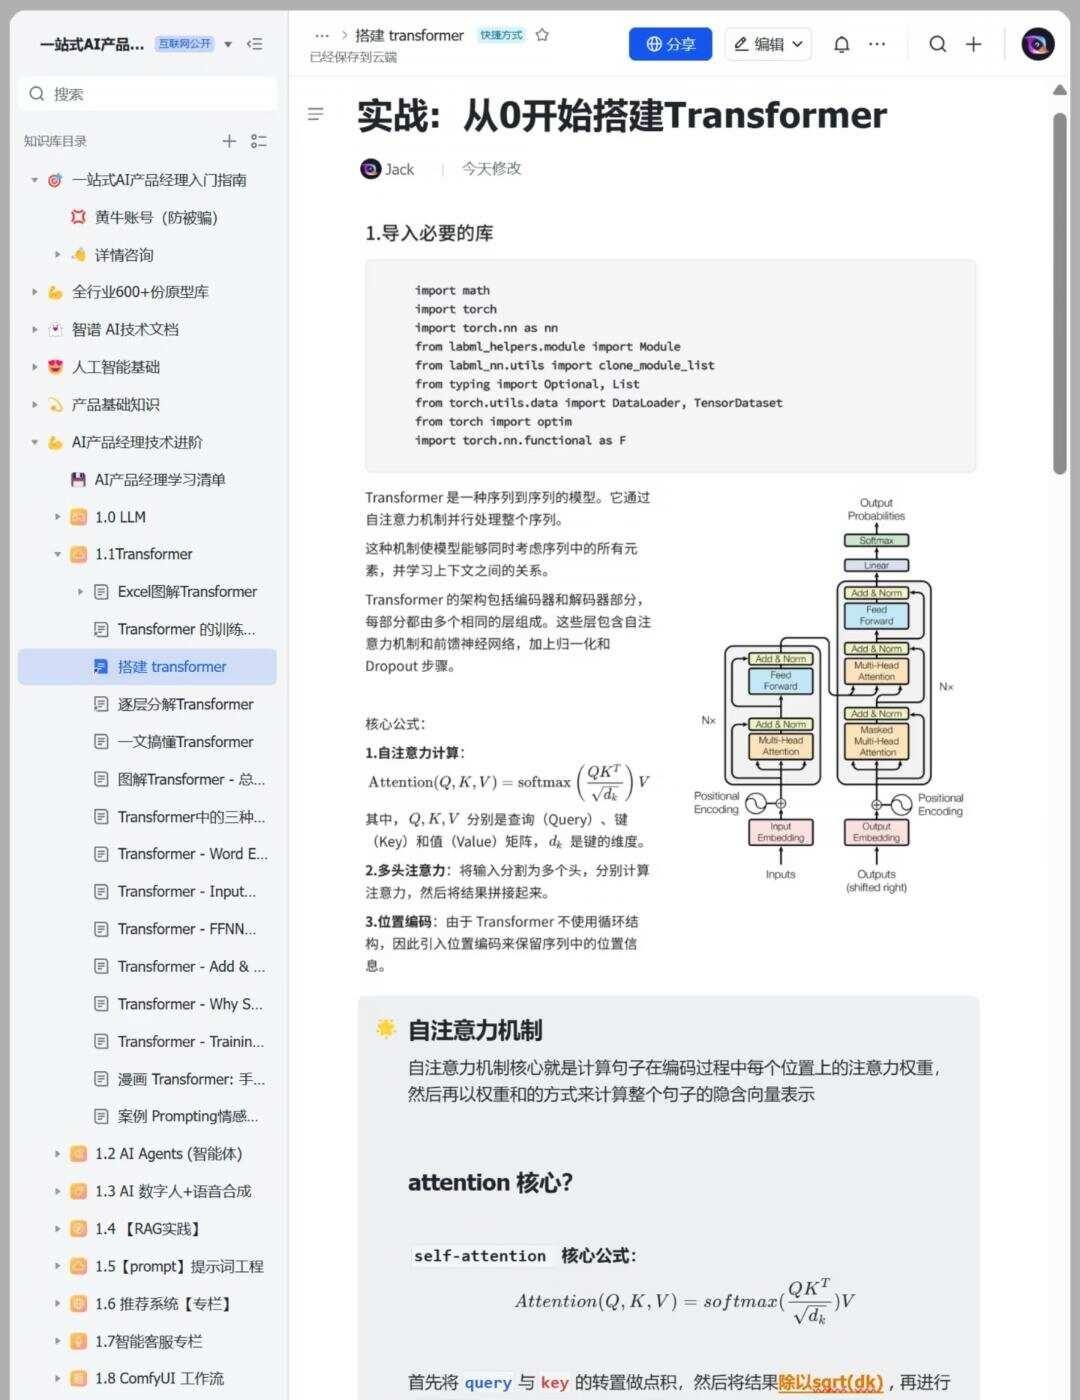
整体架构主要分为编码器 + 解码器
依靠多层注意力完成信息传递、精准提取特征
✅Transformer 三大优势
▫️并行计算效率强
支持高效并行,大规模数据集、分布式训练很能打,训练速度直接拉满
▫️迁移学习很香
预训练模型拿来微调就能适配各类任务,省下超多算力和时间成本
▫️擅长长距离依赖捕捉
自注意力天生适合抓远距离的序列关联,处理文本优势突出
⚠️它也不是万能的,短板收好
▫️算力门槛高
对训练数据、显卡硬件要求高,硬件条件有限会很难落地
▫️部分序列任务表现一般
时间序列、音频这类数据,原生 Transformer 效果有限,需要改造优化
📌适用场景
机器翻译、文本生成、NLP 各类序列任务,现在几乎是标配模型
🧩完整架构核心组件清单
▪️依赖库导入
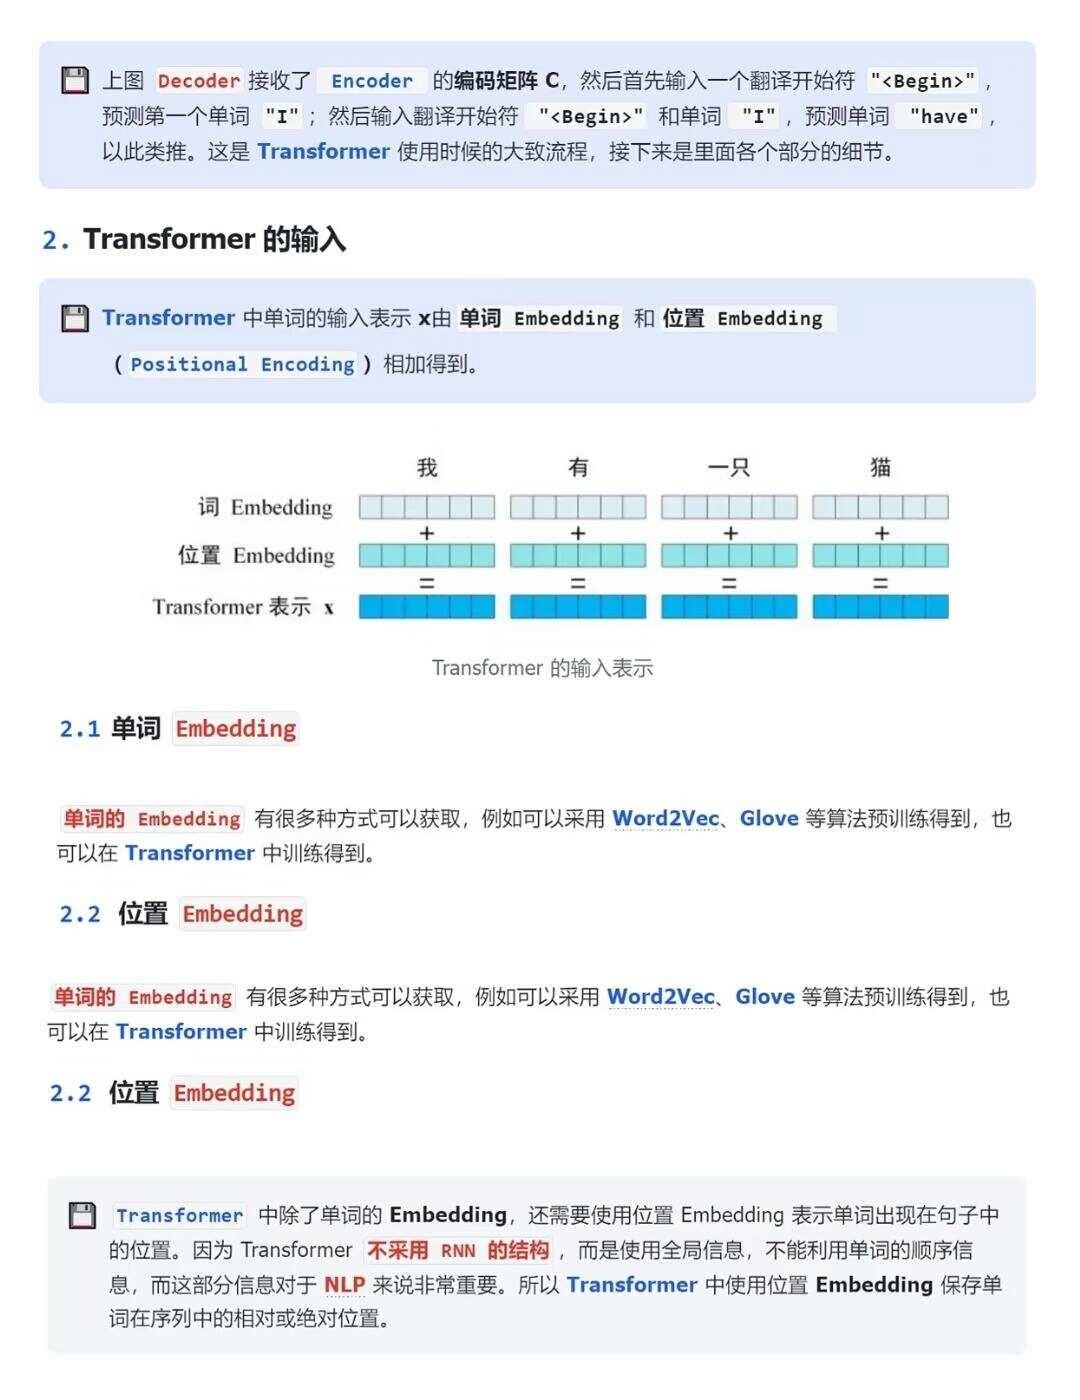
▪️嵌入层 + 位置编码:给 token 加上位置信息
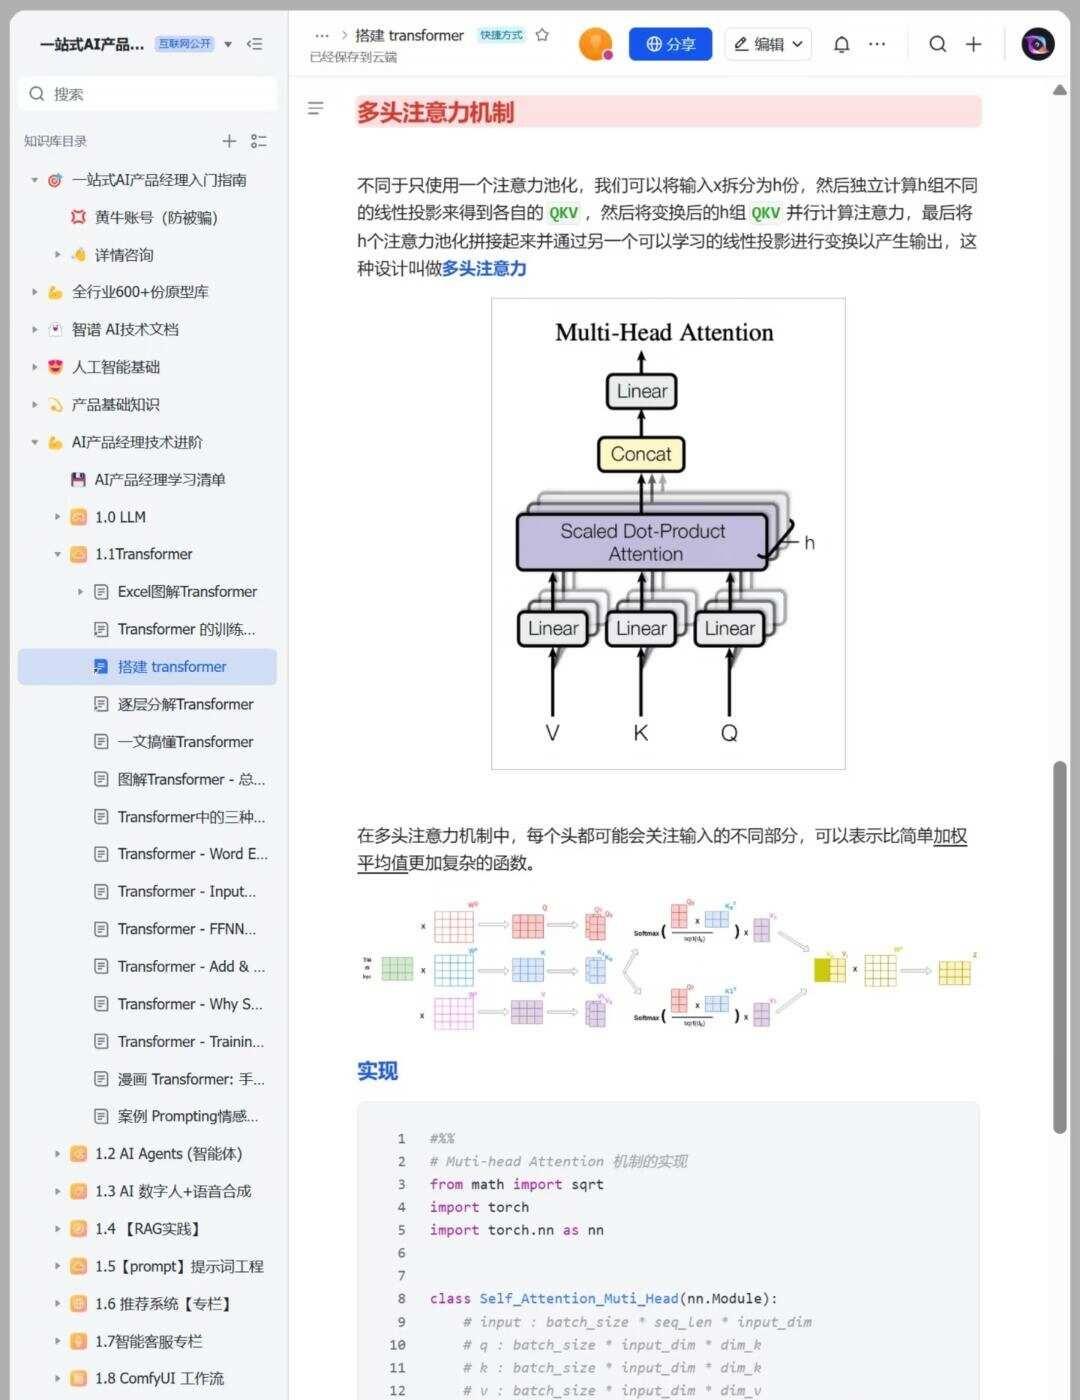
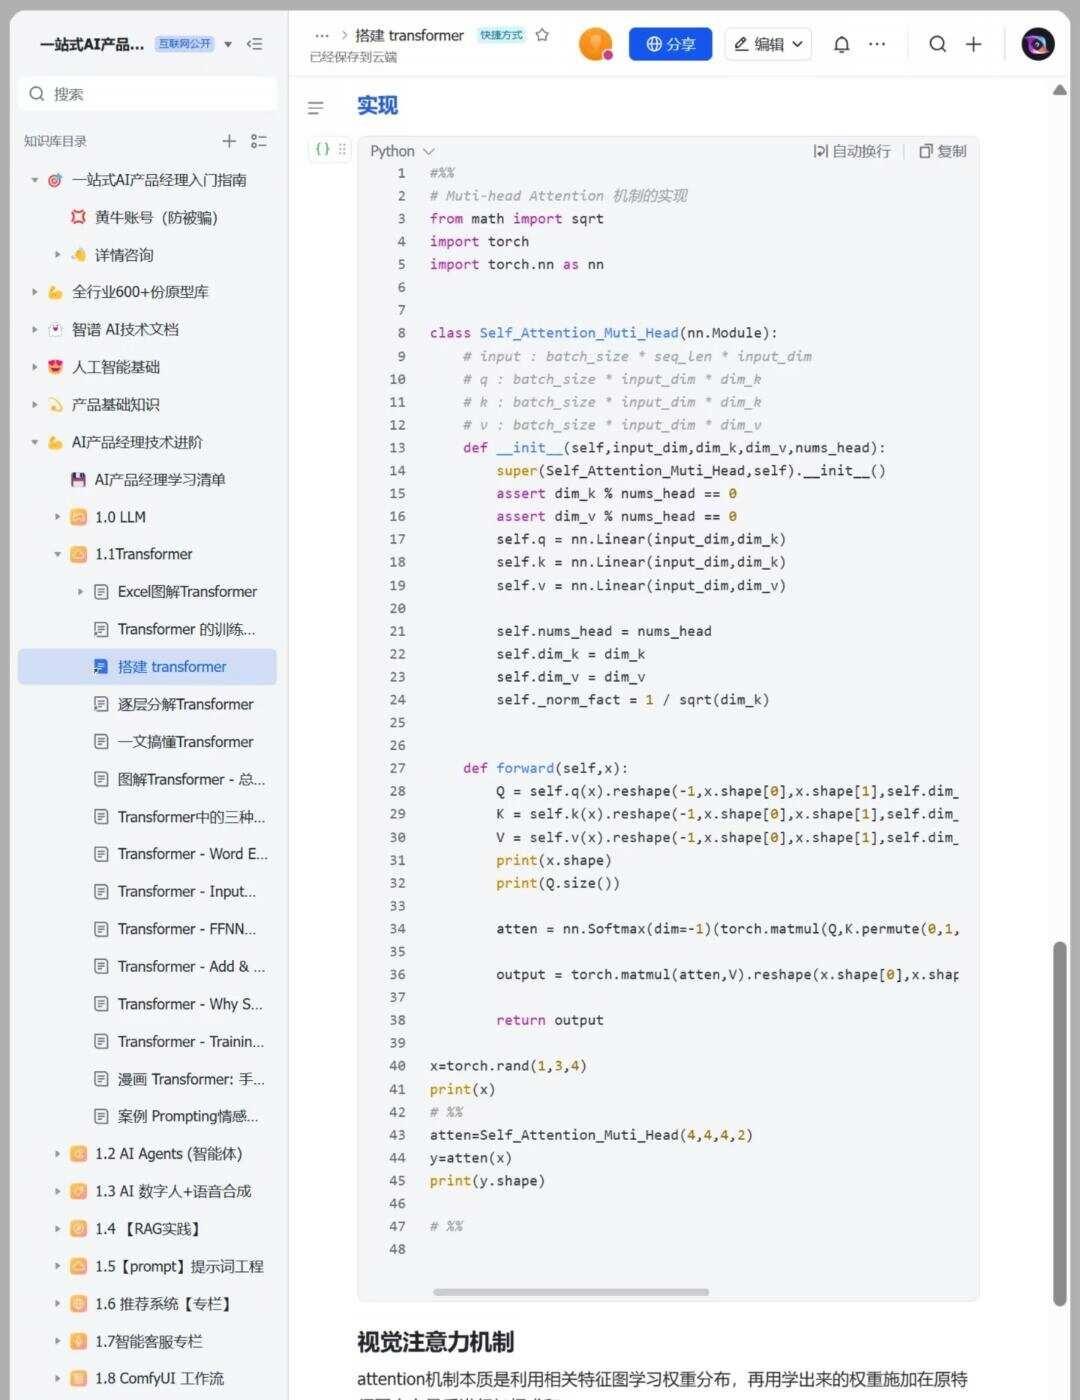
▪️多头注意力:多维度捕捉关联
▪️前馈神经网络:特征变换处理
▪️Transformer 基础层(核心)
▪️设备检测、超参配置
▪️数据集构建 + DataLoader 加载
▪️训练循环 + 测试评估
人工智能 深度学习 transformer 大模型应用 transformer模型 NLP 大模型 计算机 干货分享