突然反应过来,RSI 对于家用机器人来说,应该是基本功,而不是锦上添花。
这和 LLM 的发展路径还不太一样。LLM 是在模型能力发展到一定阶段之后,大家才开始集中探索,能不能让模型参与自己的改进。
但对于机器人来说,我觉得 RSI 的紧迫性可能更高。
因为现在机器人面临的问题是,模型进步的速度还不够快,而获取高质量的机器人交互数据,成本又非常高。
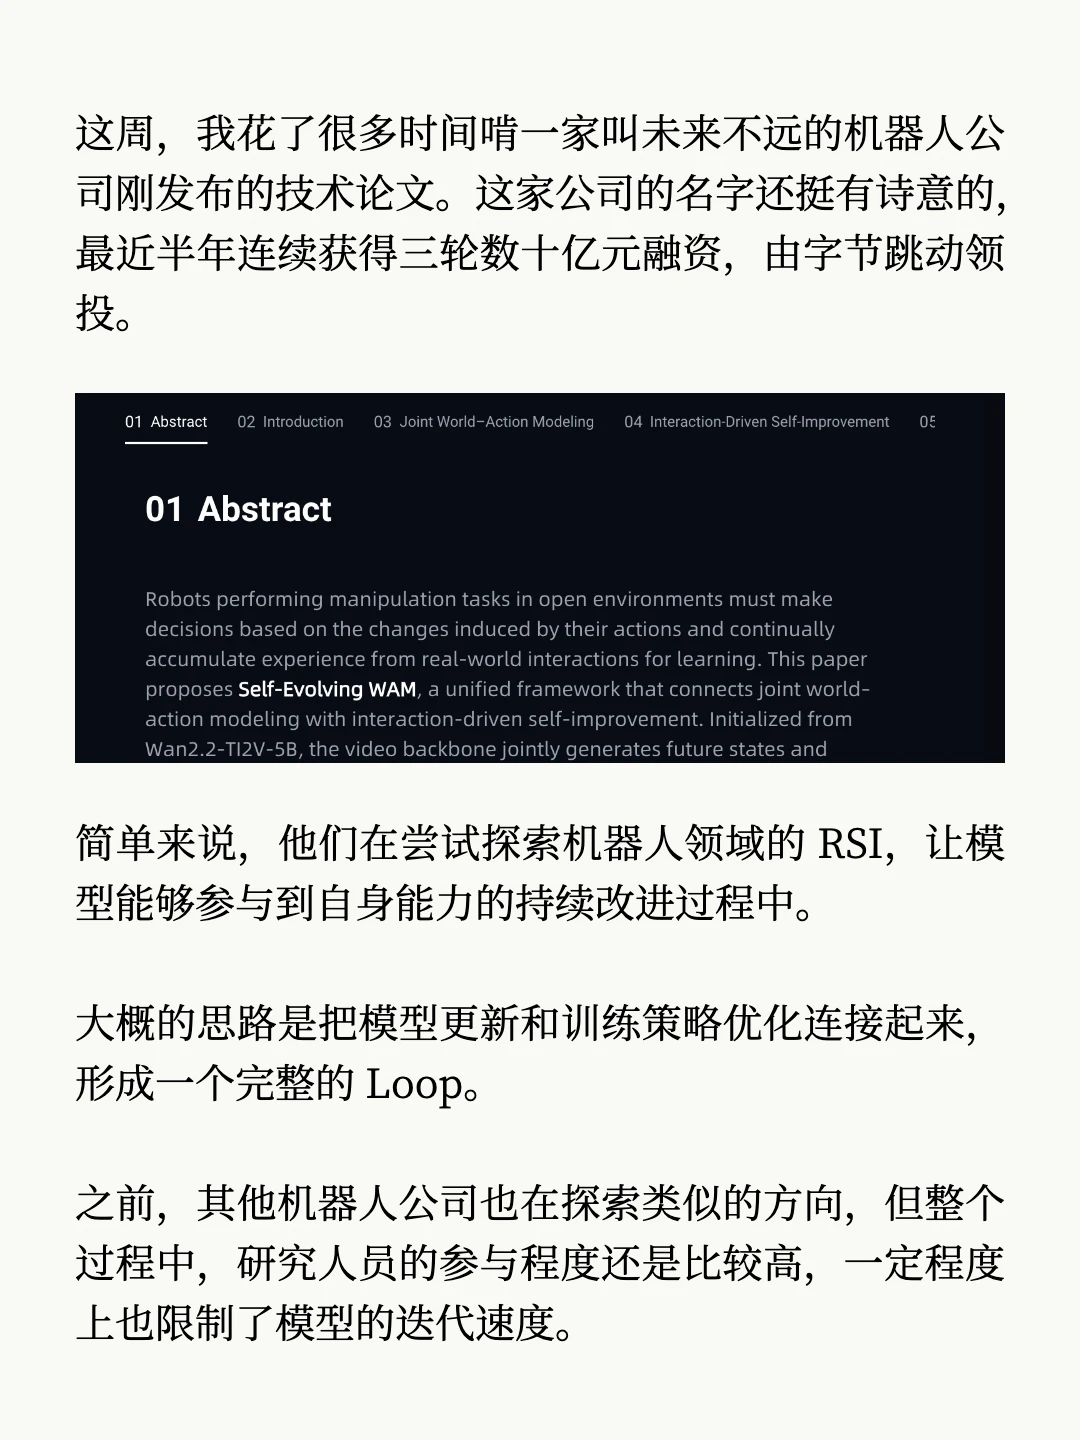
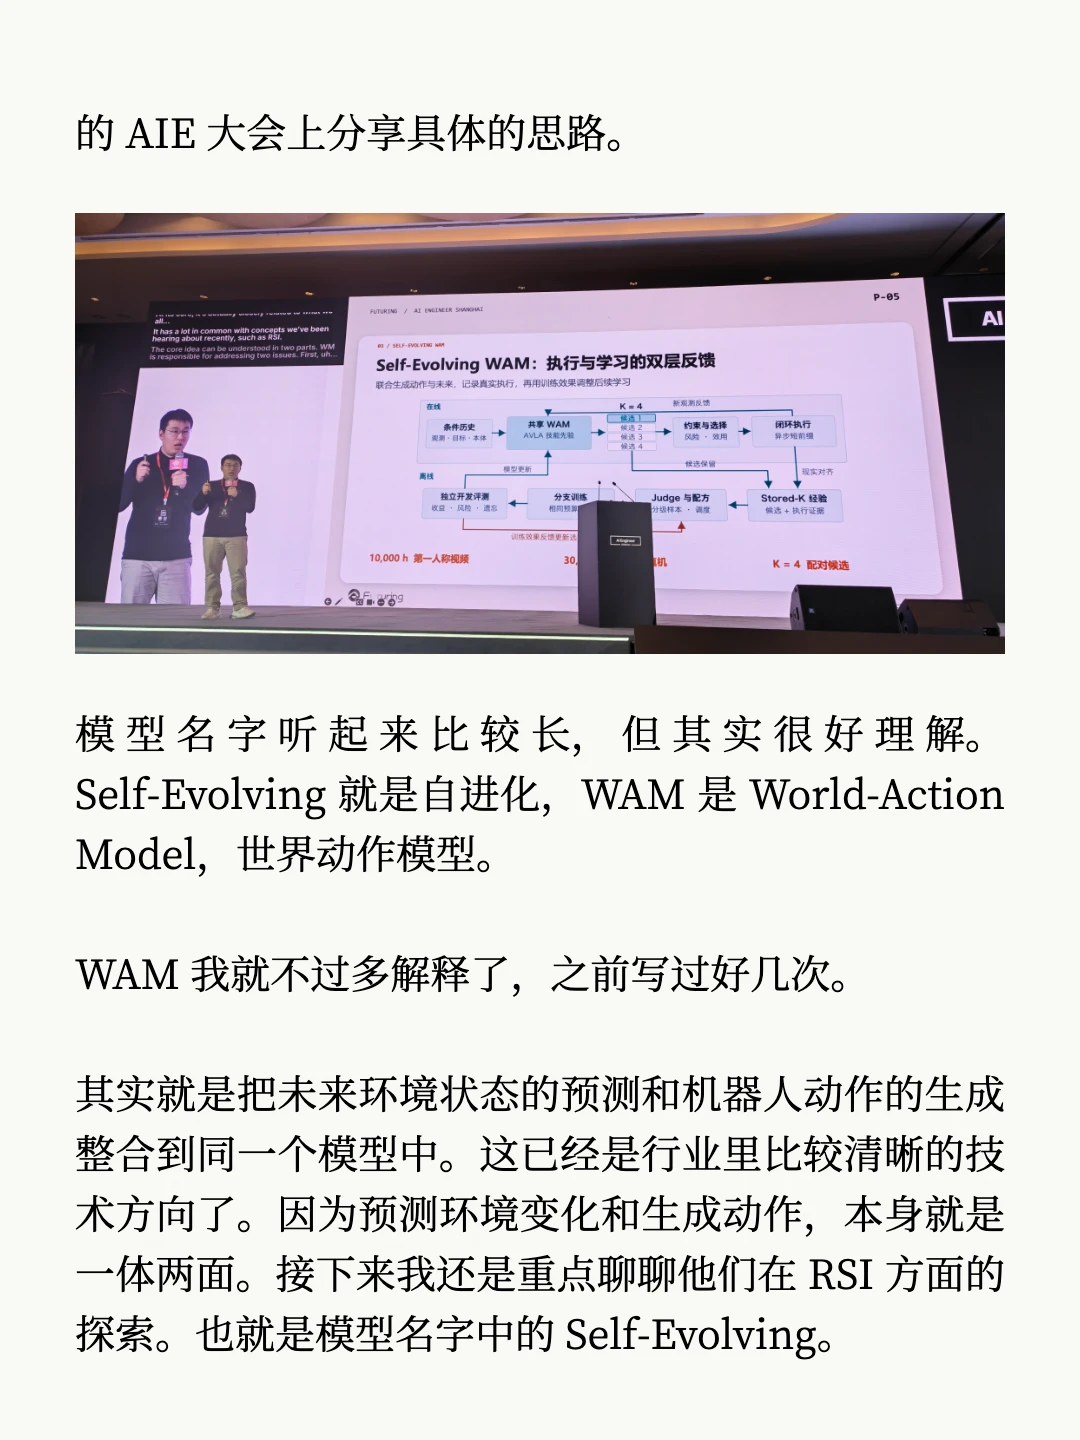
这周,我花了很多时间啃一家叫未来不远的机器人公司刚发布的技术论文。这家公司的名字还挺有诗意的,最近半年连续获得三轮数十亿元融资,由字节跳动领投。
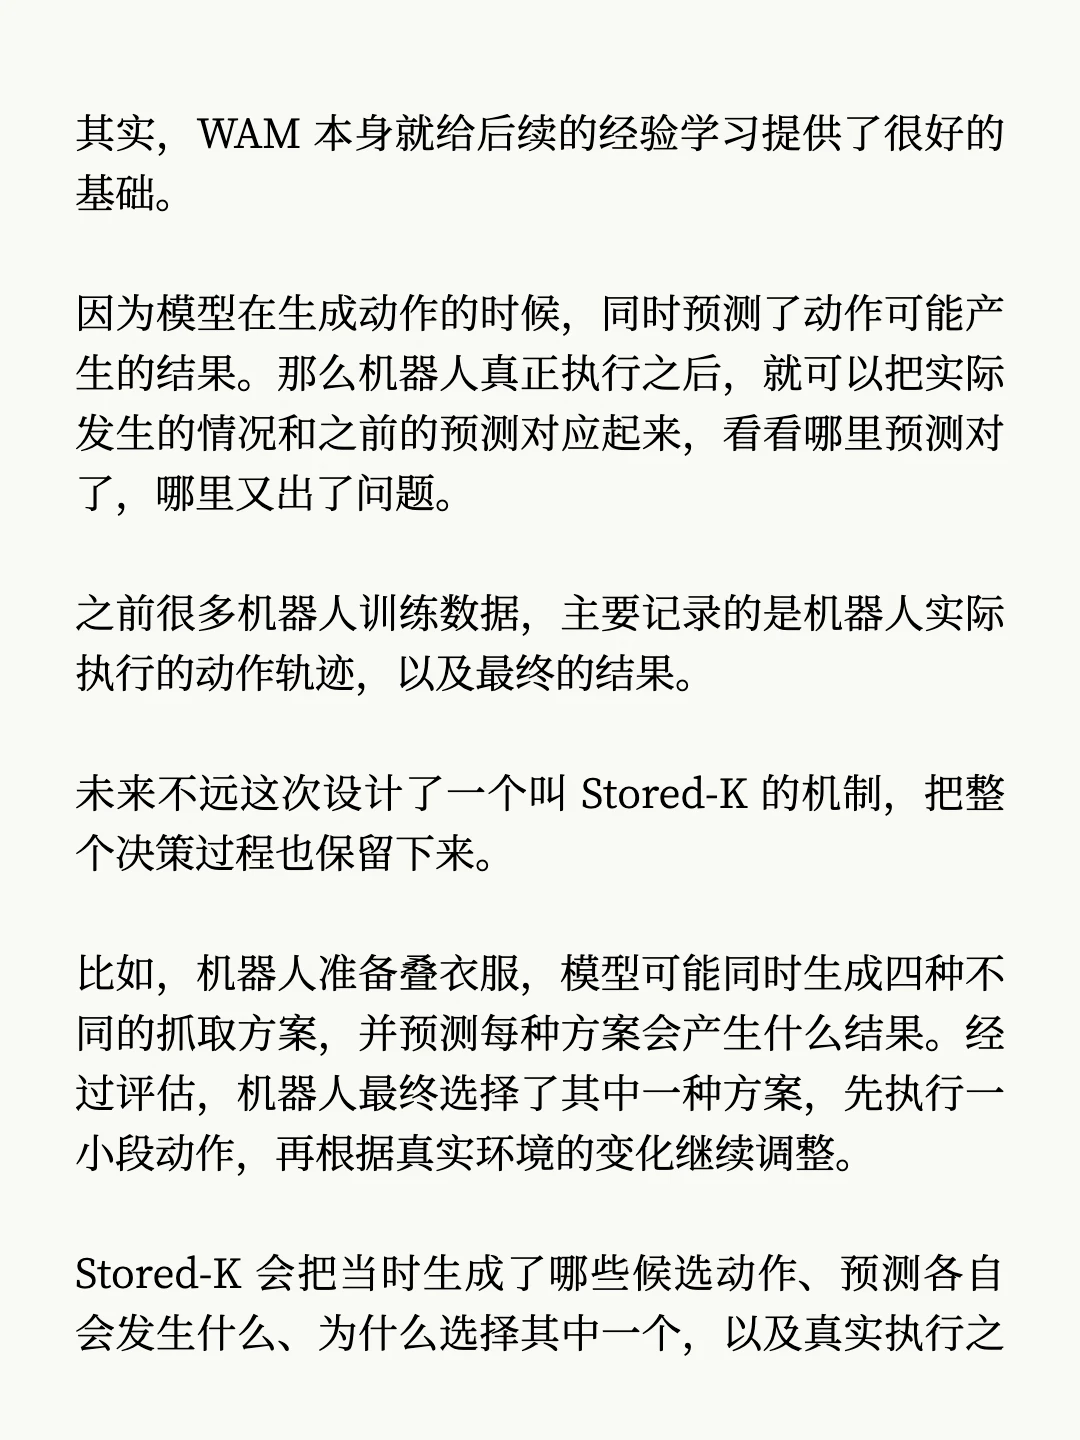
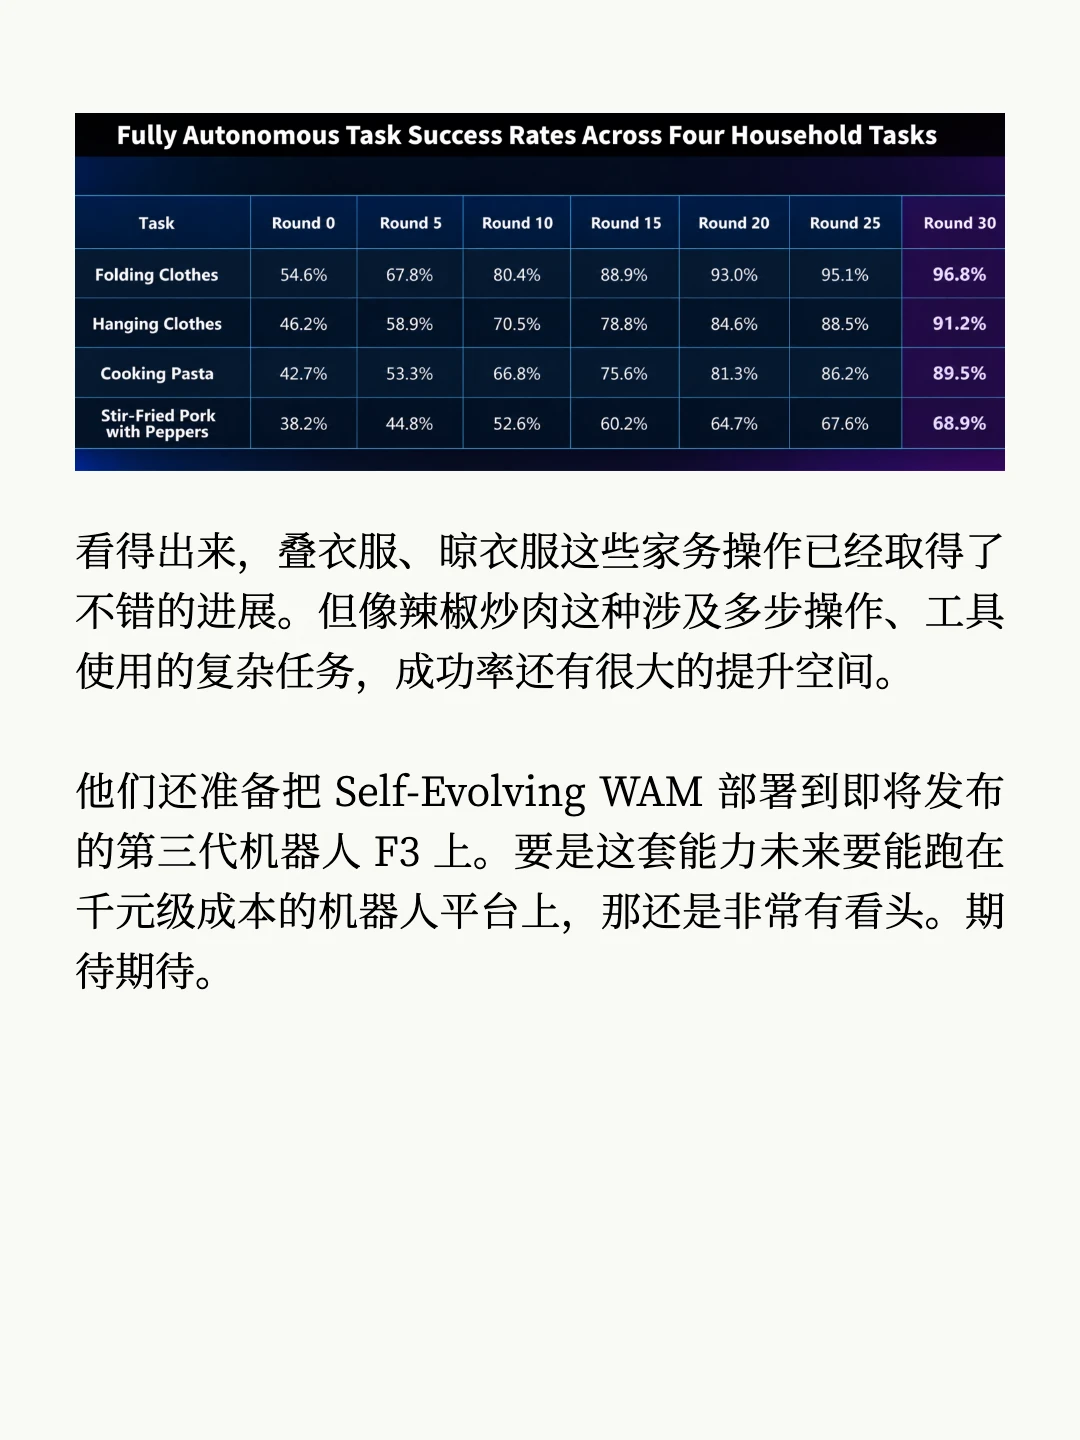
简单来说,他们在尝试探索机器人领域的 RSI,让模型能够参与到自身能力的持续改进过程中。大概的思路是把模型更新和训练策略优化连接起来,形成一个完整的 Loop。
之前,其他机器人公司也在探索类似的方向,但整个过程中,研究人员的参与程度还是比较高,一定程度上也限制了模型的迭代速度。
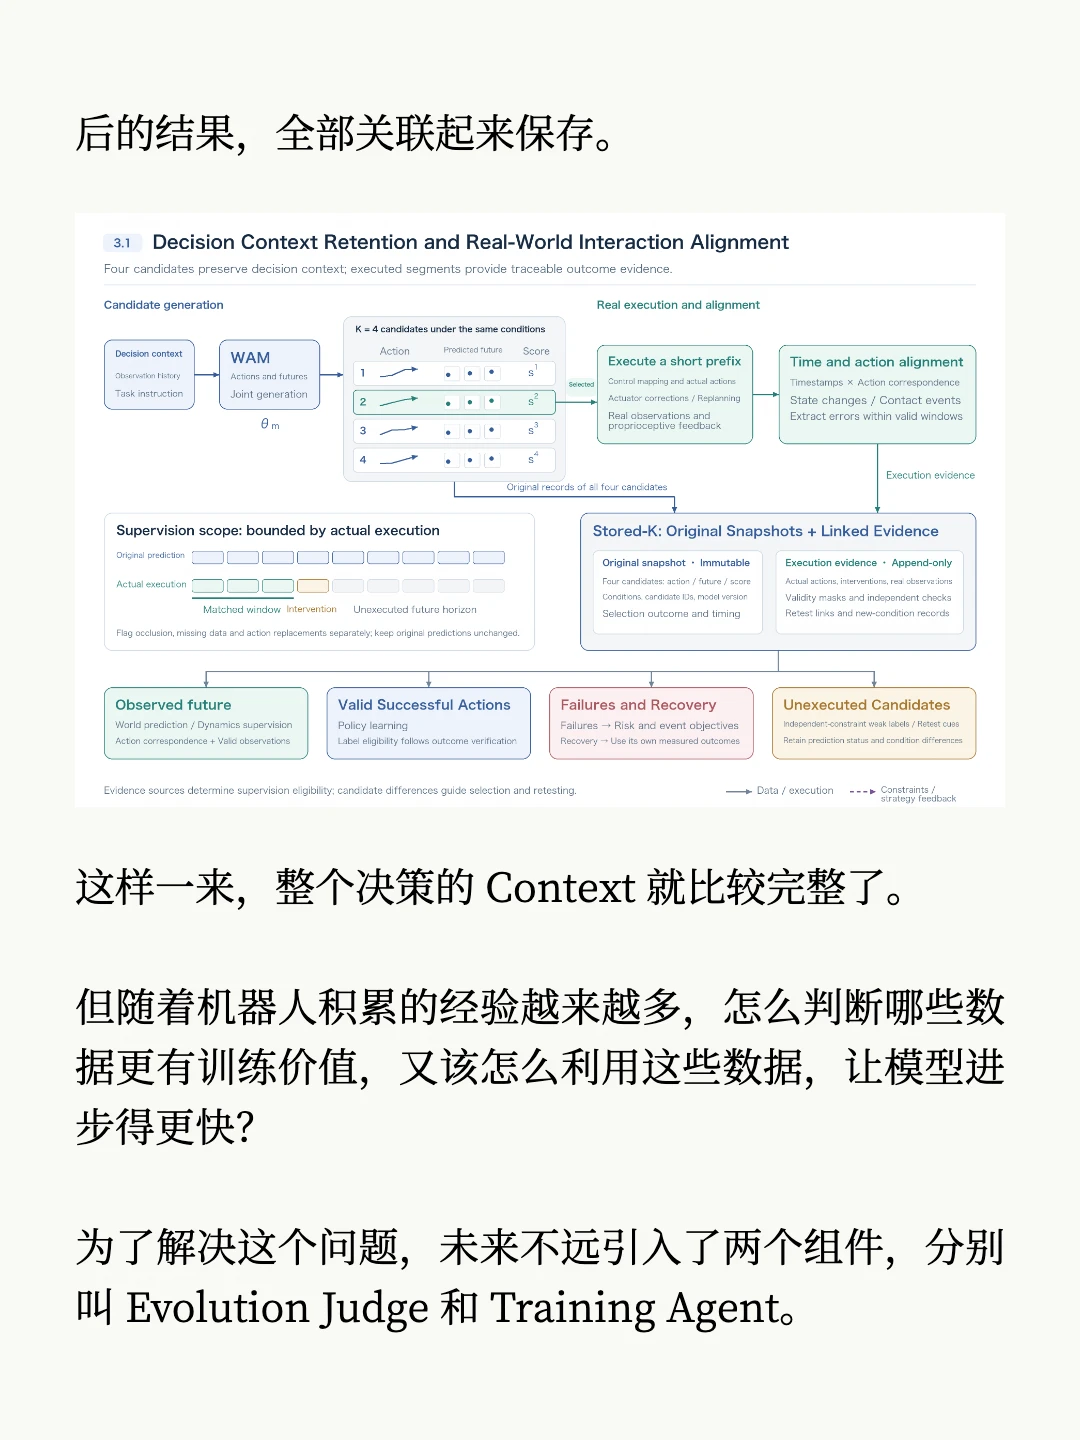
比如,机器人在真实世界里执行了 1 万次任务,积累了大量交互数据。有些操作成功了,有些失败了,还有些实际执行的结果和之前的预测不一样。
这些数据当然可以拿来继续训练模型,让机器人从经验中学习。这其实就是持续后训练,也不是什么新鲜事了。
但问题是,这么多数据,到底应该优先学习哪些?不同类型的数据应该怎么搭配?采用什么样的训练方式,才能让模型进步得更快?
过去,这些事情往往需要研究人员来决定。他们需要分析模型的表现,调整训练数据的比例和参数,再通过实验判断哪种方案效果更好。
而未来不远尝试让系统自己参与这个过程。
他们的系统会尝试不同的数据选择和训练配置,再根据每一轮训练之后的实际效果,调整下一轮应该优先学习哪些经验,以及怎么安排训练。
这样的话,就形成了一个自进化的 Loop:机器人执行任务,积累新的交互数据。
系统筛选这些经验,重新训练模型,再根据训练效果调整下一轮的训练策略。更新后的模型继续执行任务,产生新的数据,整个过程不断重复。
简直太有想象力了。
作为一个技术宅男,我特别喜欢研究具身智能领域这些最新的技术探索。
有时候我就觉得,整个行业好像都在茫茫大海上探索方向,谁也不知道哪条路最终能走得通。
但大家面对的很多问题又是共通的,不同团队会从不同角度尝试解决。
#ai #未来不远机器人 #具身智能 #AIE #世界模型 #RSI