一台智算机柜里的半导体生态“智算机柜的整体实力,来自数千颗芯片协同工作”
人工智能的竞争,不只是模型参数与加速器性能的竞争,也是整套半导体系统的协同能力之争。理解一座智算中心,要看计算是否高效、数据是否畅通、供电是否稳定,更要看这些环节能否持续配合。真正支撑人工智能走得更远的,是整条芯片产业链。
一次模型训练或推理,表面上是在执行算法,底层却是数据在存储器、处理器和网络之间不断流动。加速器负责计算,其他芯片负责送数据、供电与监测。理解人工智能基础设施,不能只看最昂贵的处理器,还要看支撑它持续工作的整个半导体系统。
✤ 1 ✤ 读懂价值
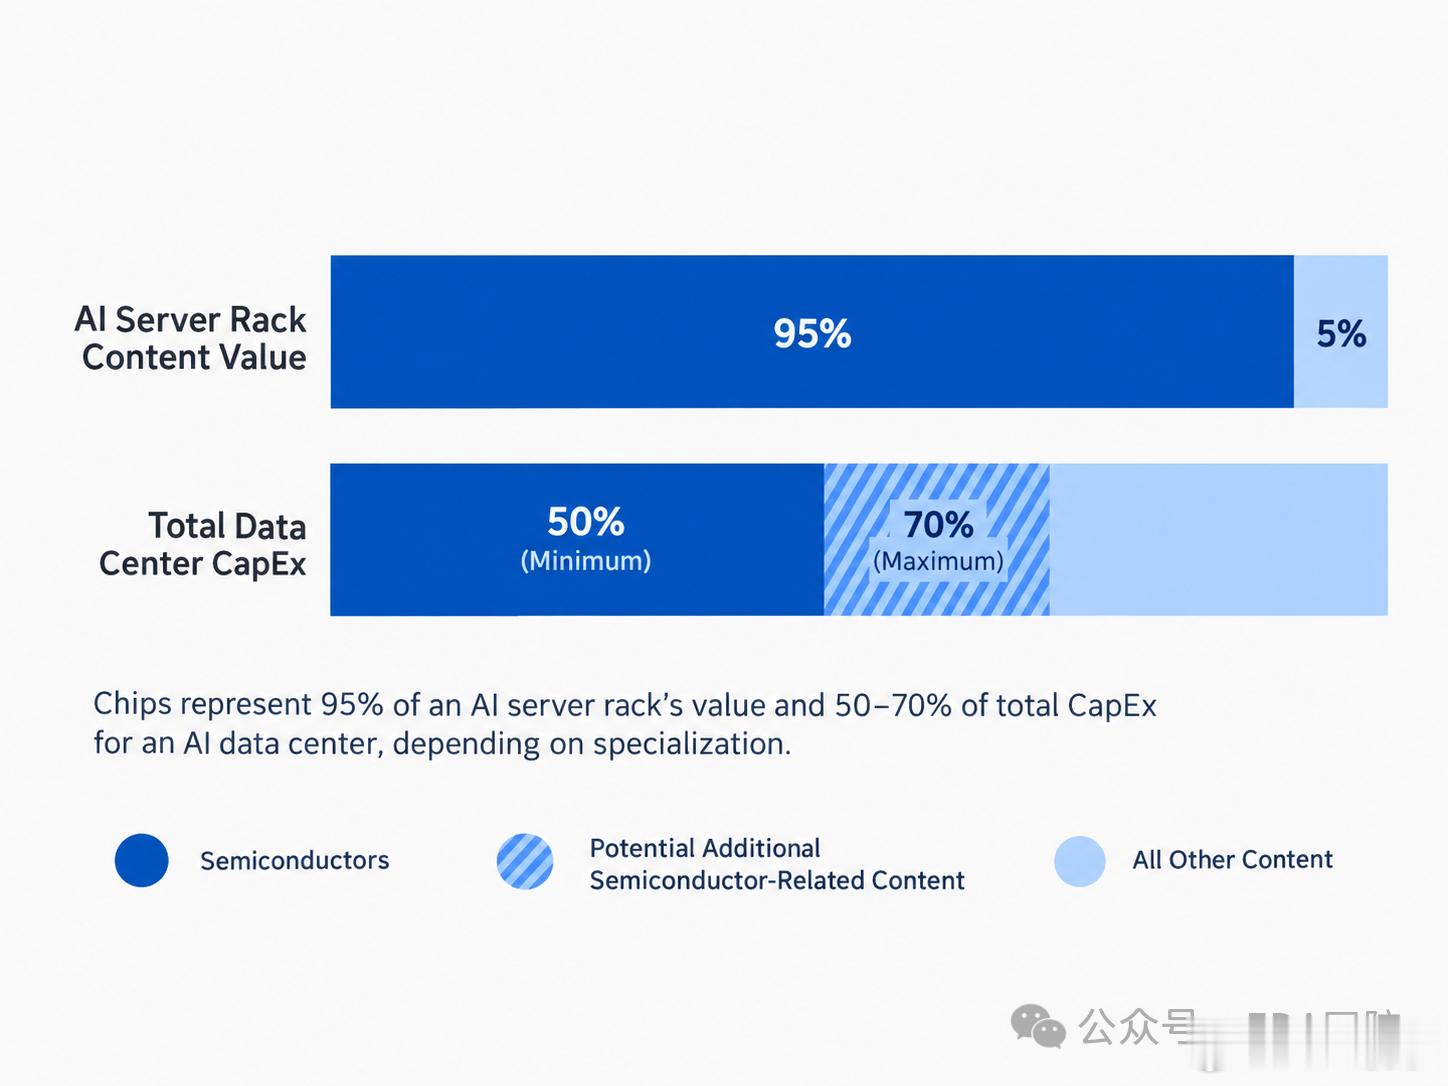
在所分析的领先AI服务器机柜中,封装芯片超过4500颗,半导体约占机柜器件价值的95%。这里统计的是整套半导体器件,不是GPU单独占了95%,也不是所有服务器都有相同配置。
放大到整个AI数据中心,半导体相关投入约占总资本开支的50%—70%,比例随用途与配置变化。两组数字的分母不同:一个是机柜器件价值,一个是数据中心资本开支。资本开支也不能直接等同于包含持续电费、日常运维的全生命周期成本。
另外,封装芯片不等于裸片,一颗封装器件可以集成多颗裸片。比较芯片数量、成本或集成度时,必须先统一统计口径。
✤ 2 ✤ 计算与互连
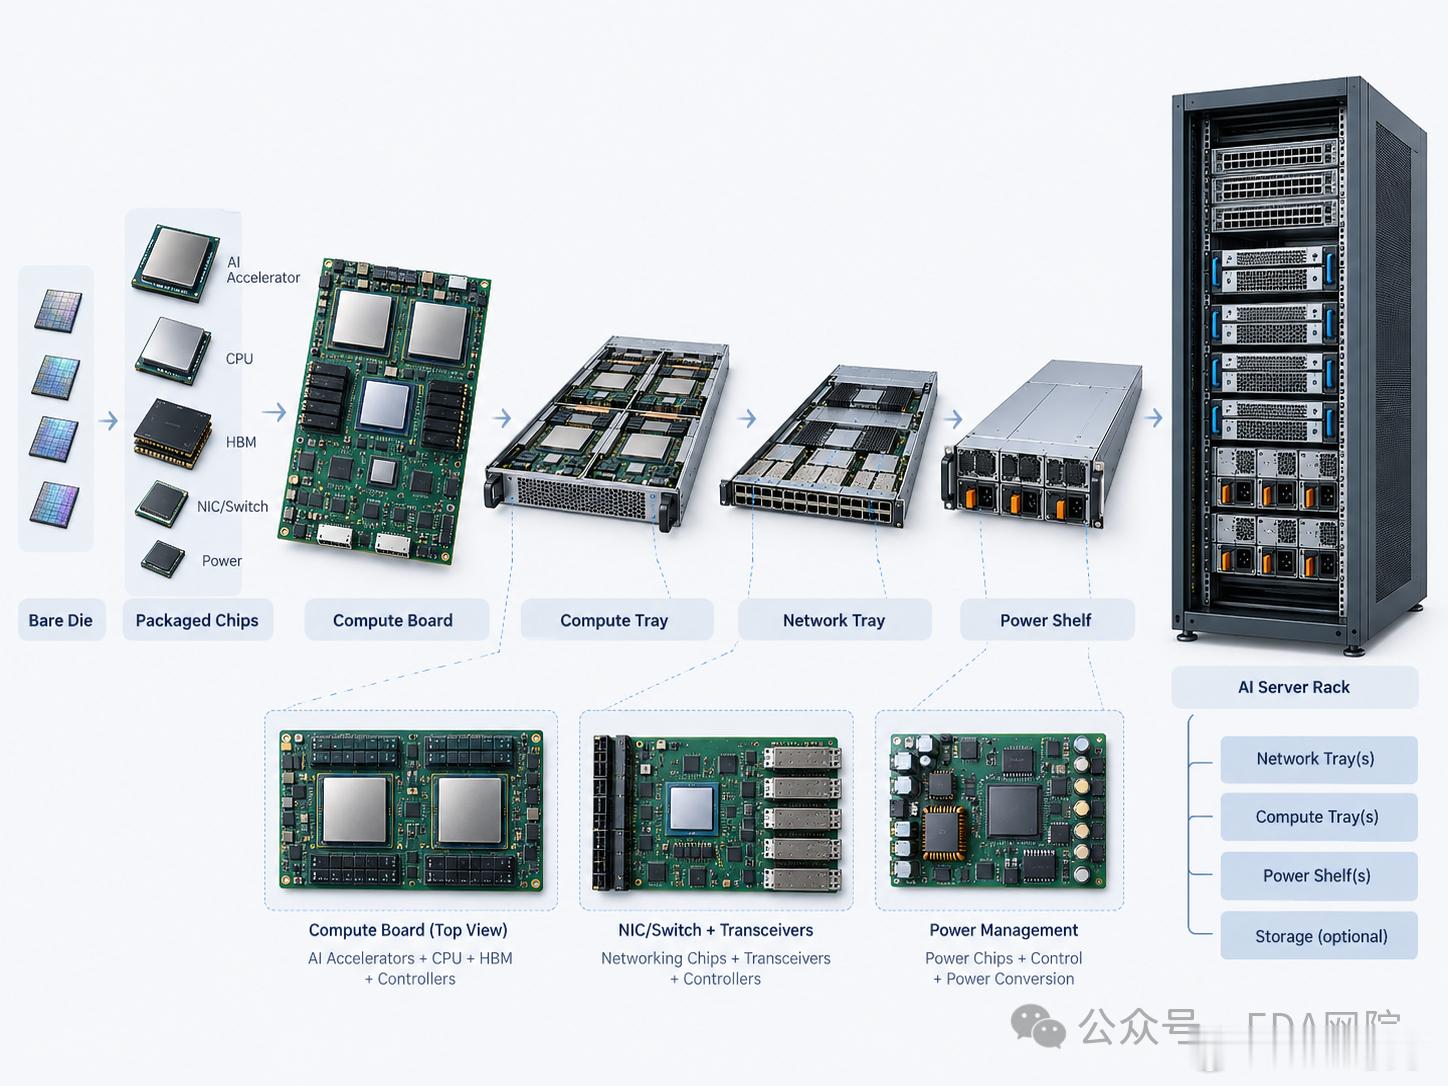
逻辑芯片承担计算与协调:GPU或专用ASIC处理大规模并行运算,CPU组织系统任务,DPU可分担基础设施处理,交换芯片与网络接口负责设备间通信。部分方案还会采用可编程的FPGA,具体组合由工作负载与架构决定。
例如,GB200 NVL72将36颗CPU和72颗GPU集成在一个机柜中,并通过高速互连协同工作。这不是简单堆叠处理器,而是让多个计算节点能够持续交换数据。
因此,评价AI硬件不能只相加峰值算力。数据交换不及时,计算单元就可能等待;互连能力同样影响实际吞吐。
✤ 3 ✤ 存储层次
存储体系不是容量越大就越好,而是不同层次各司其职:HBM靠近加速器提供高带宽访问,系统DRAM承载运行中的数据,SRAM常作为处理器内部缓存,NAND闪存用于保存模型、数据集和检查点。
需要注意,HBM本身也是DRAM技术的一种,SRAM也不一定以独立封装出现,不能把技术名称直接当成互不重叠的芯片清单。
模型能否放得下,与运行时能否及时读到数据,是两个不同问题。容量、带宽、延迟与能耗需要一起权衡;只升级计算芯片,并不会自动消除数据访问瓶颈。
✤ 4 ✤ 供电与控制
电源管理芯片、功率器件、收发器、控制器和传感器很少成为宣传主角,却支撑着供电、通信与状态监测。文首机柜配图中的电源模块、计算托盘和交换托盘,正体现了这种分工。
电力从输入端送到处理器核心,需要经过转换、稳压与保护。转换损耗会增加发热,负载突变又要求供电及时响应。提高算力密度,不只是把更多计算芯片装进机柜,还要让供电系统跟得上。
这些器件未必采用最先进制程,却承担不可缺少的功能。芯片单价、价值占比与功能重要性,是三个不同维度。 系统设计不能只围绕最贵的器件展开。
✤ 5 ✤ 双向推动
芯片进步为更复杂、更高效的AI系统提供条件,AI也开始参与芯片研发。例如,AI设计优化工具可以探索不同实现方案,在功耗、性能与面积之间寻找更好的组合;AI方法也被用于辅助半导体制造优化。
这是一种相互推动的关系。模型与应用提出新需求,推动计算、存储和互连升级;新的芯片技术又为应用扩展提供条件。
判断进步是否有效,最终应回到真实任务:吞吐是否提升,响应是否及时,能耗是否降低,运行是否稳定。比单颗器件更值得关注的,是整套系统能否持续发挥性能。