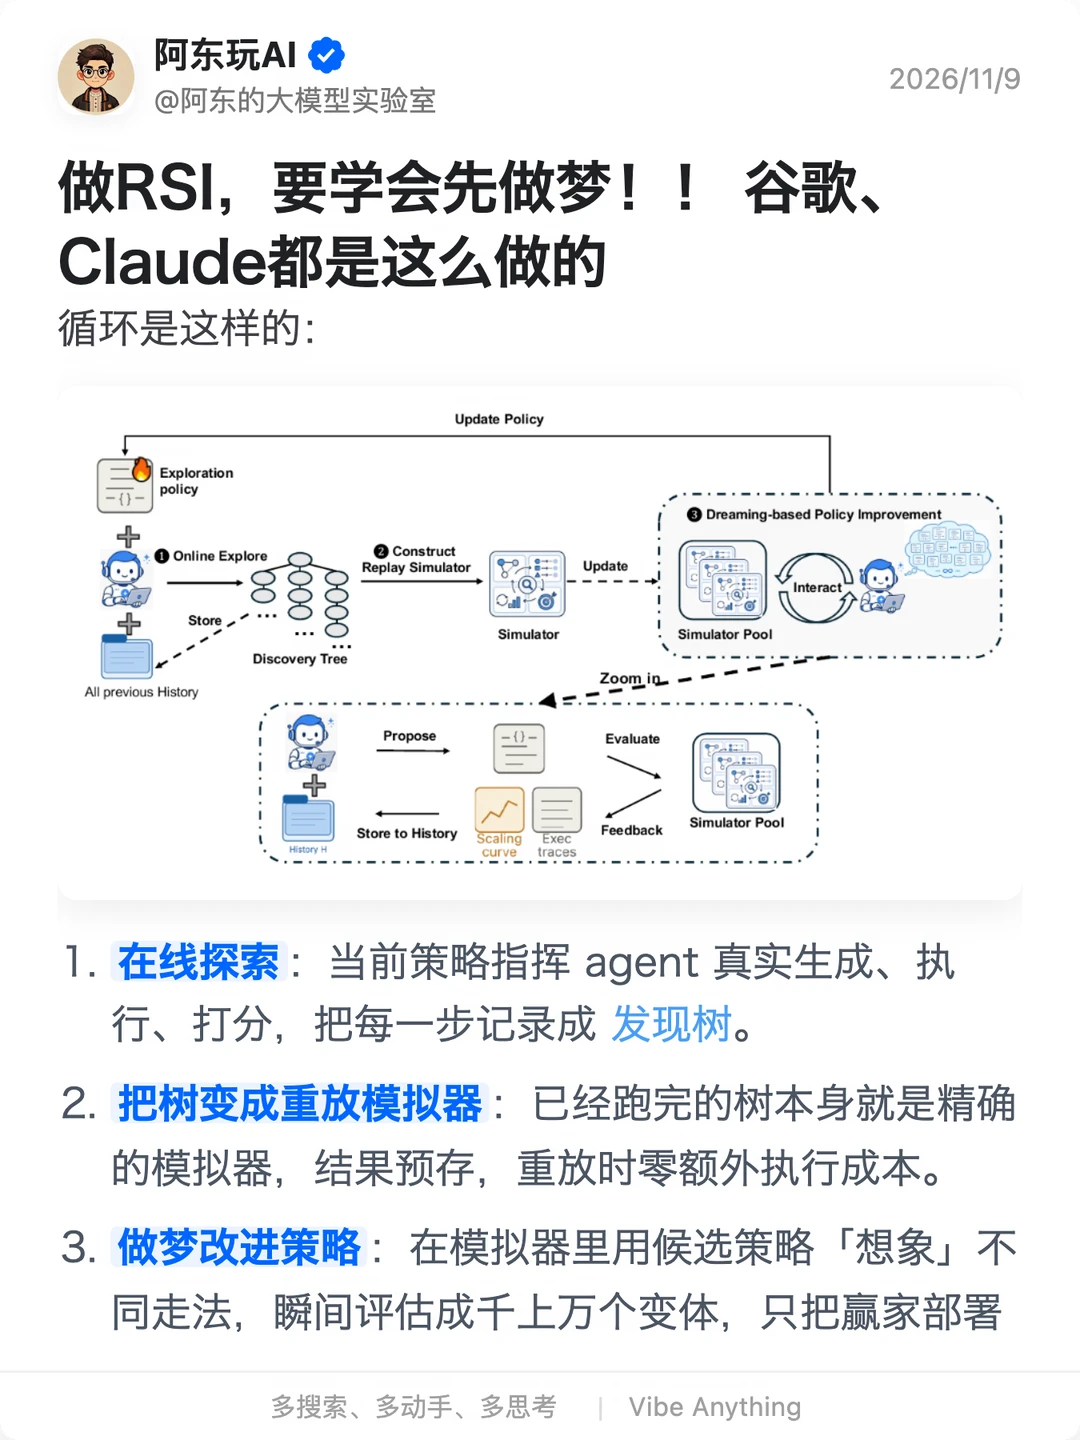
最近身边的朋友都在聊RSI,Google 和 Anthropic 几乎同时公开了同一个思路——智能体想自我改进,先得会「做梦」。
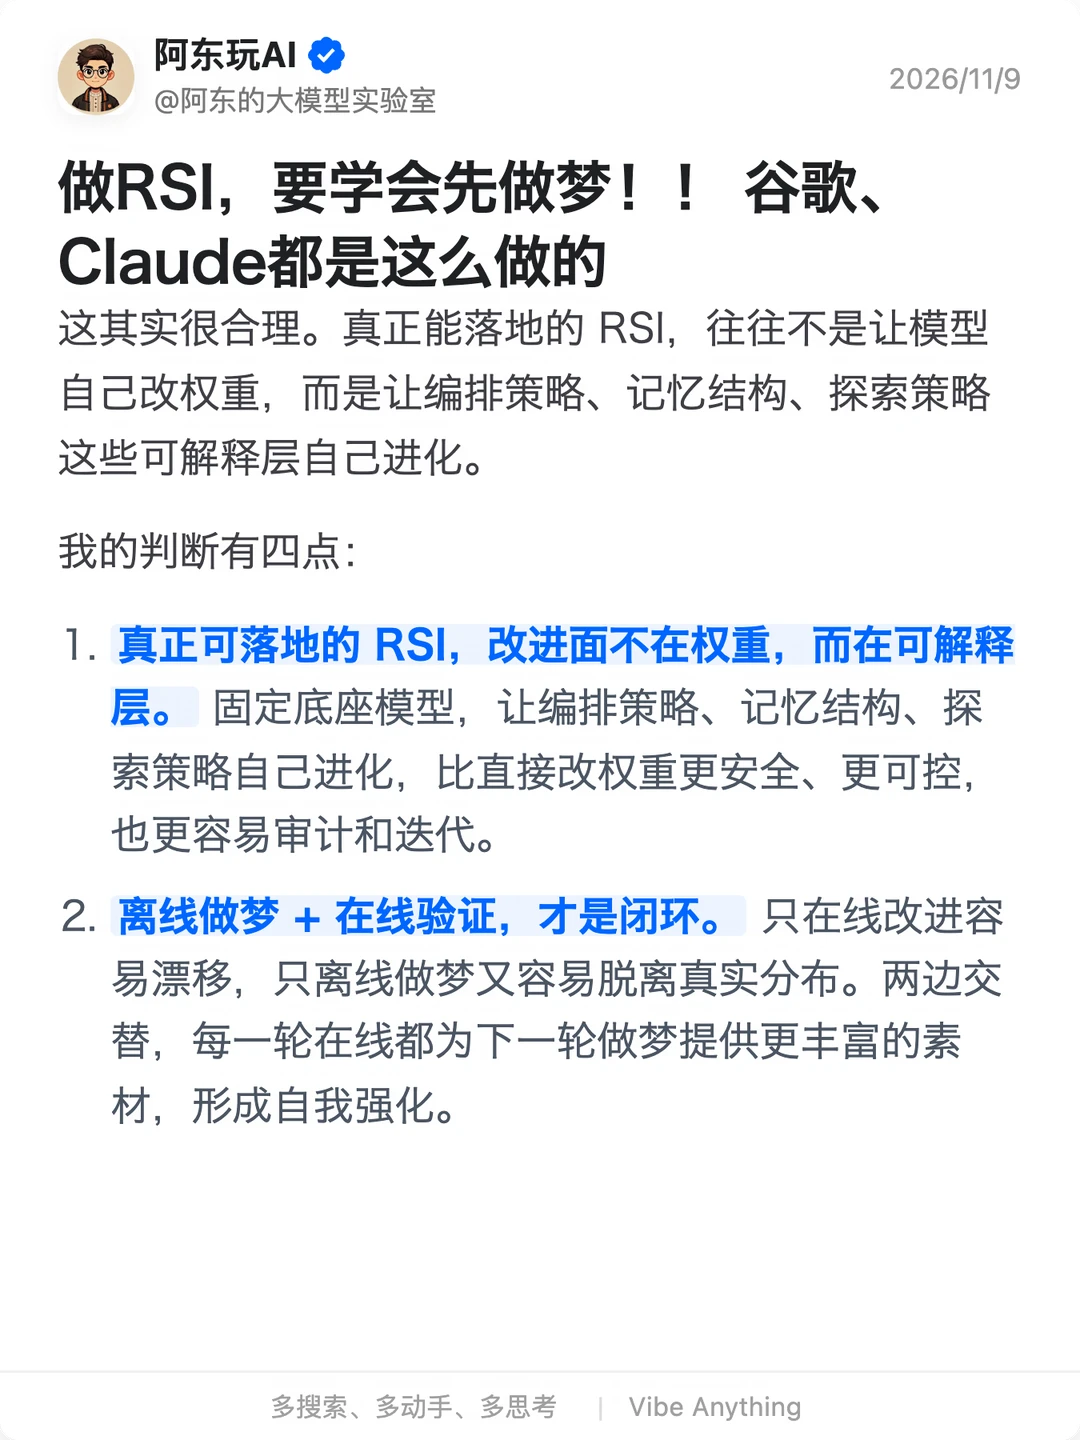
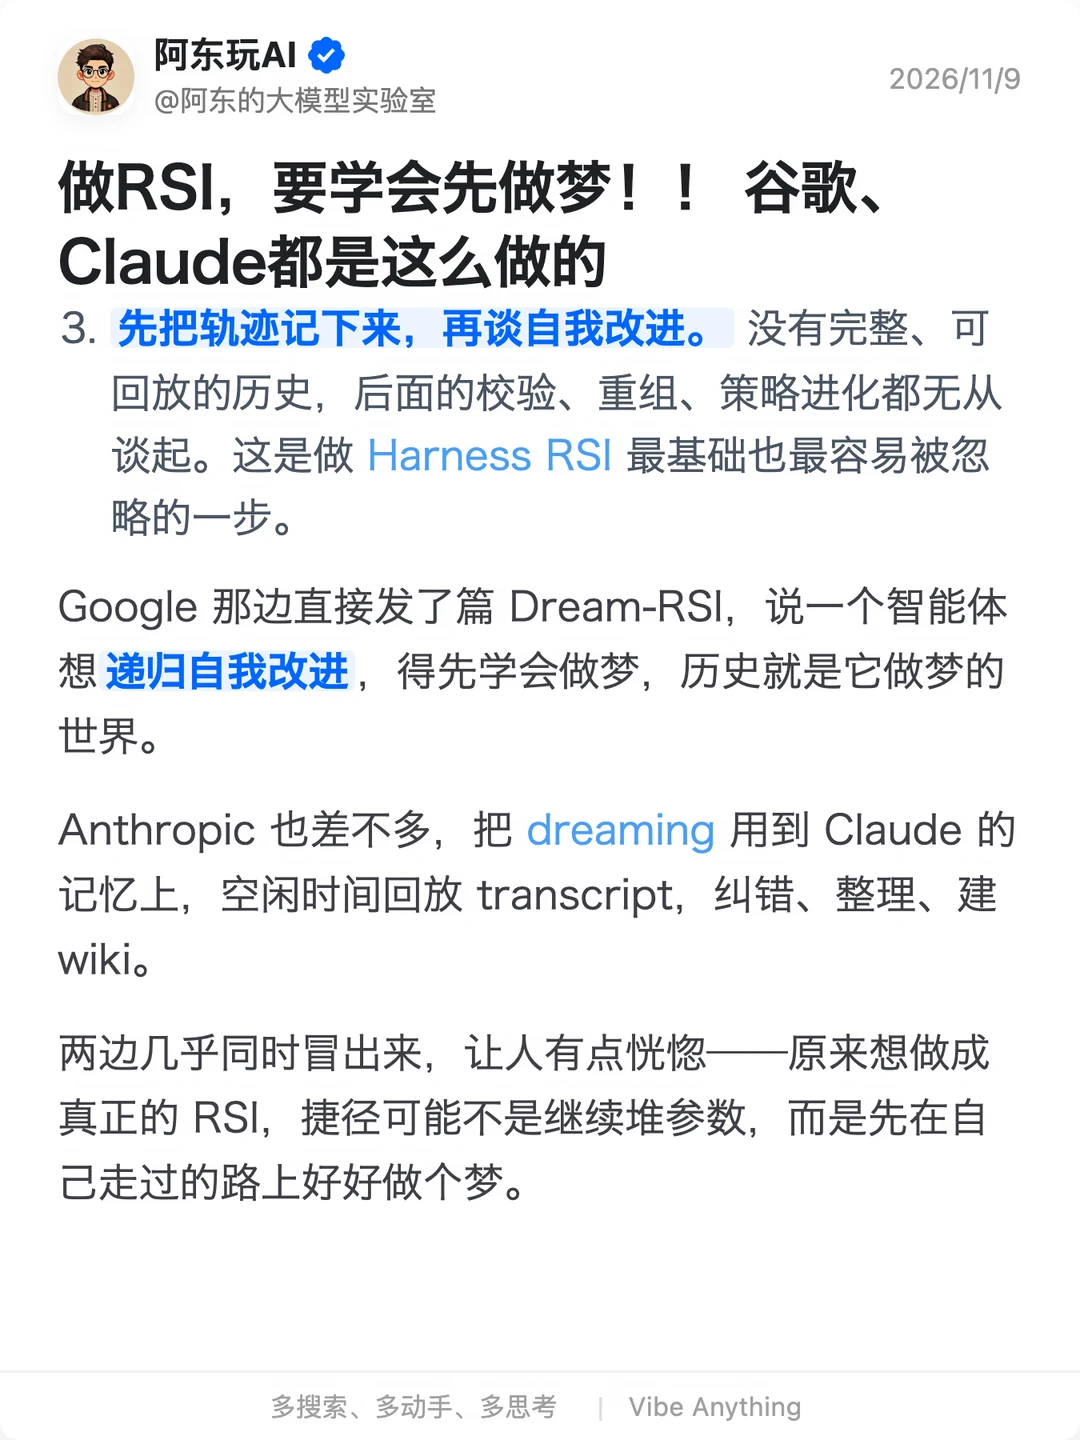
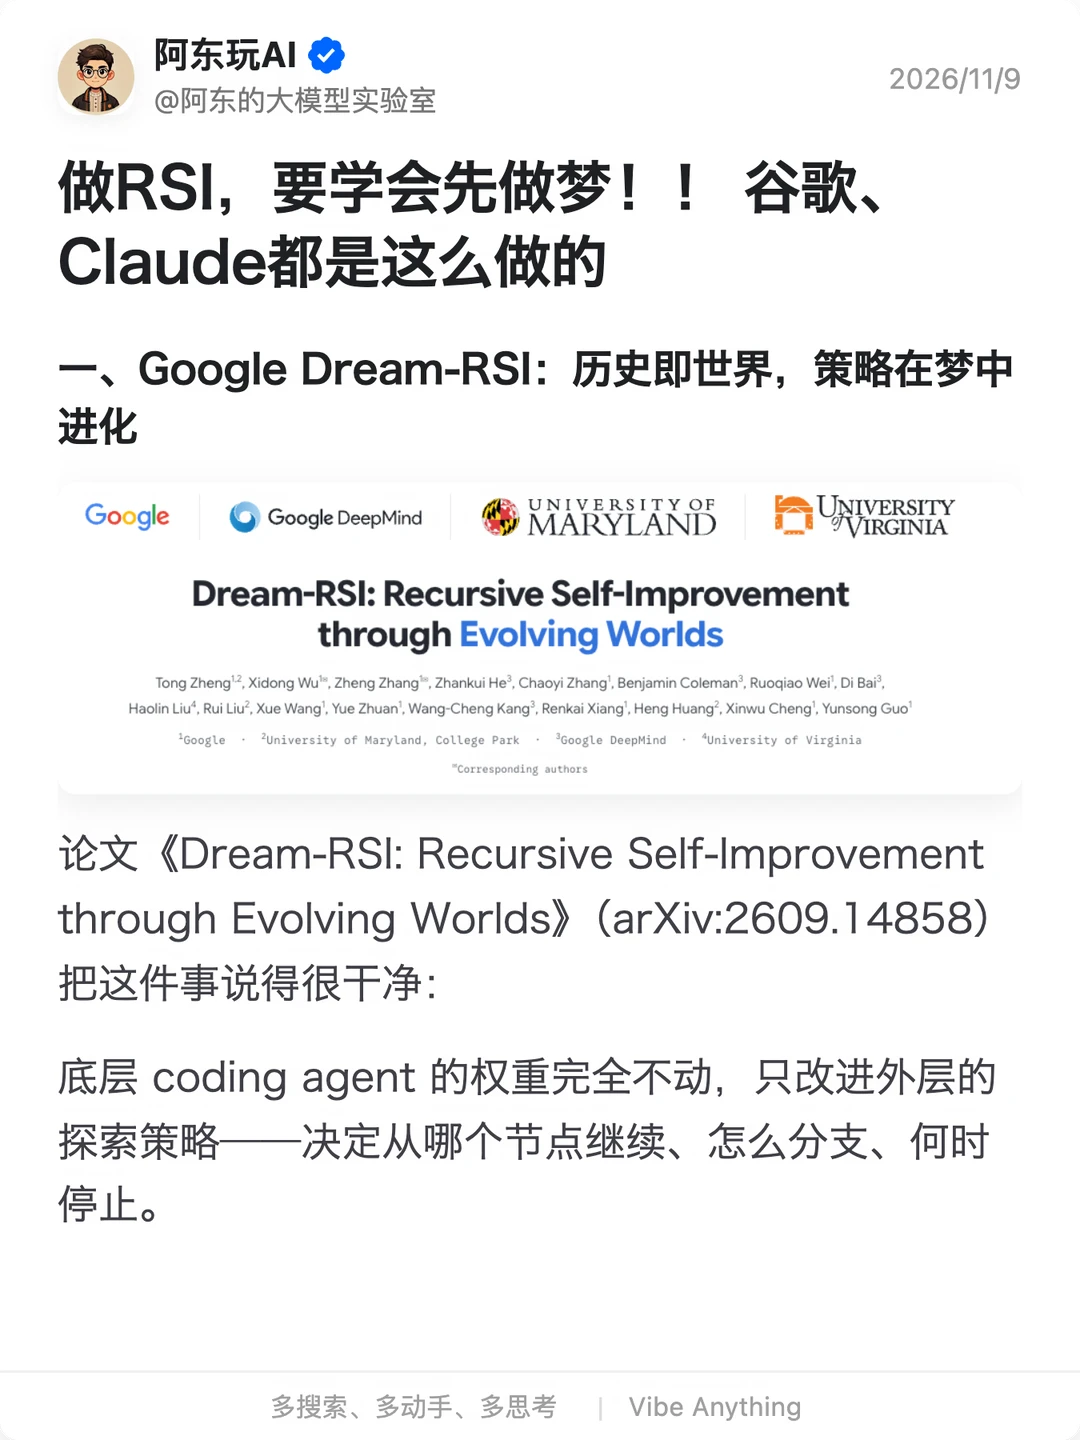
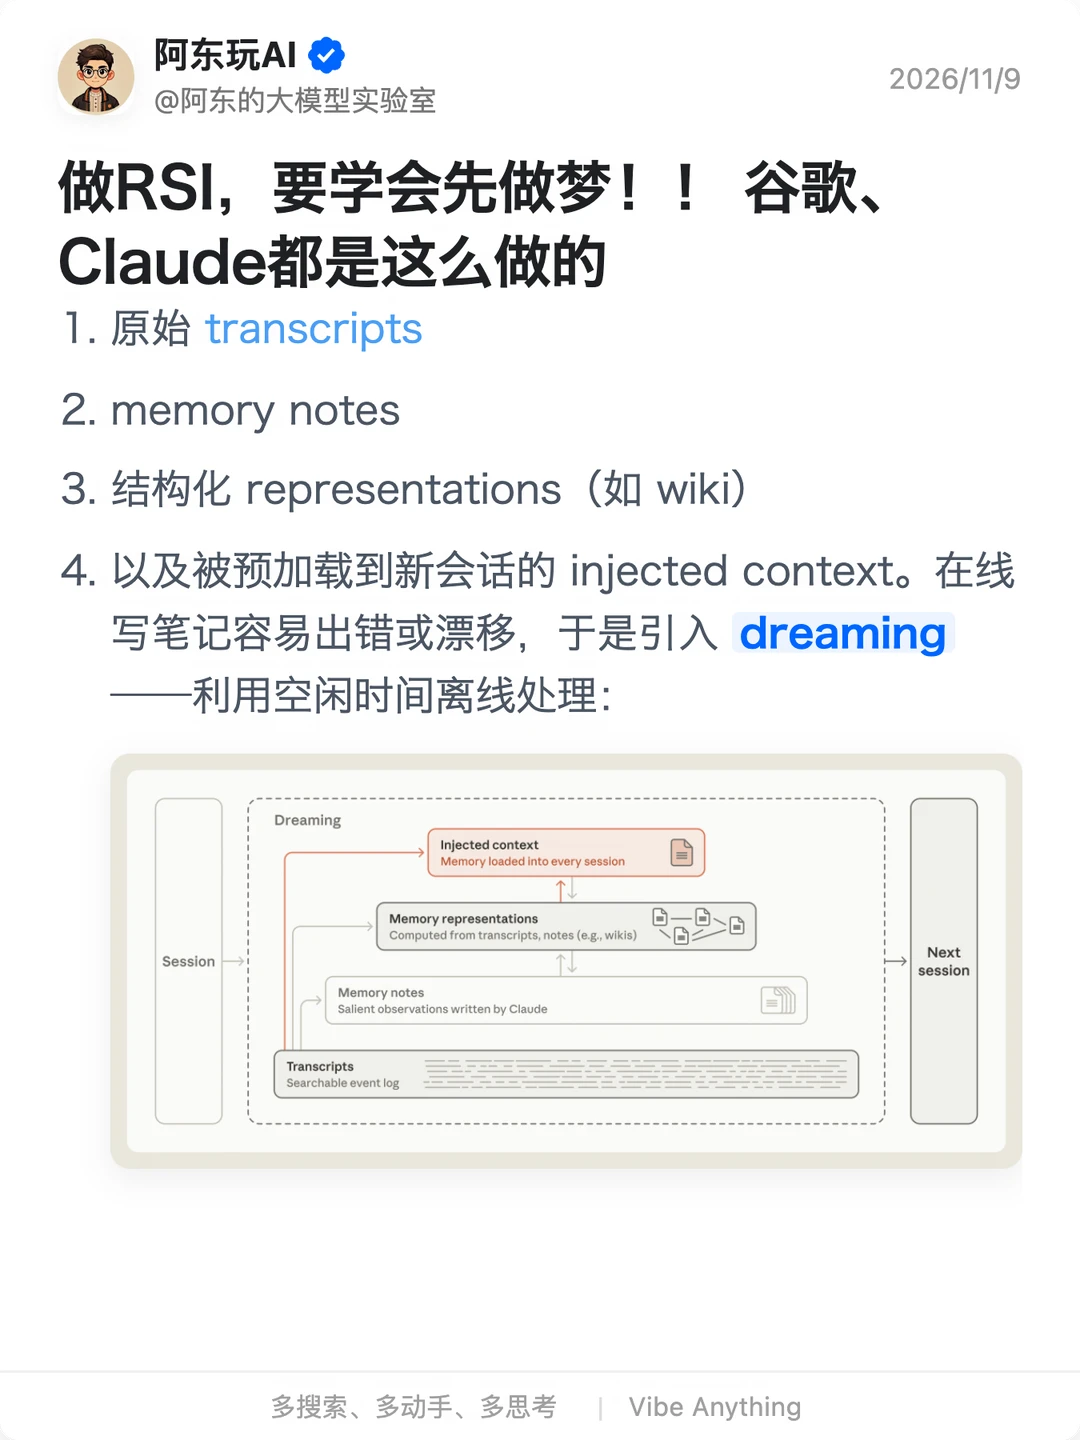
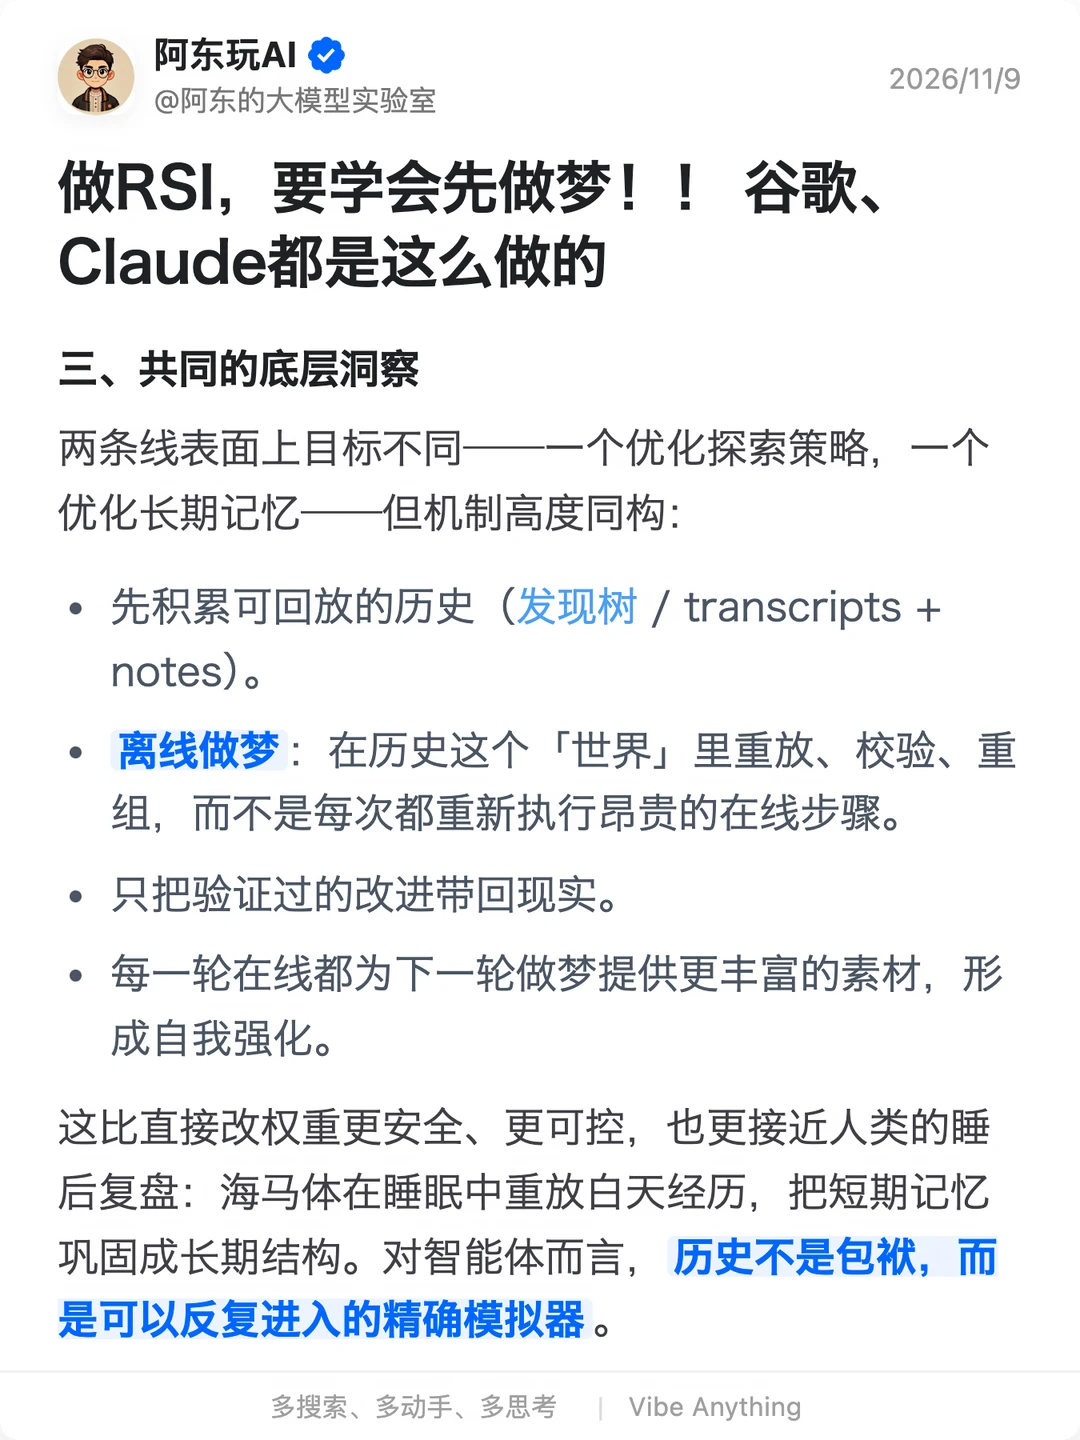
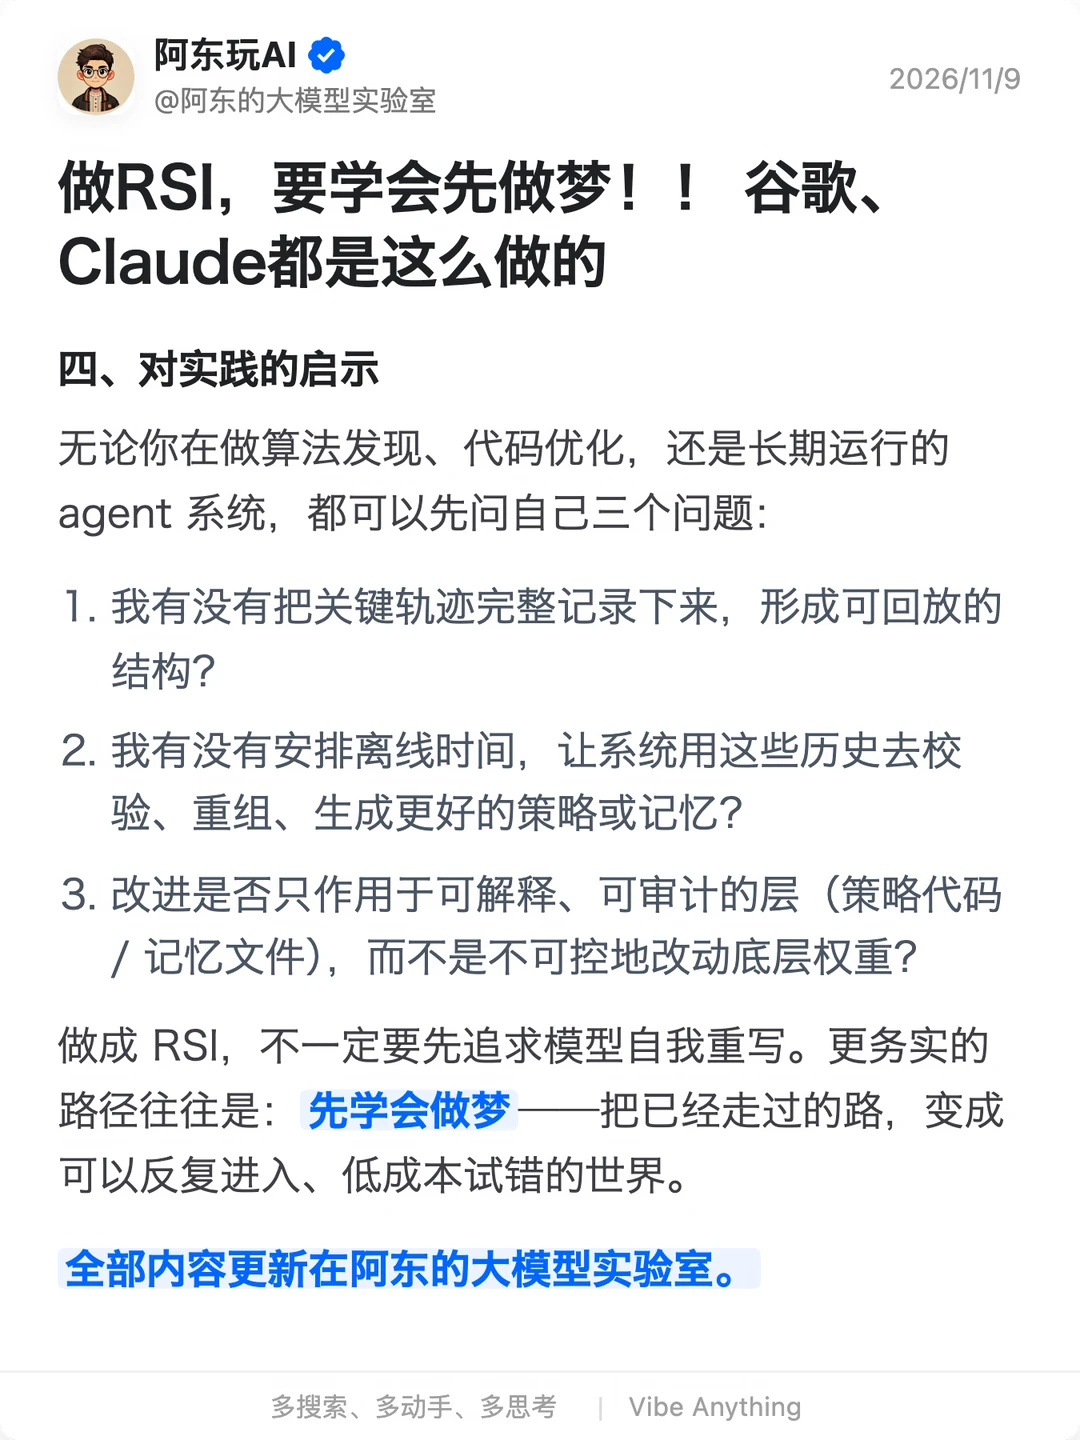
不改模型权重,而是把跑过的每一条轨迹存下来,空闲时离线重放、提炼出更好的策略。
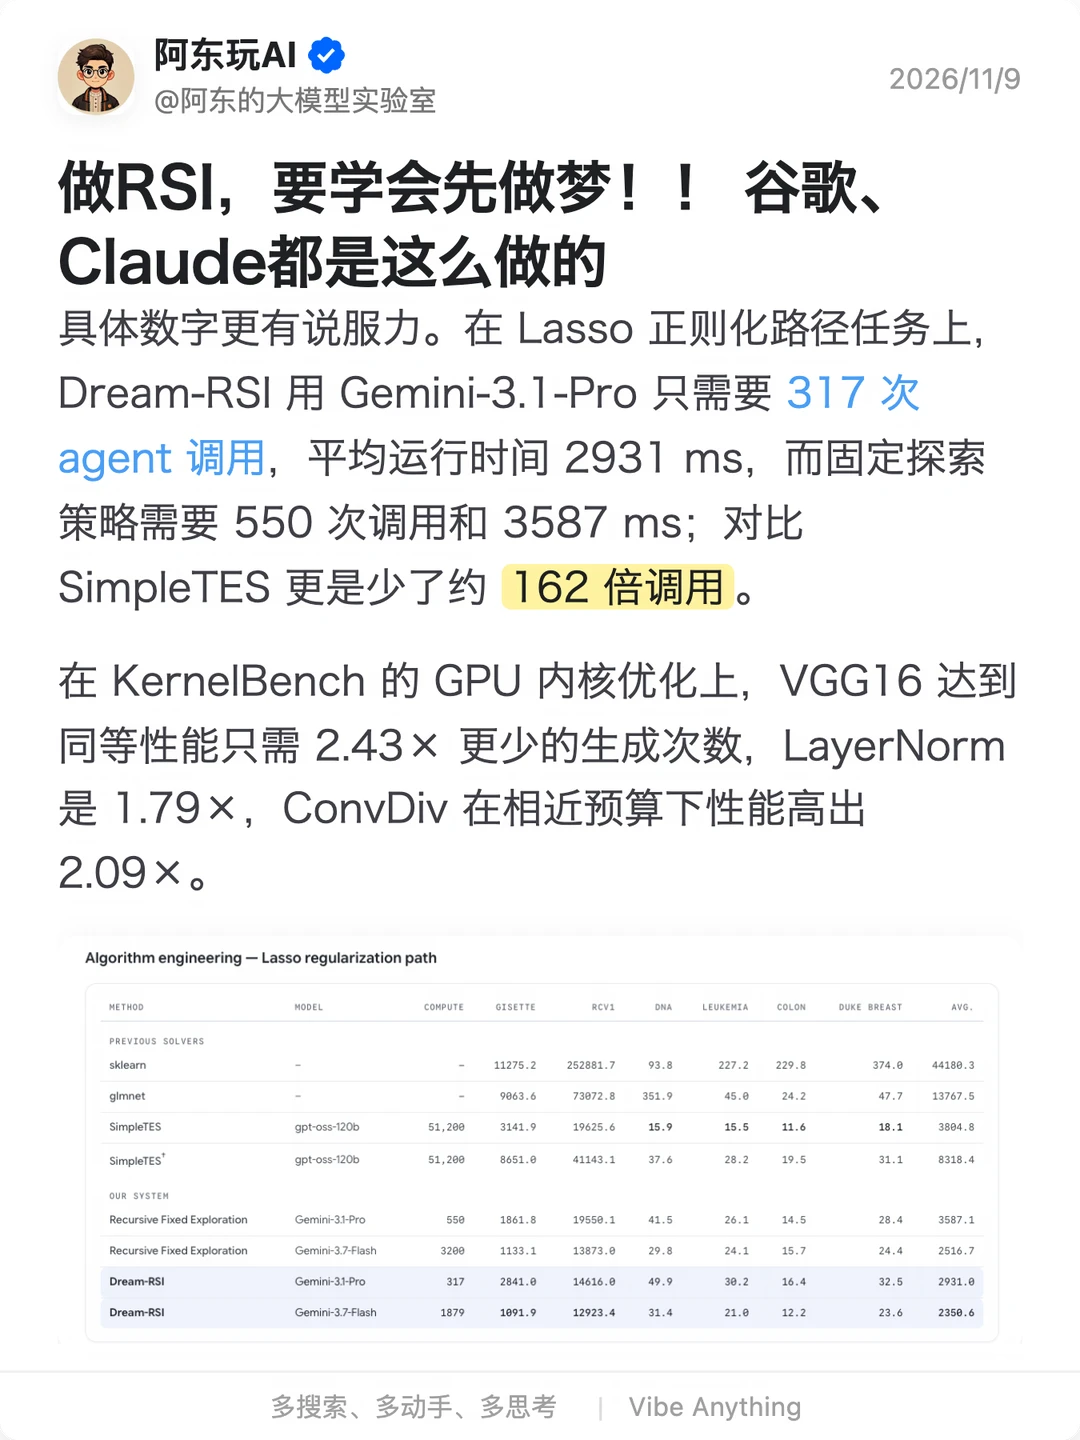
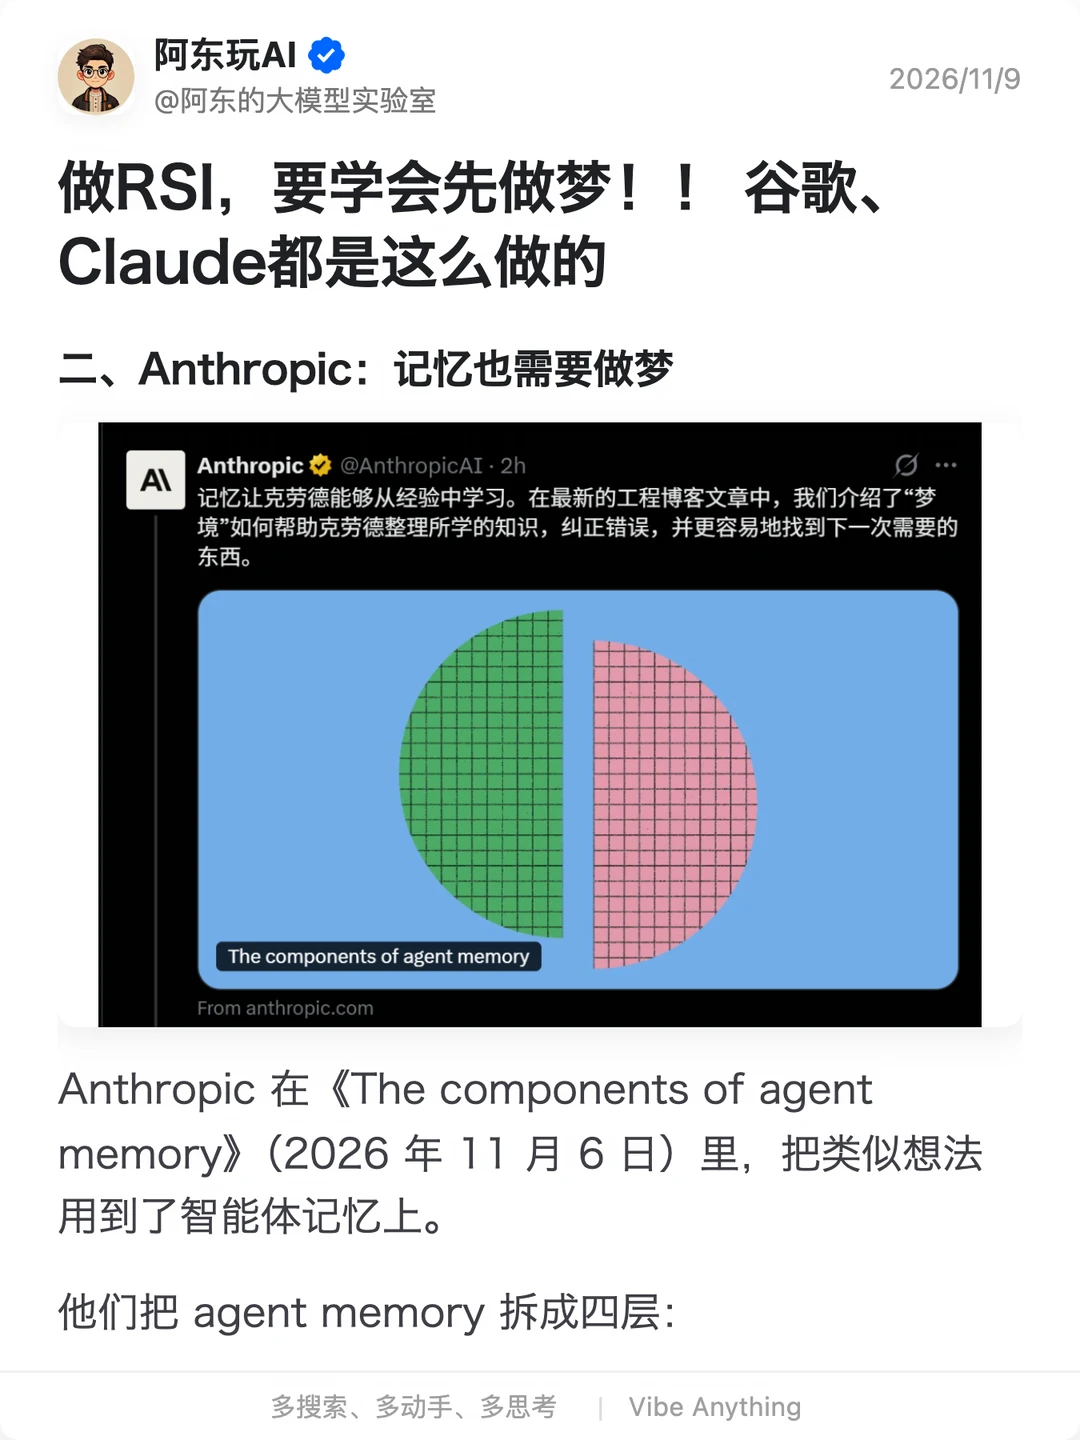
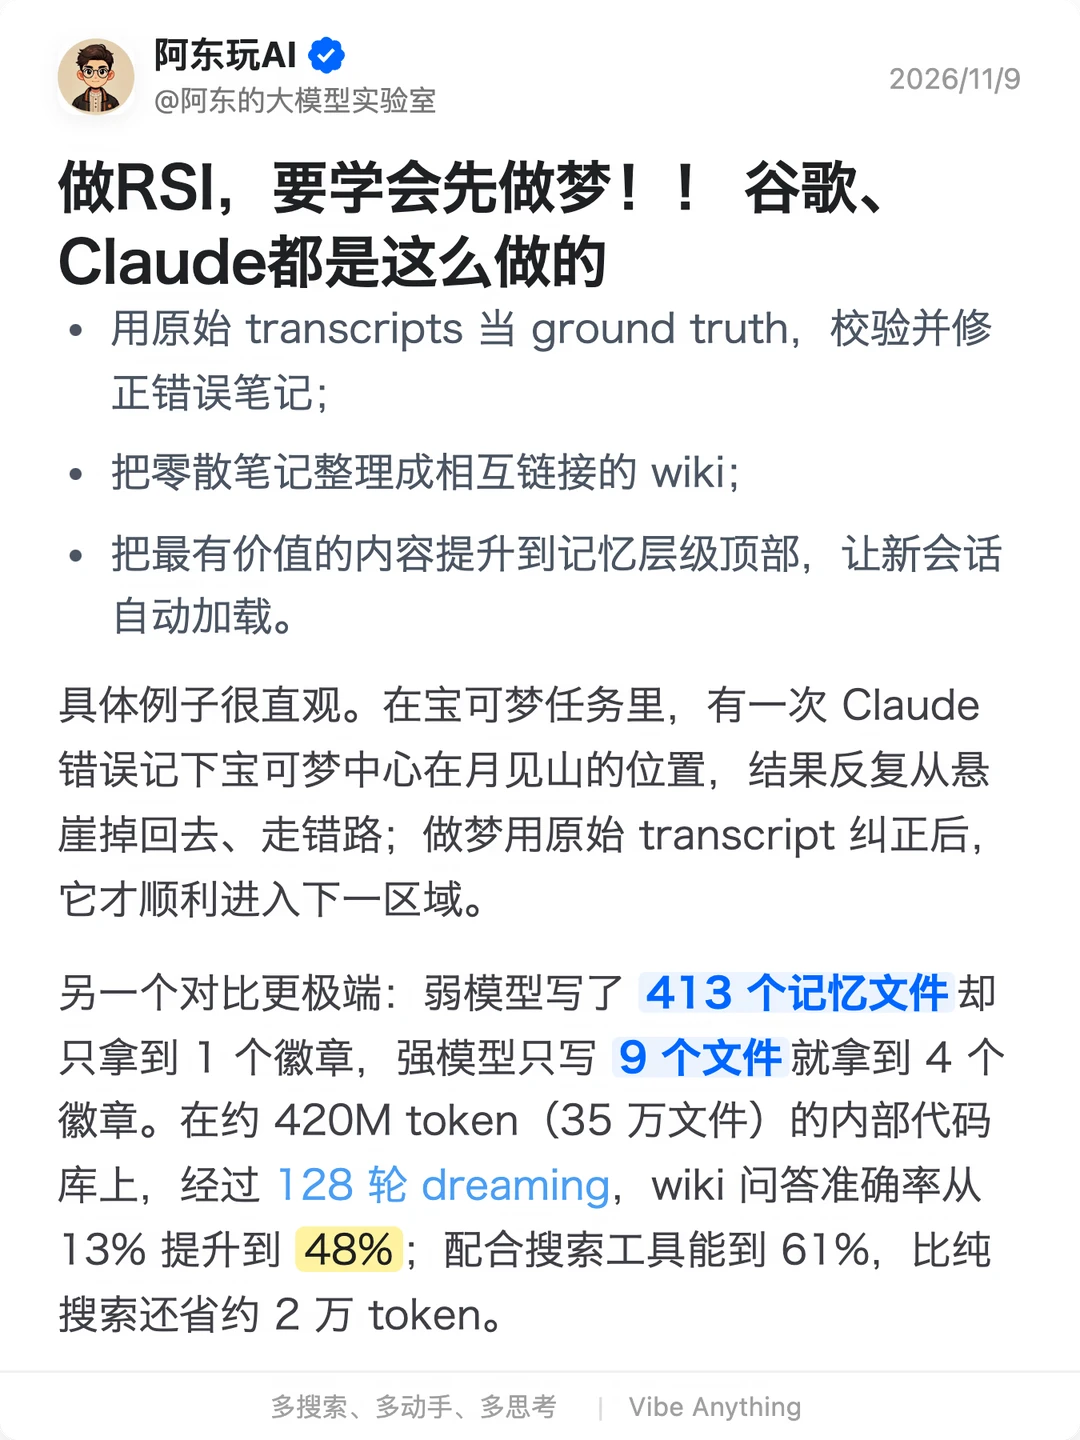
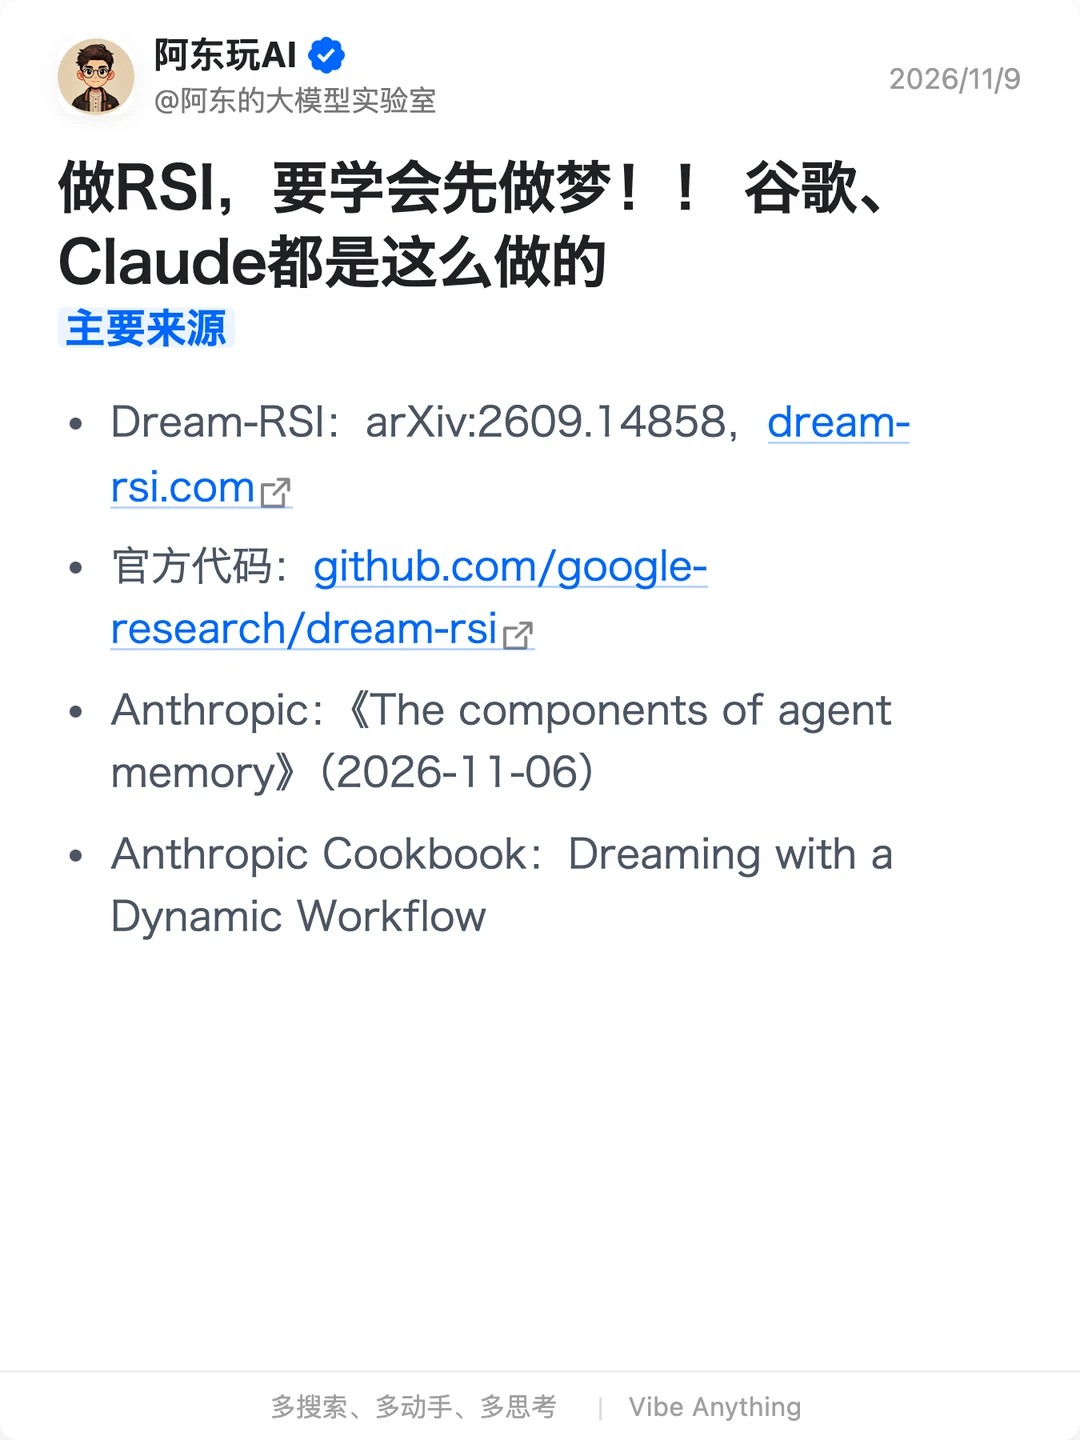
Google Dream-RSI 在任务上少用了 162 倍 agent 调用;Anthropic 让 Claude 用同样方式整理记忆,wiki 问答准确率从 13% 升到 48%。
先把历史轨迹记完整,才有做梦的本钱。
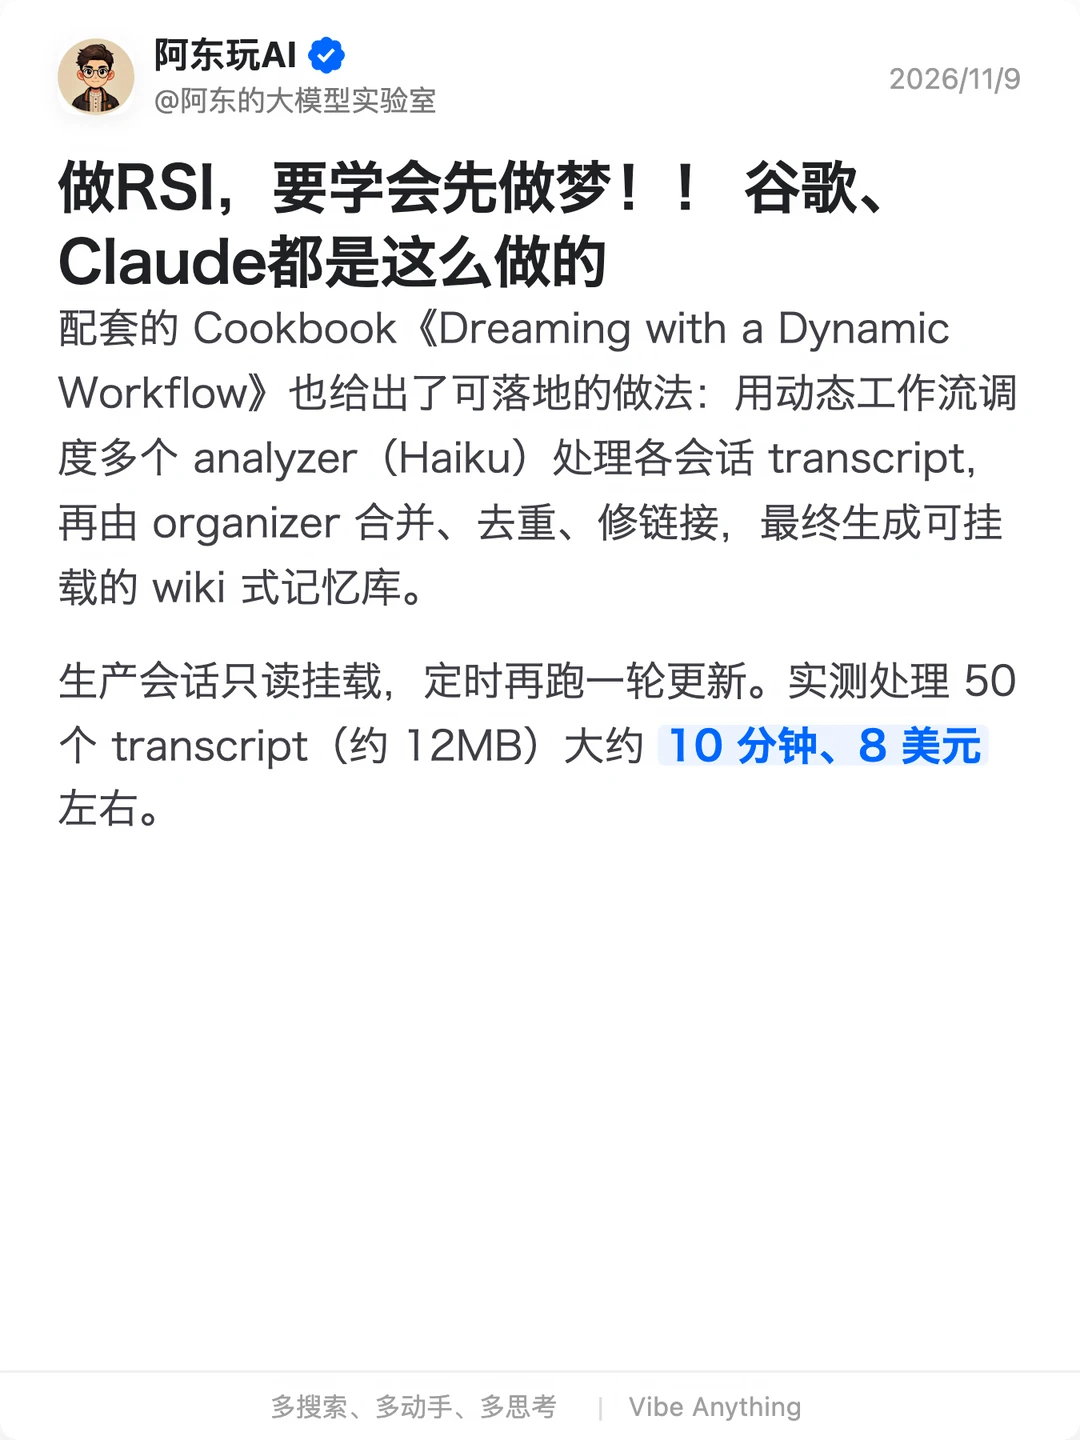
对做 Agent 系统的人,这是个很实用的提示:改进面不在底座模型,在编排策略和记忆结构这些可解释层。不用等模型自己改权重,先把走过的路变成可以反复进入的模拟器。
阿东,大模型算法工程师,OPC创业者。
#agent #rsi #大模型 #AI搞学习howto #howto用AI抢救一切 #算法