今天看到一组数据,做AI的朋友估计有点感受。
11月2日到8日这一周,全球开发者在OpenRouter上调用大模型一共用掉210万亿Token,比上周涨8.25%。其中中国模型116.18万亿,涨16.71%;美国模型13.98万亿,跌32.4%。中国模型周调用量连续第28周超过美国。
前五名里四款是中国的。DeepSeek V4.1 Flash 1017连续三周第一,56万亿;DeepSeek V4.1 Flash第二,17.6万亿;智谱GLM 5.3 Flash第三,13.2万亿;腾讯混元Hy4 11月4日刚发布,第五天就冲到第四,12.8万亿。
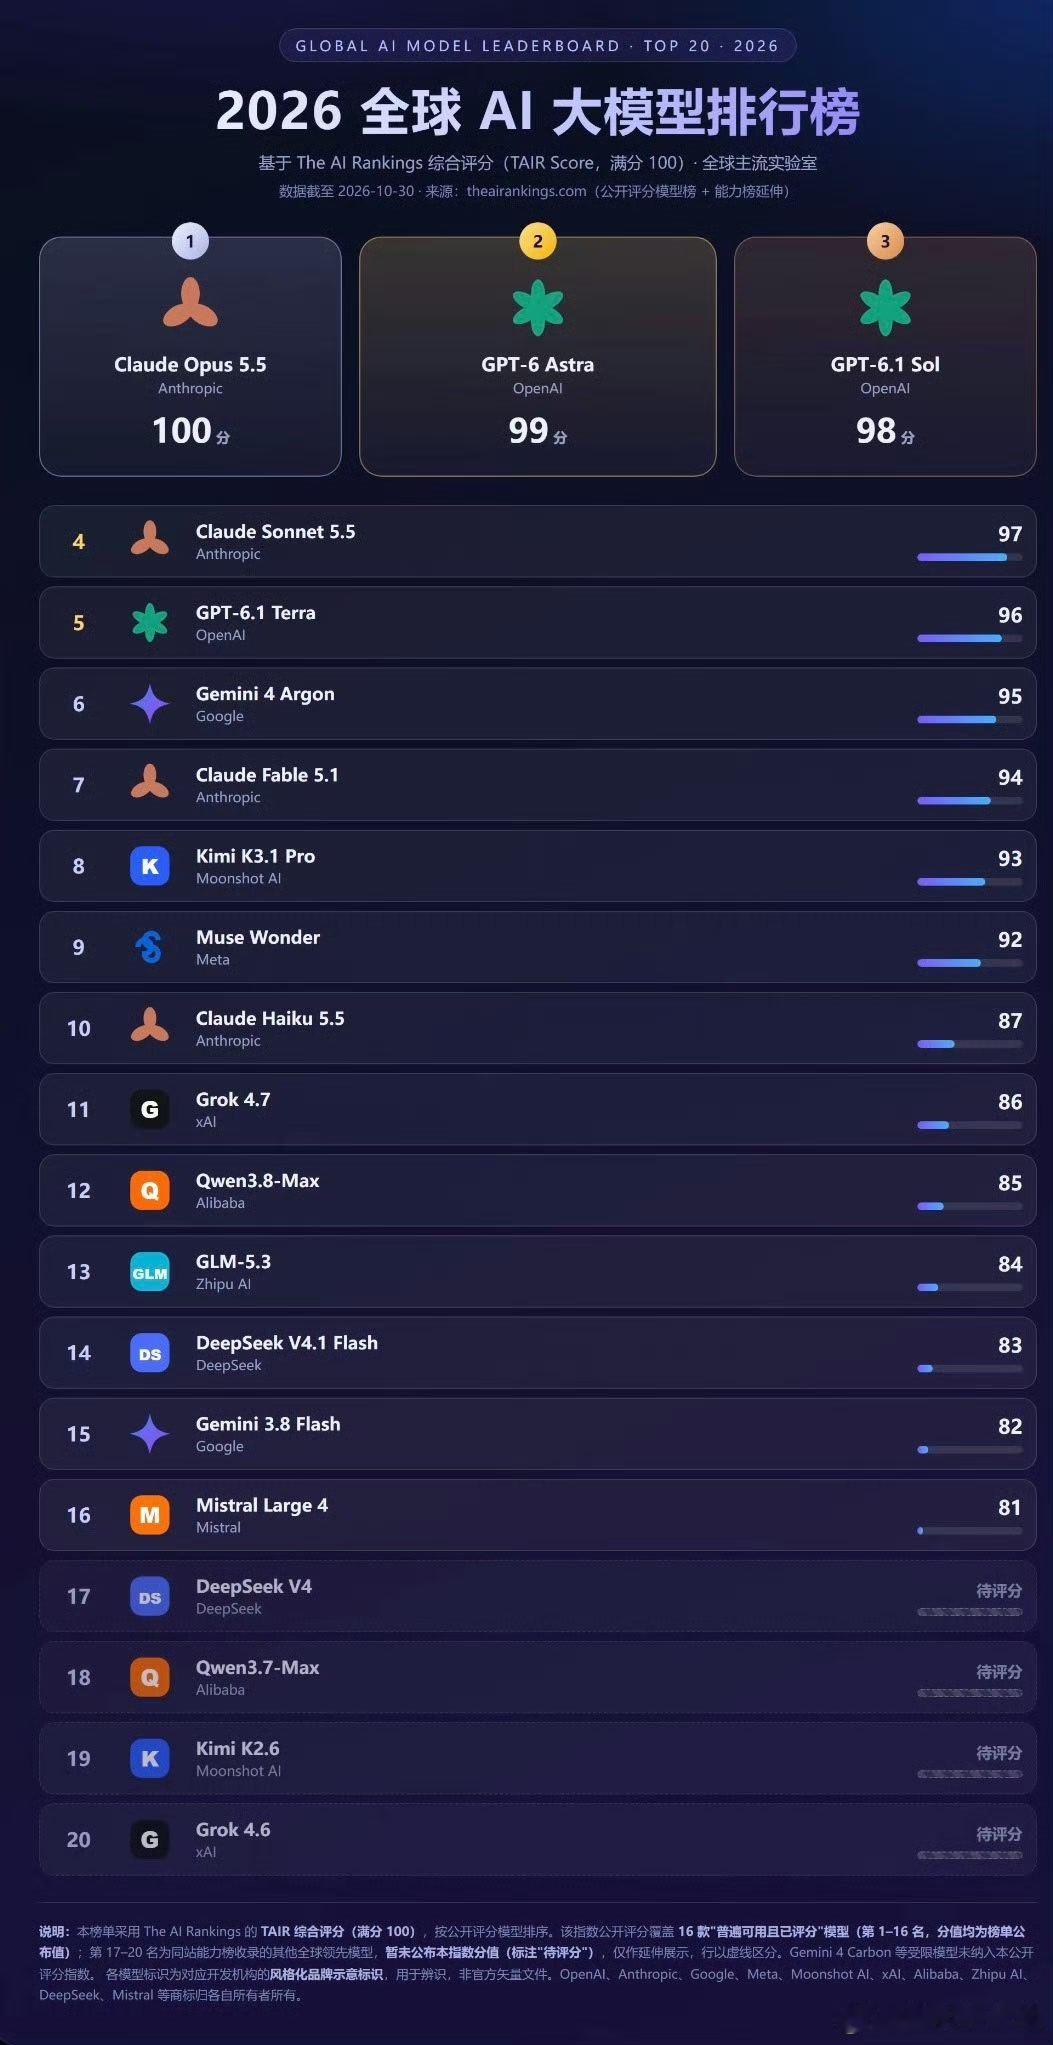
但我想说的不是DeepSeek,是月之暗面的Kimi K3.1 Pro。它排第九,4.37万亿,环比涨91%。这模型10月24日才发布,3万亿级参数、100万Token上下文,是全球参数规模最大的开源模型。
还有个数据更值得琢磨。11月3日硅谷门罗风投发的报告说,美国企业花在开源大模型上的钱,89%付给了中国模型。其中Kimi拿走61%,DeepSeek 15%,智谱11%,通义3%,Meta的Llama只有7%。
花钱和调用是两条线:支出往Kimi集中,调用量往DeepSeek集中。同一批美国公司,一边给Kimi付钱,一边用DeepSeek写代码。
我真正关注的是另一件事——Kimi在招什么人。
翻了下他们的岗位,除了推理优化、K8s调度、评估系统这些常规技术岗,冒出来一批很有意思的:法律行业解决方案专家、金融领域Agent评审专家、AI战略经营专家、内容安全负责人。
注意这几个岗的共同点:要的不是会调模型的人,是懂诉讼流程的人、懂研报怎么估值的人。
这说明模型公司正在从"我模型多强"往"我能替你把哪个具体活干了"转。而要干这个活,光有算法不够,得有人知道那行里的坑在哪。
对做招聘的来说,这是个口子。以前AI公司的岗位清单很窄,基本就算法、工程、产品三档。现在开始出现"行业Know-how+AI"的混合岗,而这种人市场上几乎没有现成的——只能从律所、券商、会计师事务所里挖,然后补上AI那半块。
这个方向,比追着算法工程师跑现实得多。