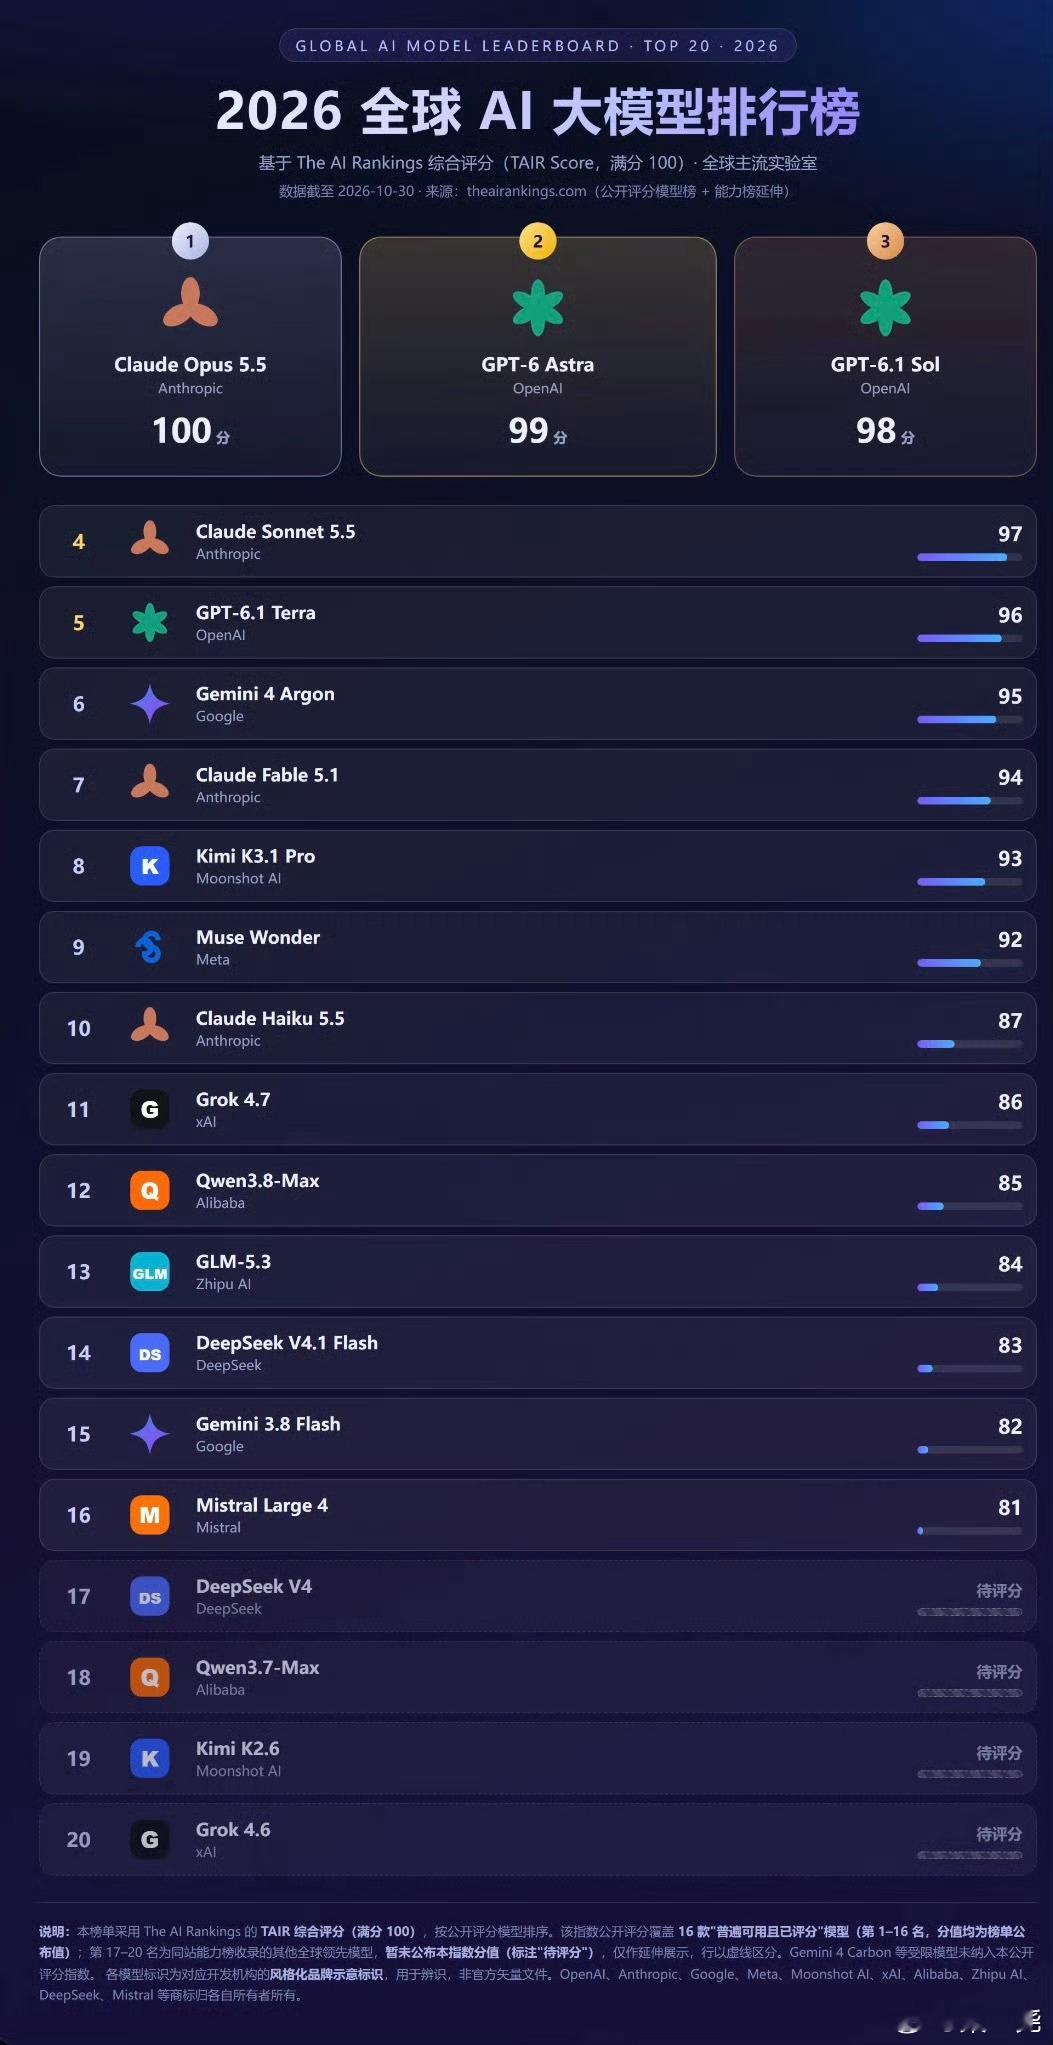
AI模型第一梯队该有谁第一梯队不是固定名单,而是“场景适配带”!第一,看组合,不看单科。 推理、编程、智能体三项里,至少两项能进前五,第三项不拖后腿,才有资格上桌;只有一项突出、另外两项平庸的,是特长生,不是第一梯队。Claude Opus 5在SWE-bench Verified上96%—97%,编程和智能体是硬通货;GPT-5.4 Pro在ARC-AGI-2上83.3%领先,强在抽象推理;Gemini-4-Argon在SuperCLUE总分73.62排第一,超长上下文95.63,底子厚不偏科。国内Kimi K3.1-Pro以61.46拿下国内第一、开源第一,但强项是幻觉控制和超长上下文,智能体编程分项开放第一其实是DeepSeek V4.1 Flash的65.38,别拿一个分项吹成全能。第二,看场景兑现,不看总榜名次。 同一个模型,工程执行稳,游戏开发可能翻车,生活决策甚至不如某些国产模型。写代码、跑智能体,Claude和Kimi值得优先摸;长文档、要均衡,Gemini底子最厚;数学推理和企业工作流,GPT那套集成不是白做的。与其争谁坐第一把椅子,不如先看椅子是什么形状。第三,成本和稳定性也得算进标准。 DeepSeek V4 Pro成本确实低,同一套基准约268美元,Claude Opus 4.7约是其19倍;但编程SWE-bench在77.6%—79.4%,和Opus 5的96%—97%还有近20个百分点差距。它是“低成本第一梯队选手”,但别说成“紧随Opus 5”。第四,榜单看上限,体感看兑现,别把任何一个当判决书。 LMArena这类盲测也有偏差,有研究就发现不少获胜回答事实是错的。所以按这个标准,海外Claude、GPT、Gemini有资格上桌;国内Kimi、DeepSeek、GLM、Hy4也在各自场景挤进讨论圈。