刚刷到一条新闻,说是联想开天推出了首款信创 AI 主机,只有1.6L盒子大小,在桌上就能让 122B 能力的大模型在本地运行。
那今天就单纯从技术角度,结合官方发布的信息,好好和大家聊一聊这台AI主机:
第一,小盒子跑大模型,物理上完全成立。
很多人觉得千亿参数的模型必须机房才跑得动,其实是把"训练"和"推理"搞混了。
训练需要千百张卡,是因为要从海量数据里学出参数;而推理只是拿训练好的参数做矩阵乘法,算力需求差了好几个数量级。
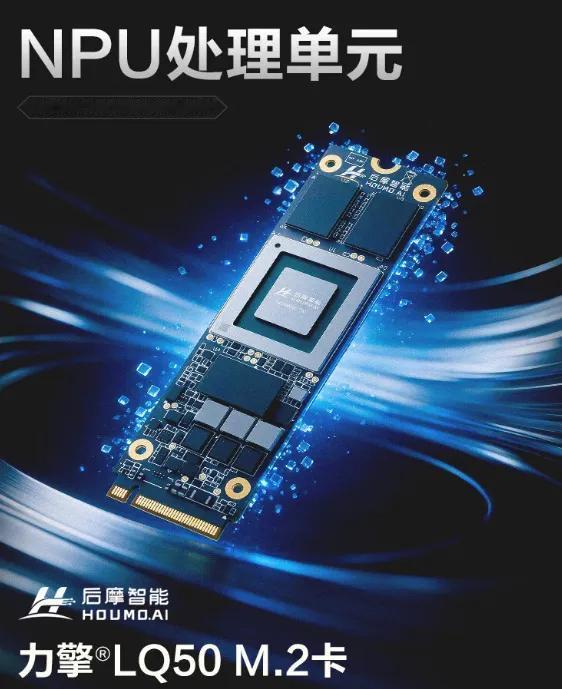
跑推理,一颗专用 NPU 就够了。这台机器用兆芯 CPU 加后摩智能 NPU 的异构架构,CPU 管调度,NPU 管算力,各司其职,分工明确,这是业界验证过的成熟路线。
第二,能塞进 1.6L,靠的是"聪明地算"。国产算力装进小盒子了
这里有个关键设计:它支持的千亿模型是 MoE 架构。
MoE,混合专家模型,参数总量很大,但每个任务只激活一小部分参数。
相当于一个医院有上千名医生,来了病人只叫相关科室的几位出诊,效率高得多。
配合 INT8 等量化压缩技术,用合理的精度换取显存占用的大幅下降,大模型才能舒舒服服住进小机身。这恰恰是当前 AI 芯片和模型协同优化的主流方向。
第三,峰值算力之外,工程功夫都在细节里。
320 TOPS 是峰值算力,但一台机器好不好用,考验的是持续输出的能力。
本地推理最常见的两个瓶颈是内存带宽和散热,这台机器用双风道把 CPU 和 NPU 的热路分开,各自稳定运行,保证了 7×24 小时开机干活也不降速。
对一个要当"数字员工"的设备来说,稳定比峰值更重要,这一点它想得很明白。
第四,20 万 Token 长上下文,是实打实的硬功夫。
上下文越长,KV Cache 占的显存越多,这对小机身是很大的挑战。能支持 20 万 Token,意味着几十万字的合同、标书可以一次读进去,背后是模型压缩和显存调度的真功夫。
对经常处理长文档的财务、法务朋友来说,这个能力的实用价值很高。
那么,最后再总结一下,这台AI主机把"本地跑大模型"这件事做成了普通办公室就能部署的产品。
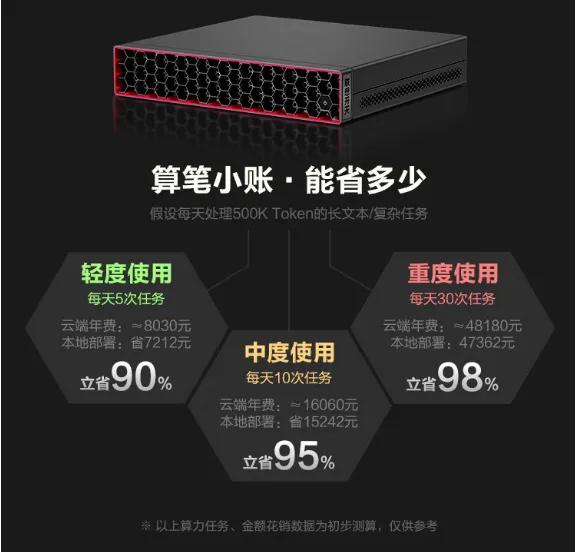
数据不出门、7×24 在岗、不按 Token 交费,对政企和有数据合规要求的场景,价值非常明确。国产 CPU、国产 NPU、国产操作系统在整机层面完成协同,这个整合能力本身就值得点赞。
说实话,现在做什么变化都太快了,技术进步也是这样的,一步步把"机房里的能力"变成"桌上的工具",这就是一个不错的起点。