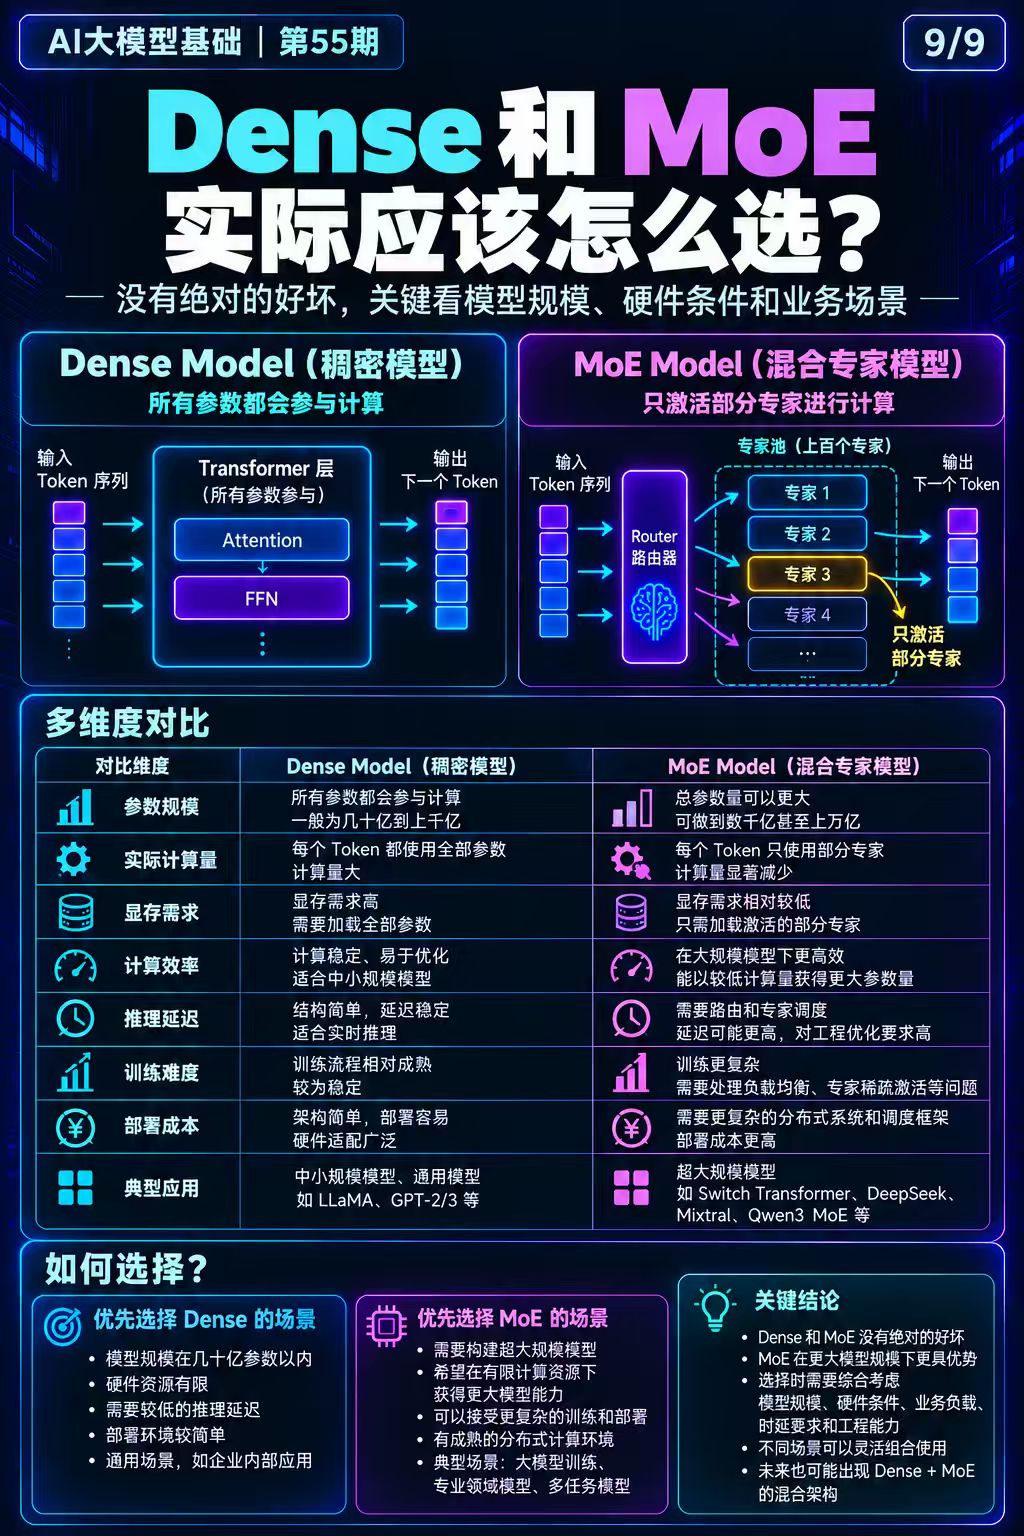
Dense 和 MoE 到底有什么区别?为什么越来越多大模型开始采用 MoE 架构?
AI大模型基础|第55期
很多人看到大模型的参数量从几十亿增长到几千亿,甚至上万亿,就会认为参数越多,每次推理需要的计算量一定越大。
其实,关键要看模型采用什么架构。
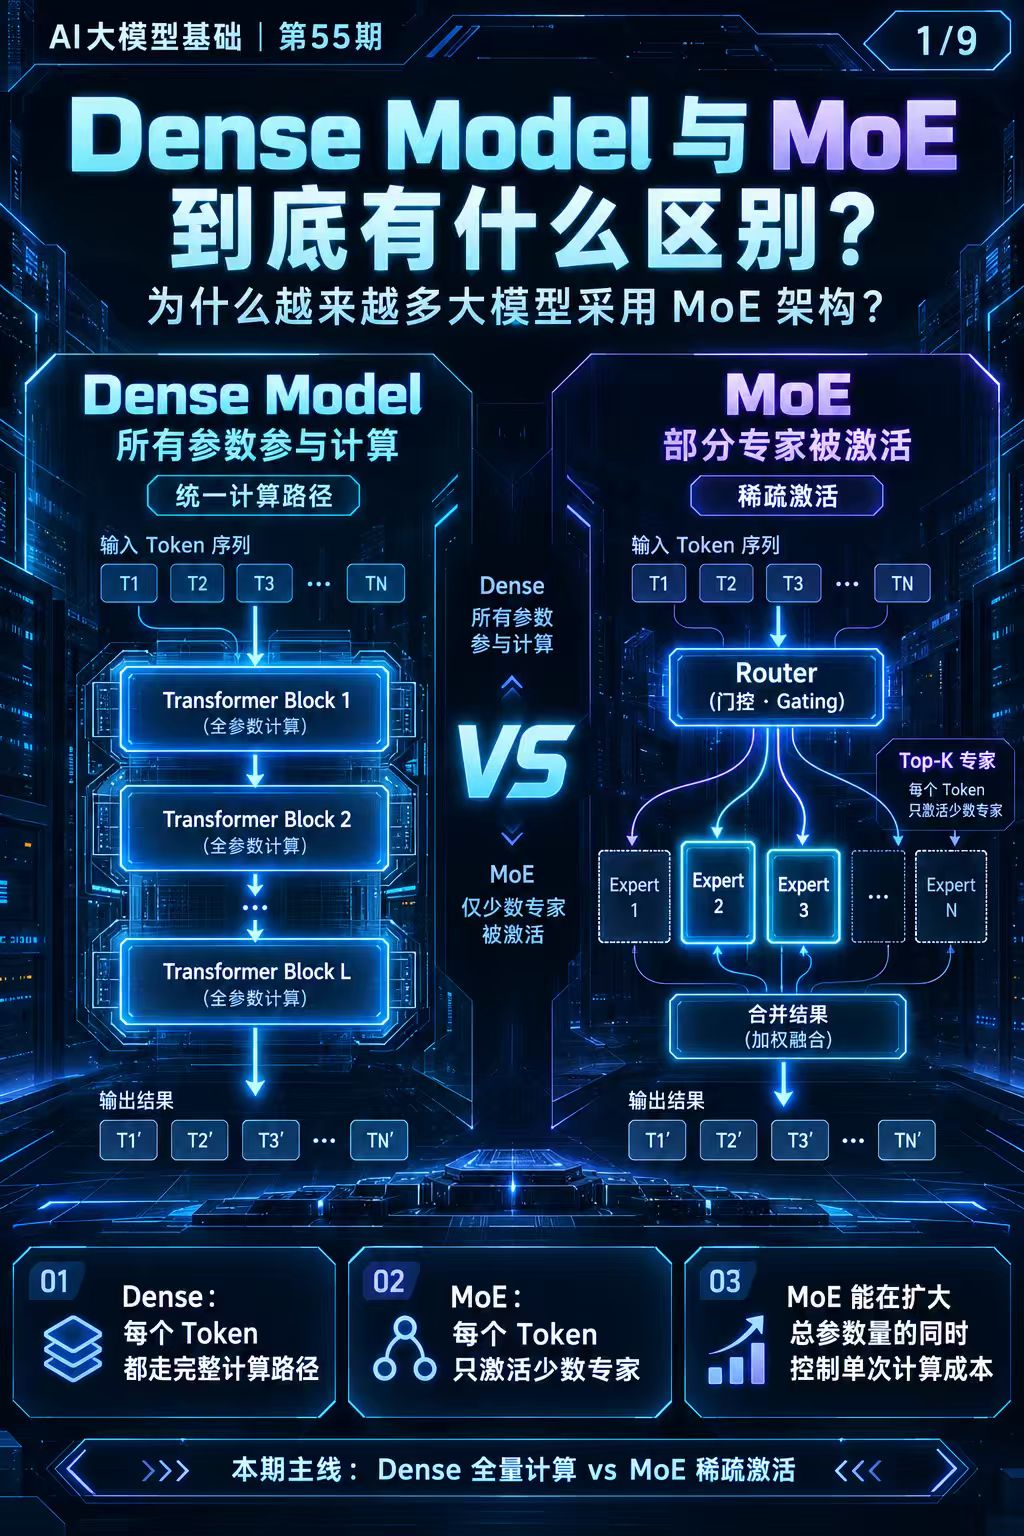
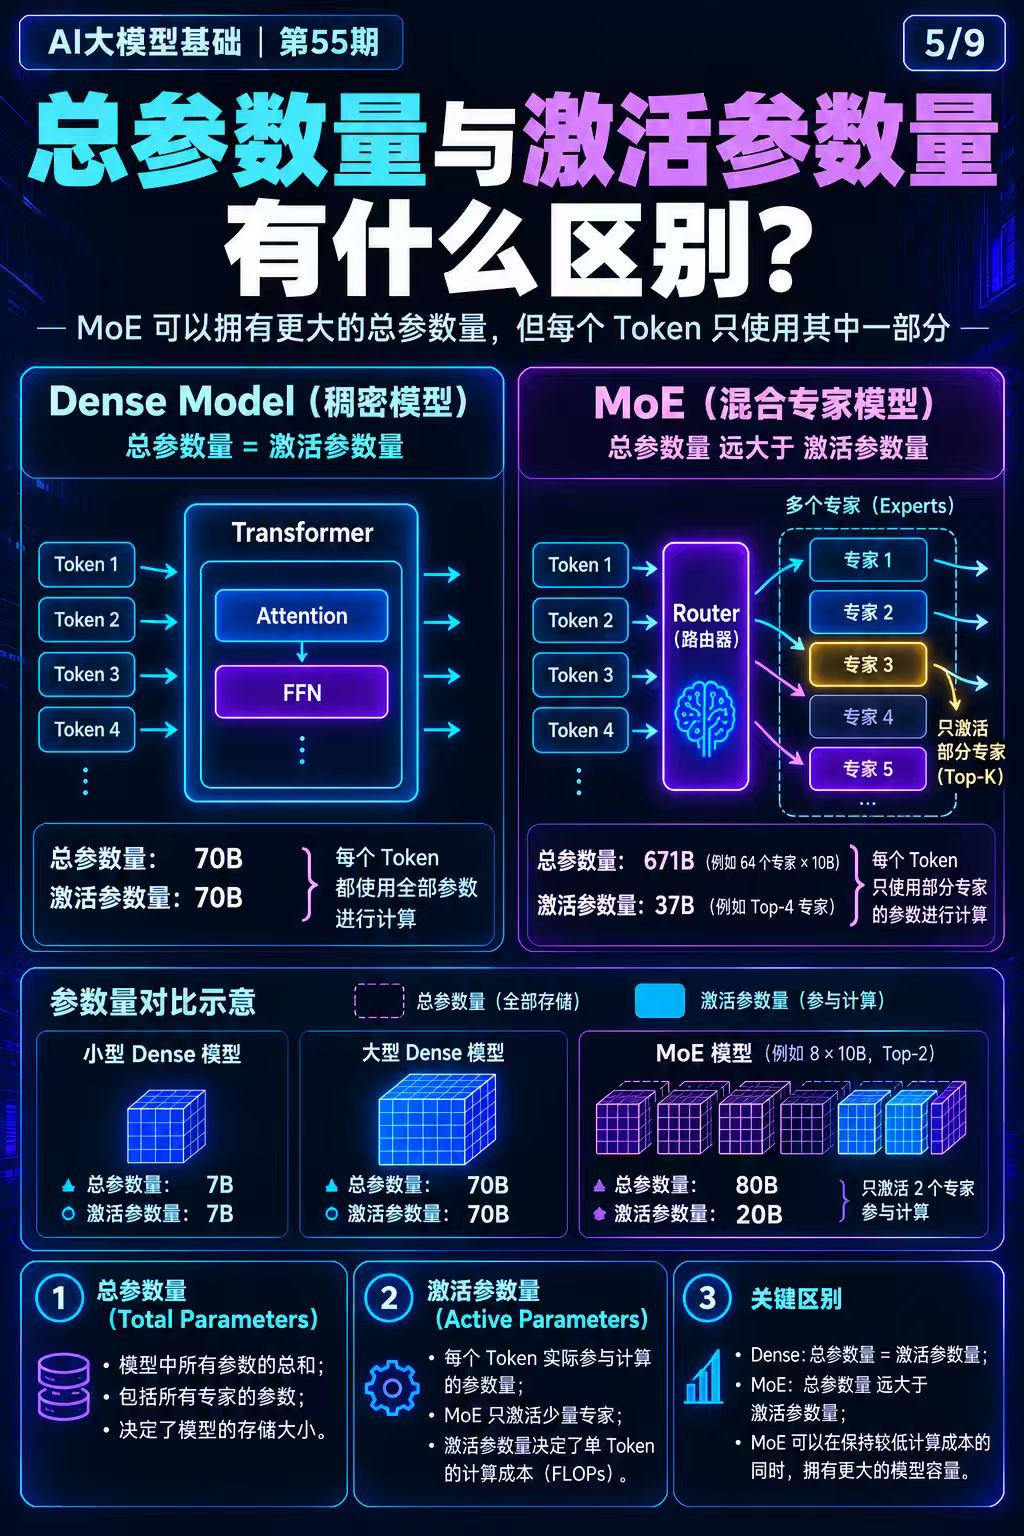
传统 Dense Model(稠密模型)采用稠密计算方式。对于每个输入 Token,模型都会使用同一组网络参数完成计算。随着模型规模增加,计算和显存开销通常也会增长。
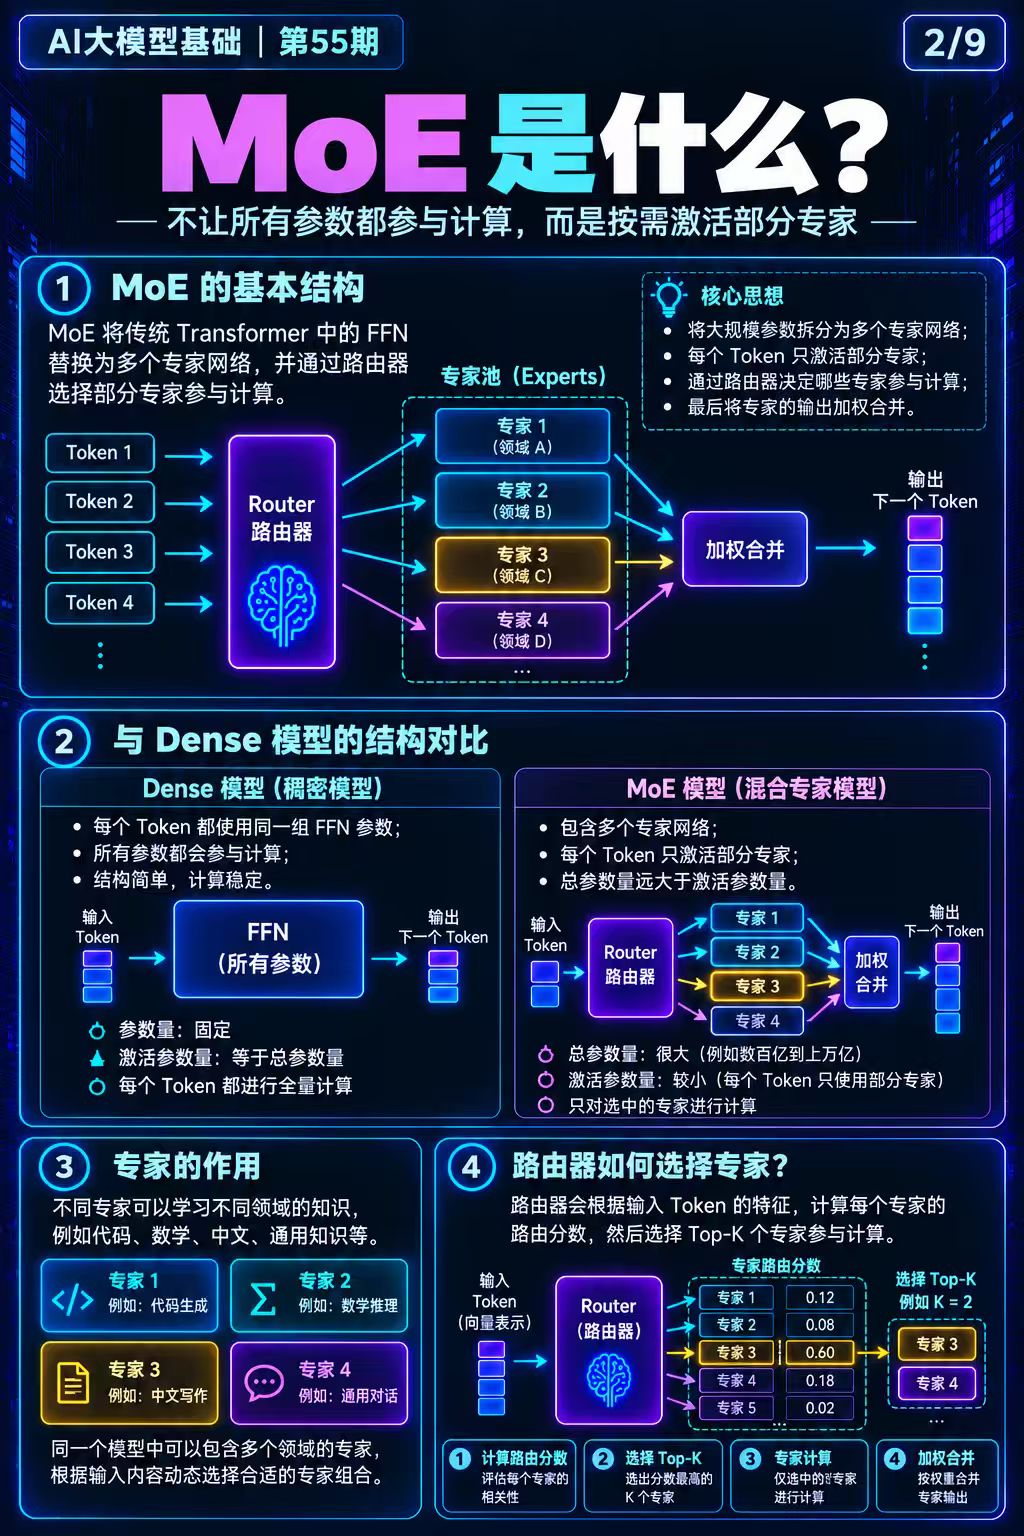
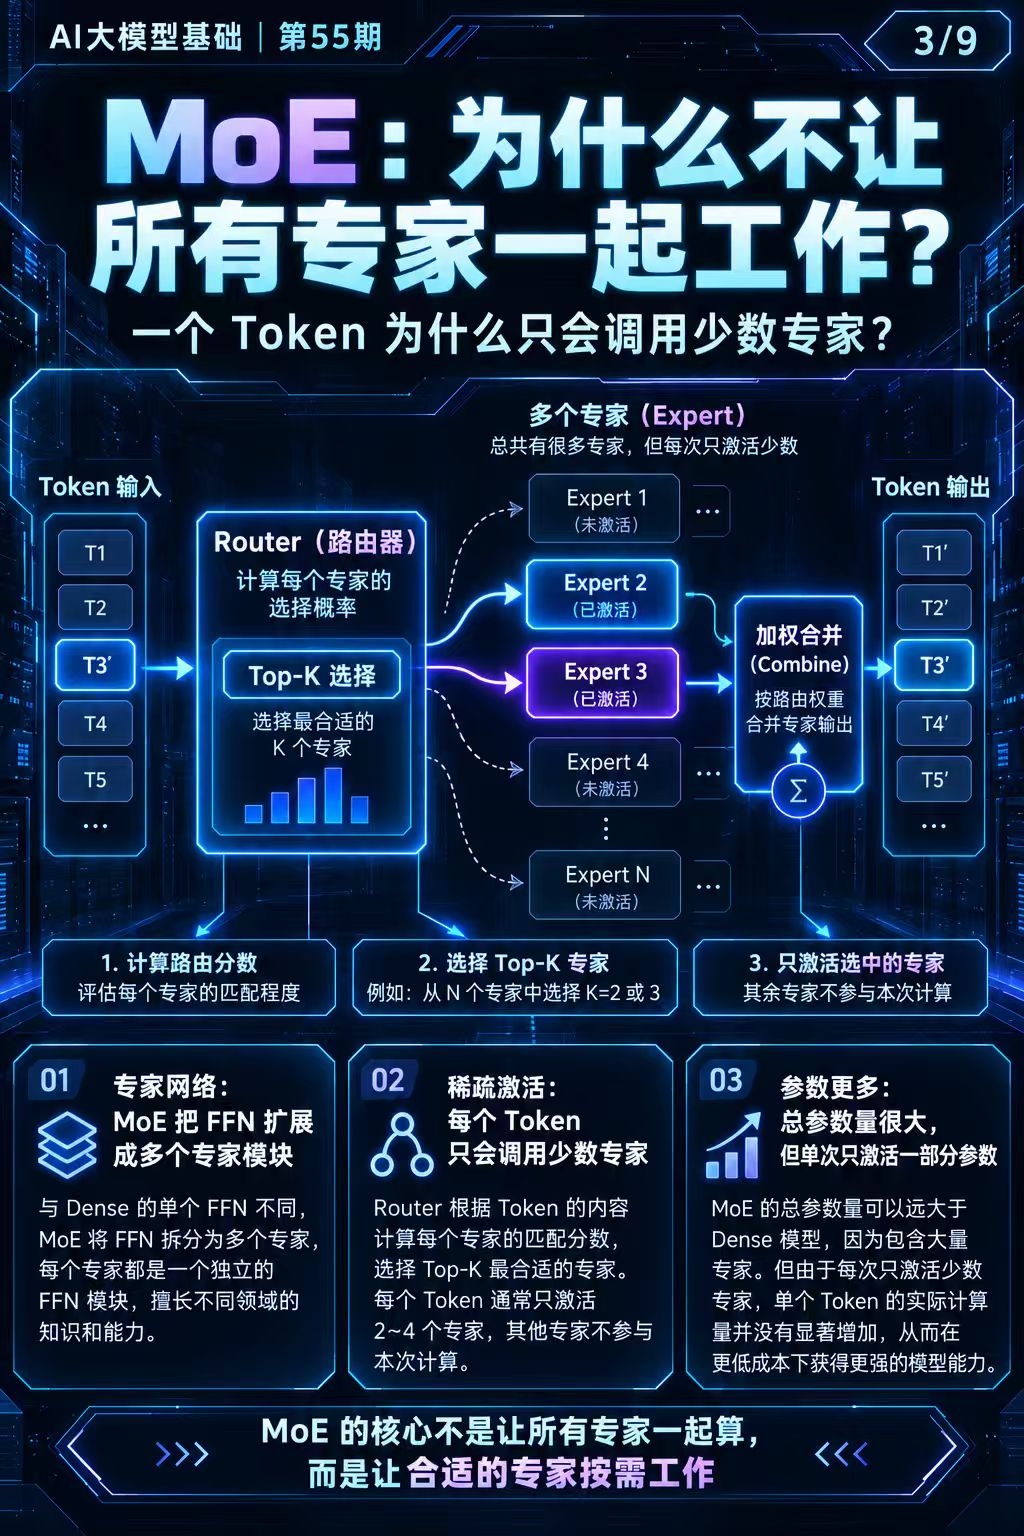
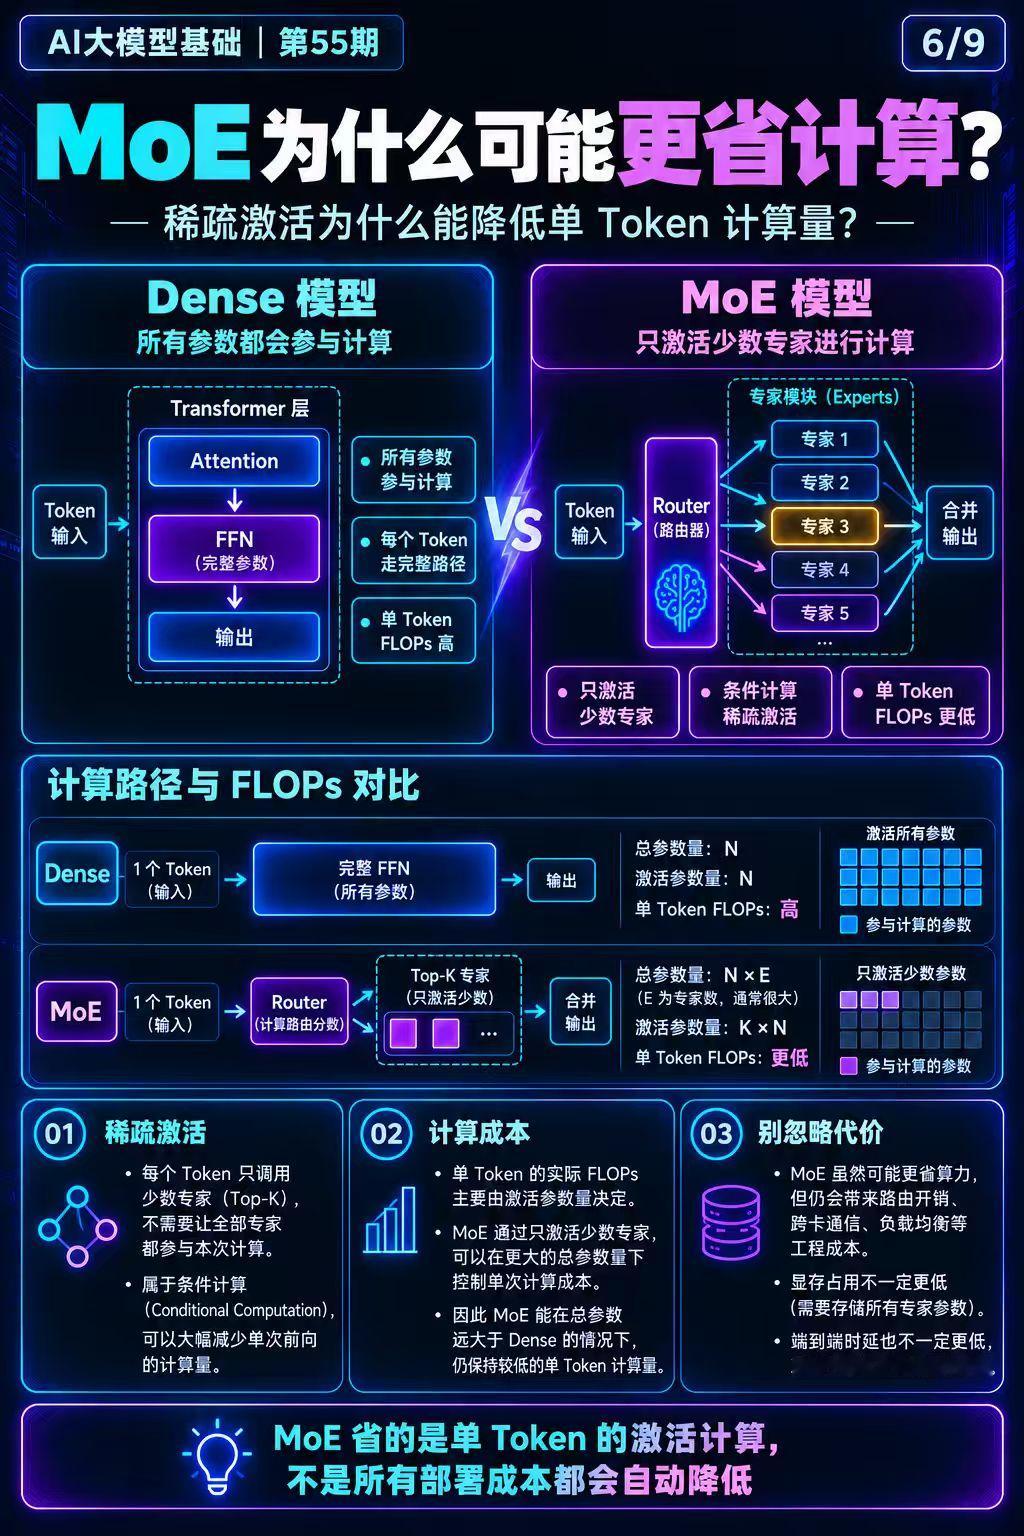
MoE(Mixture of Experts,混合专家模型)采用了另一种思路:不让所有专家同时参与计算,而是按需激活部分专家。
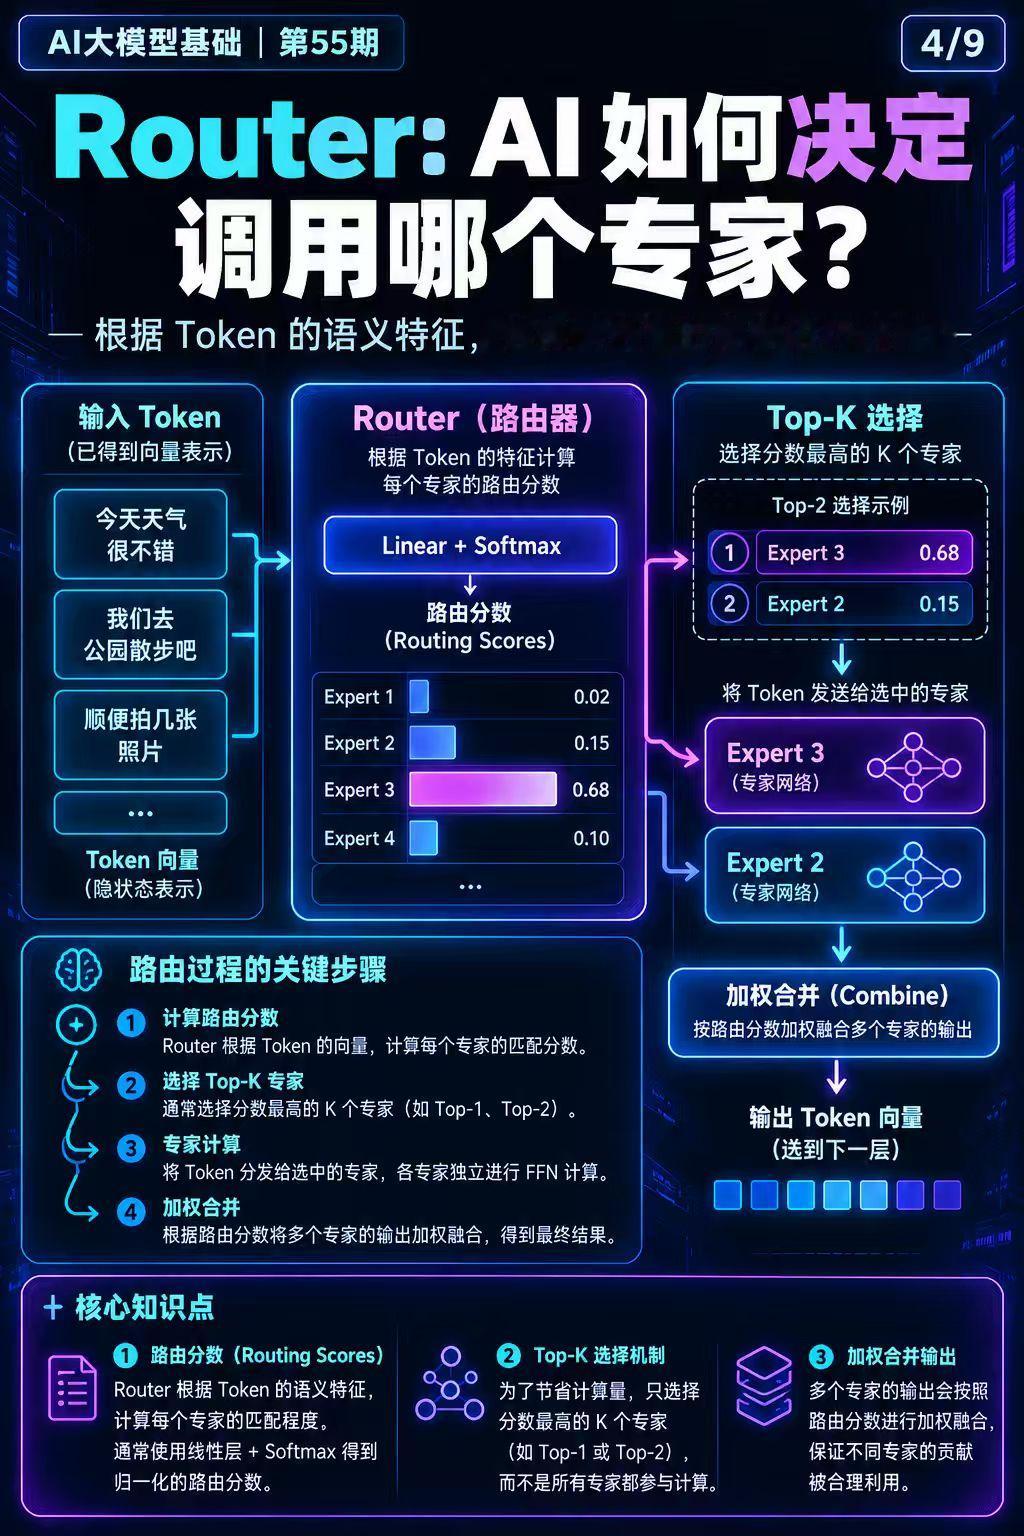
它通常将 Transformer 中的 FFN 替换为多个专家网络,并引入 Router(路由器)。
当一个 Token 进入 MoE 层时,Router 会计算各专家的路由分数,通过 Top-K 机制选择部分专家,再将专家输出加权合并。
这就带来了两个重要概念:
总参数量(Total Parameters):模型拥有的全部参数。
激活参数量(Active Parameters):处理单个 Token 时实际参与计算的参数。
例如,一个 MoE 模型可能拥有数千亿总参数,但每个 Token 只激活其中一部分。
这也是 MoE 能够扩展模型容量,同时控制单 Token 计算量的重要原因。
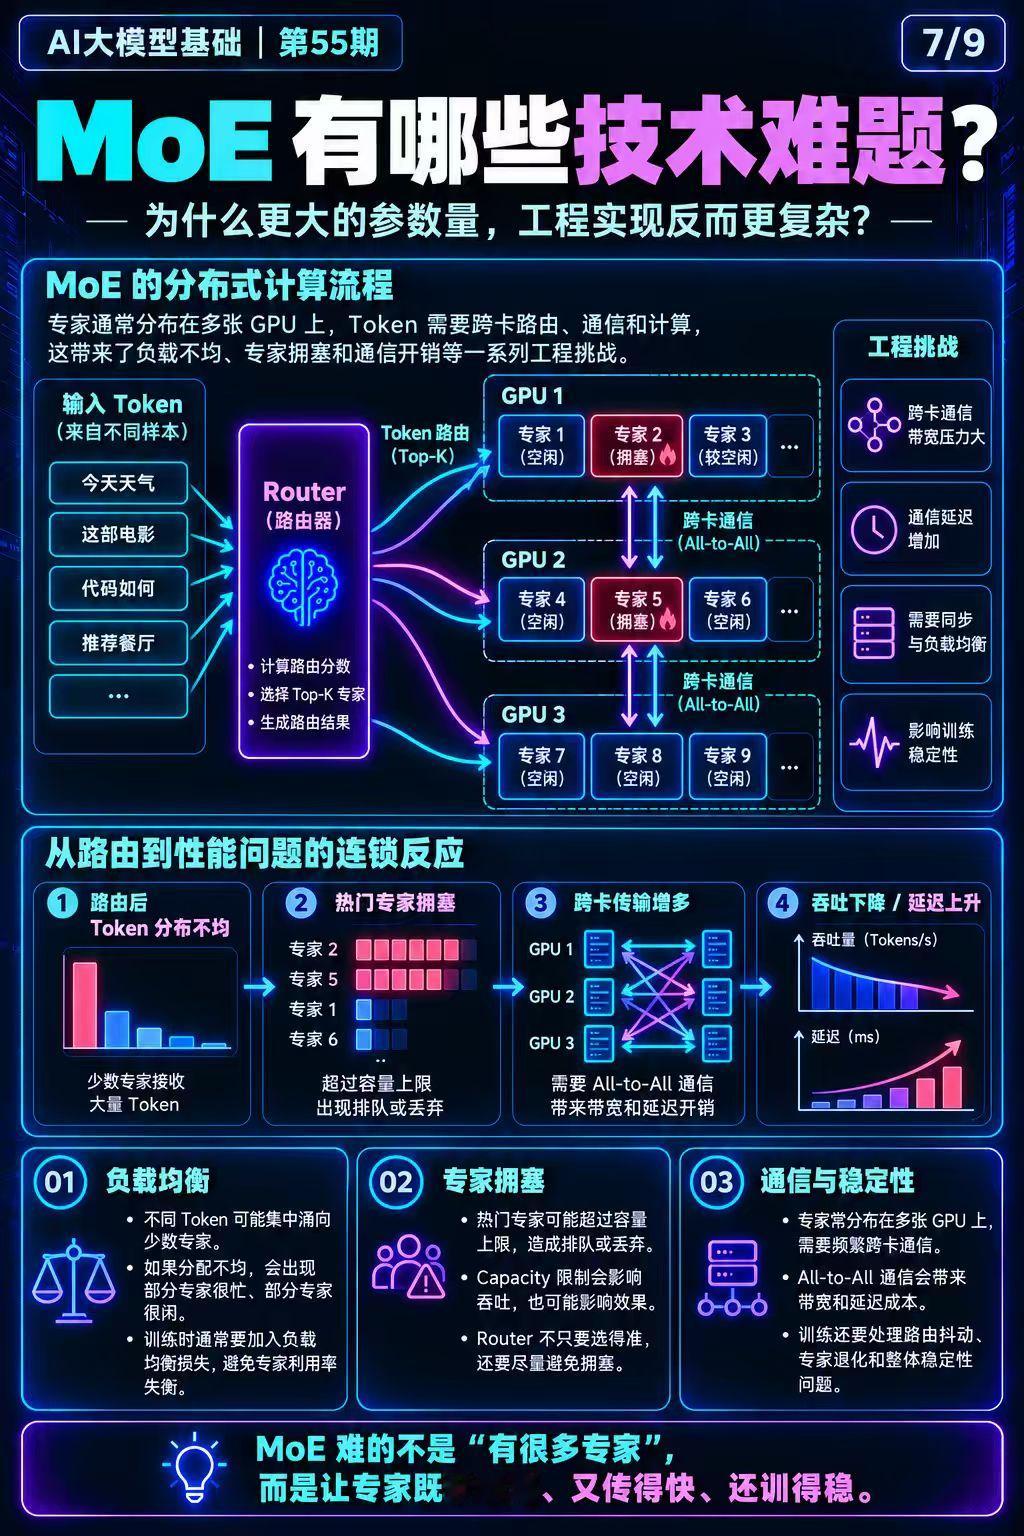
但 MoE 并不是没有代价。
专家负载不均衡、跨 GPU 通信、路由稳定性、显存占用和推理调度,都会增加工程复杂度。
尤其需要注意:计算量降低,不代表显存需求和实际推理延迟一定降低。
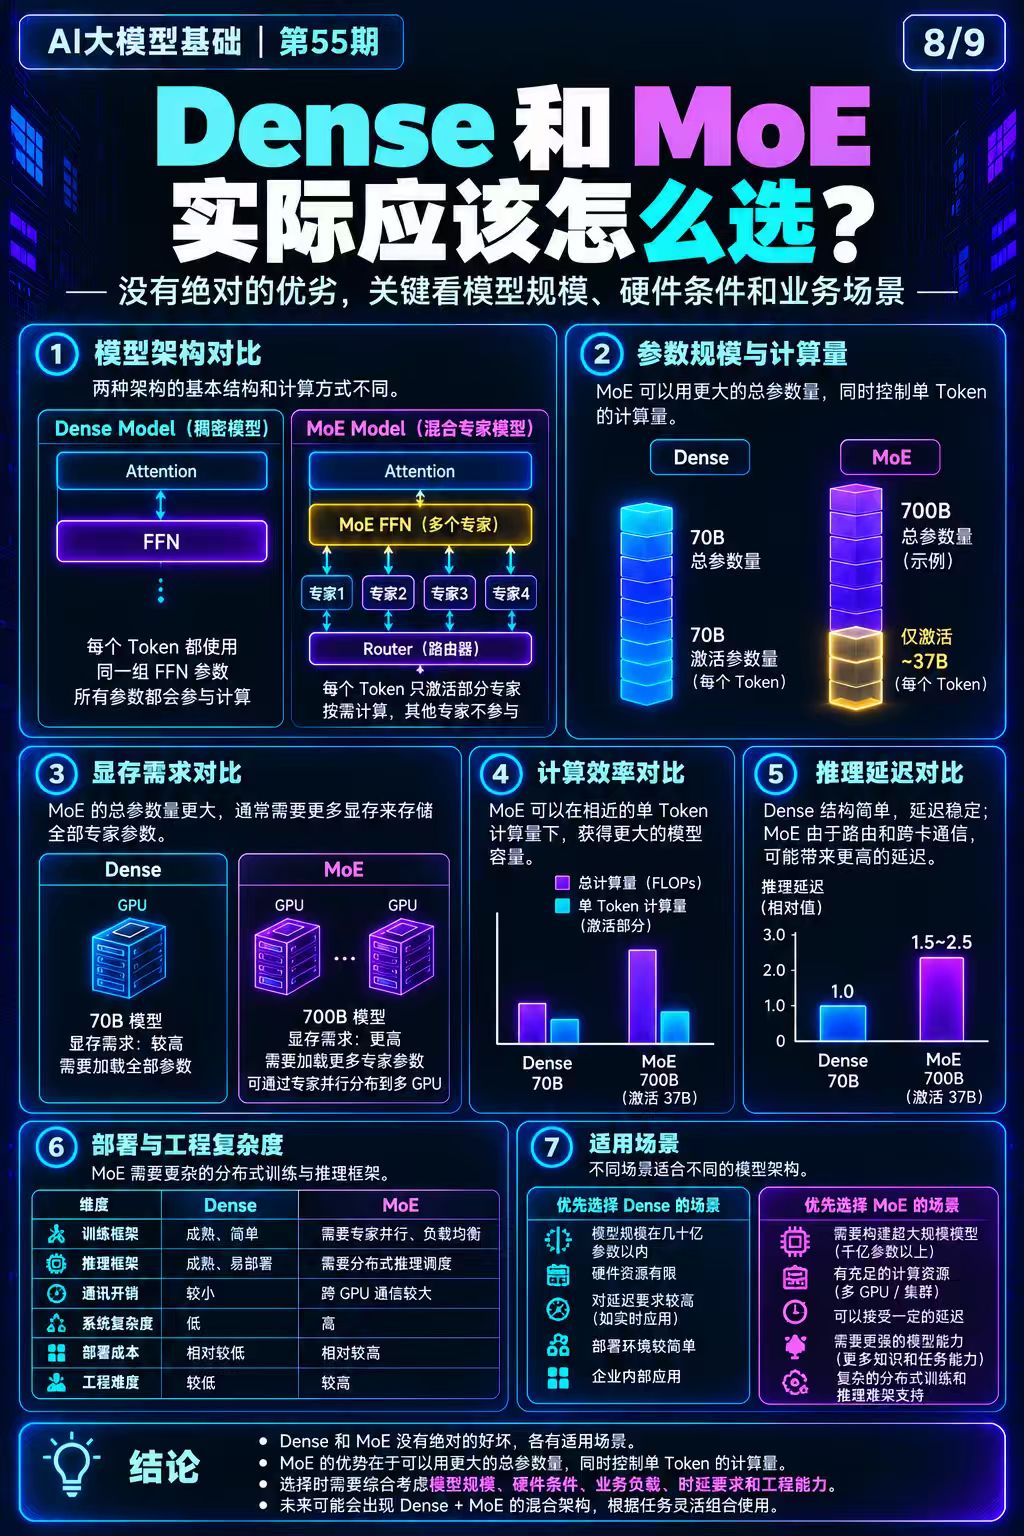
Dense 和 MoE 没有绝对的优劣。
Dense 结构相对简单,部署和优化路径更加成熟;MoE 更适合通过稀疏计算扩展模型容量,但需要更完善的分布式计算体系。
理解 MoE,本质上就是理解大模型如何从“扩大计算规模”,逐步走向“提高参数利用效率”。
下一期预告:
第56期:MoE 到底是什么?混合专家模型为什么能做到大参数、低激活?
AI大模型基础 MoE DenseModel Transformer 大模型架构