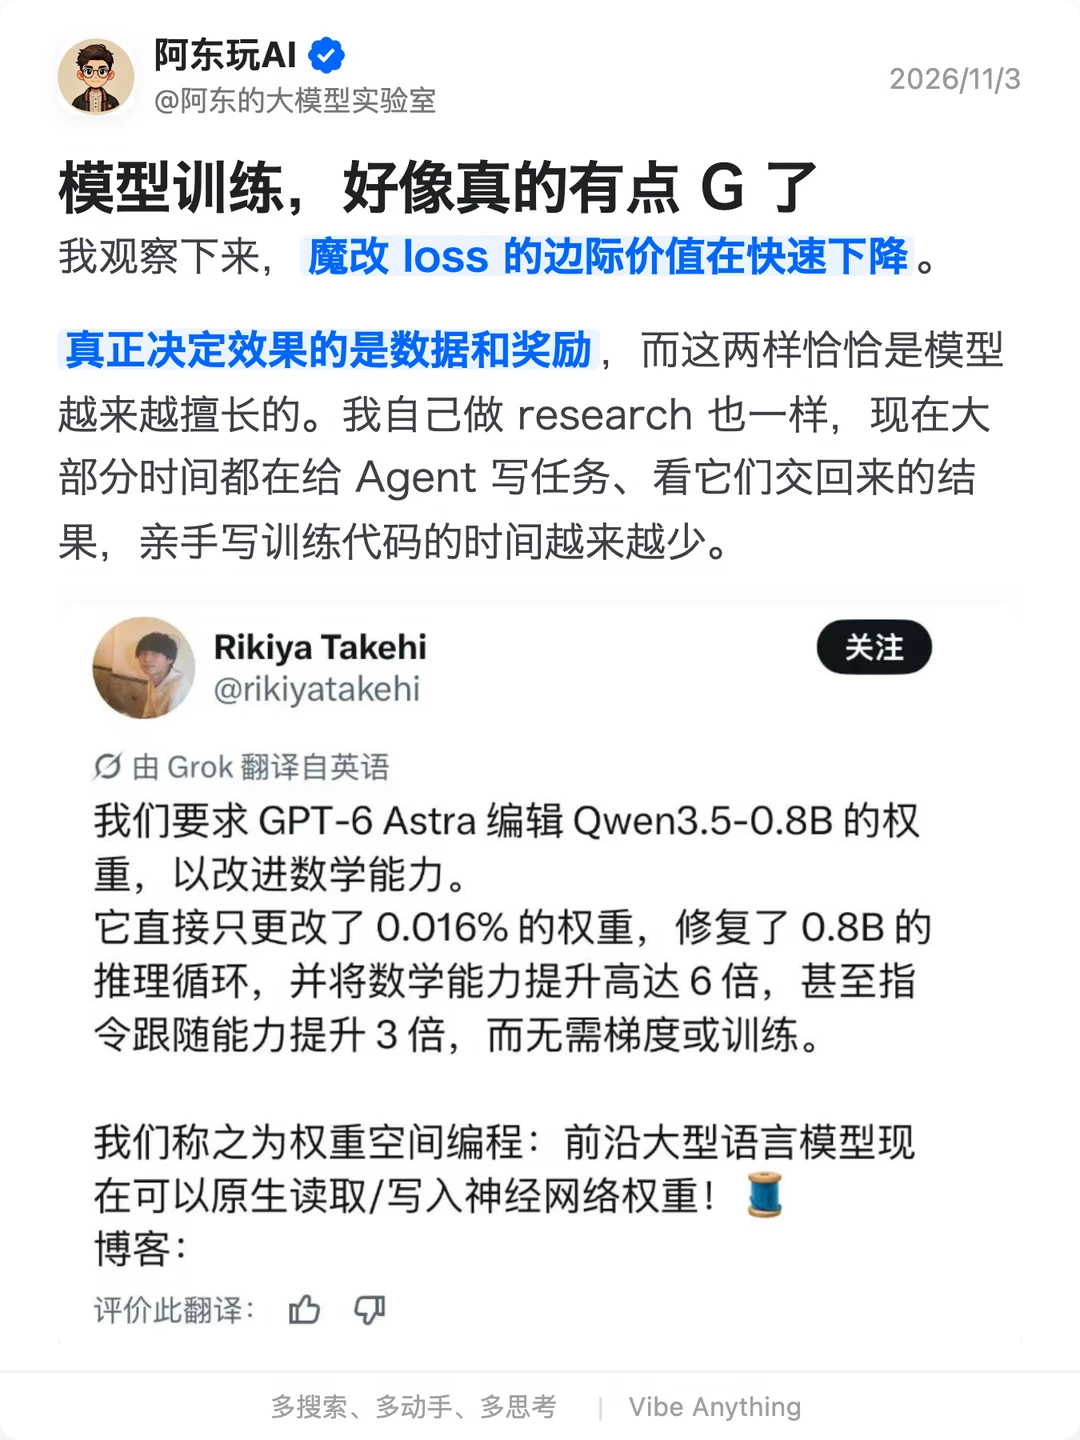
最近阿东刷到 MIT CSAIL 的一组“权重空间编程”实验,越看越觉得,训练正在从人的活变成模型的活。
[一R]后训练交给 RSI:模型自己造数据、自己评审、自己迭代,人只负责定目标、看结果
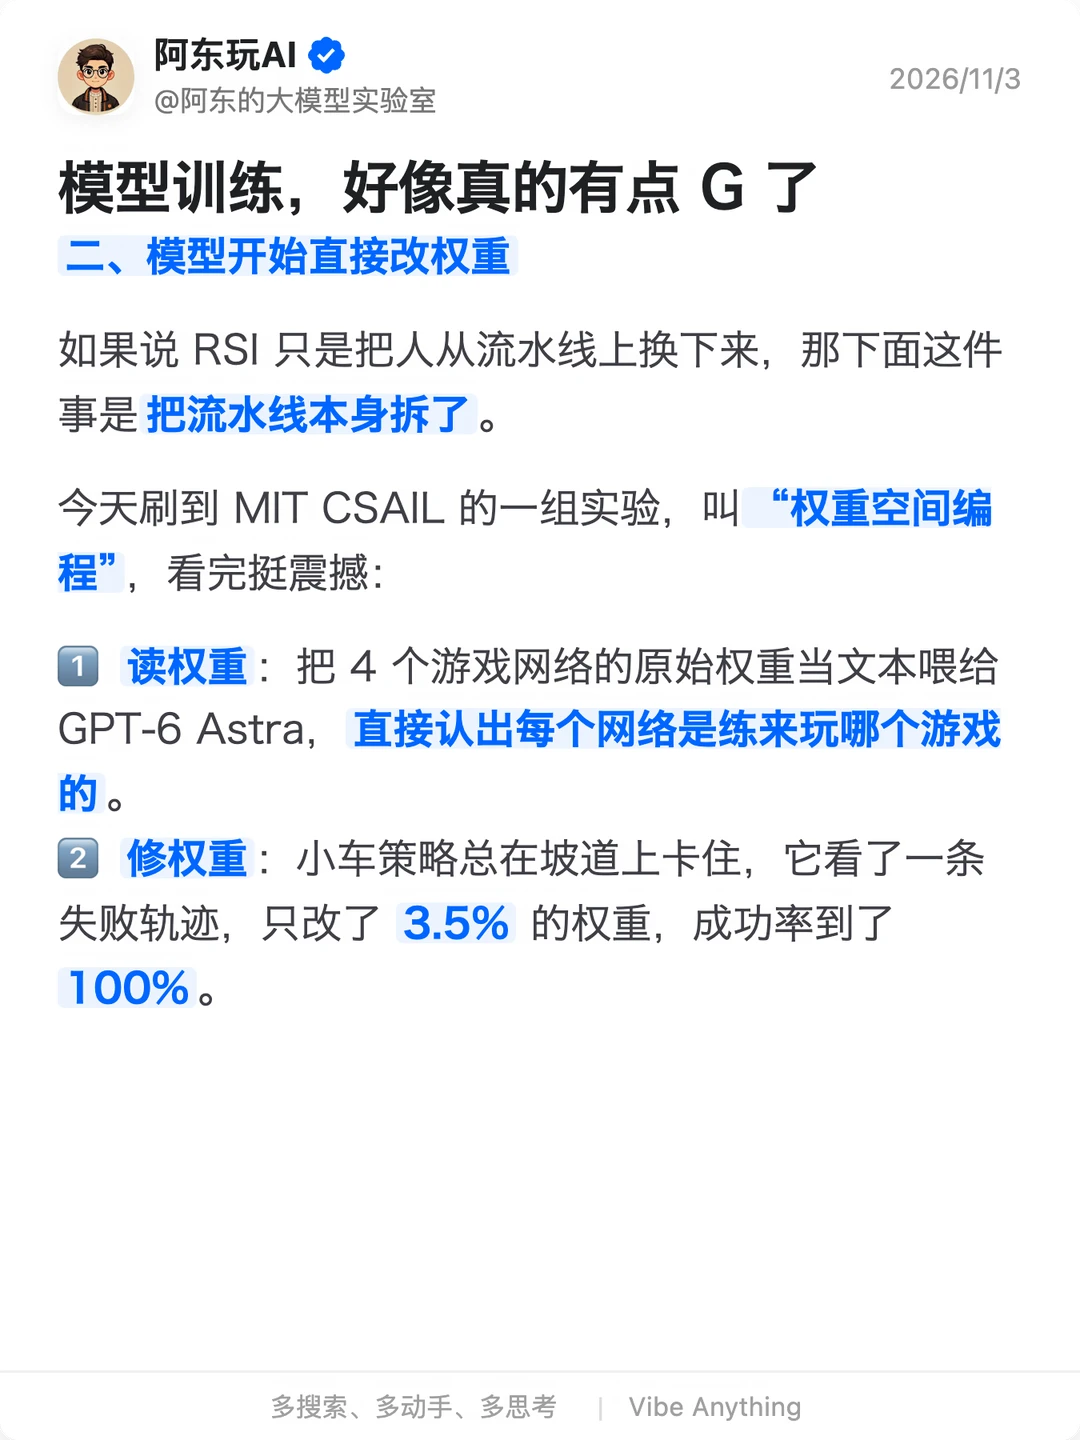
[二R]模型能读权重:GPT-6 Astra 只看原始权重,就能认出这个网络是练来玩哪个游戏的
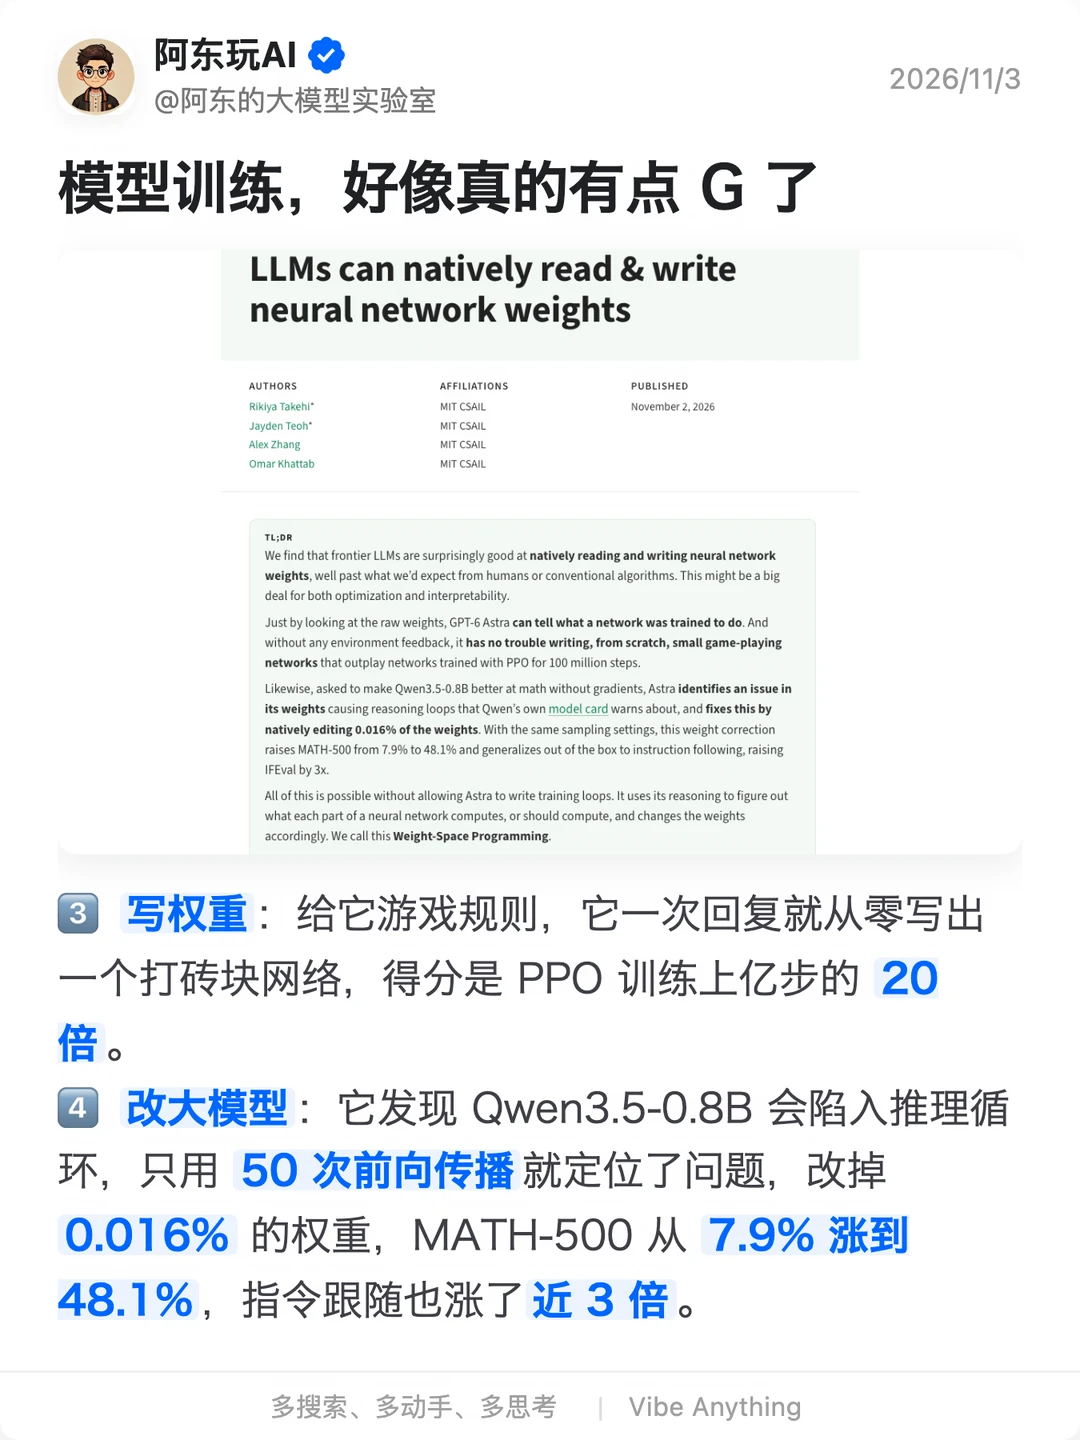
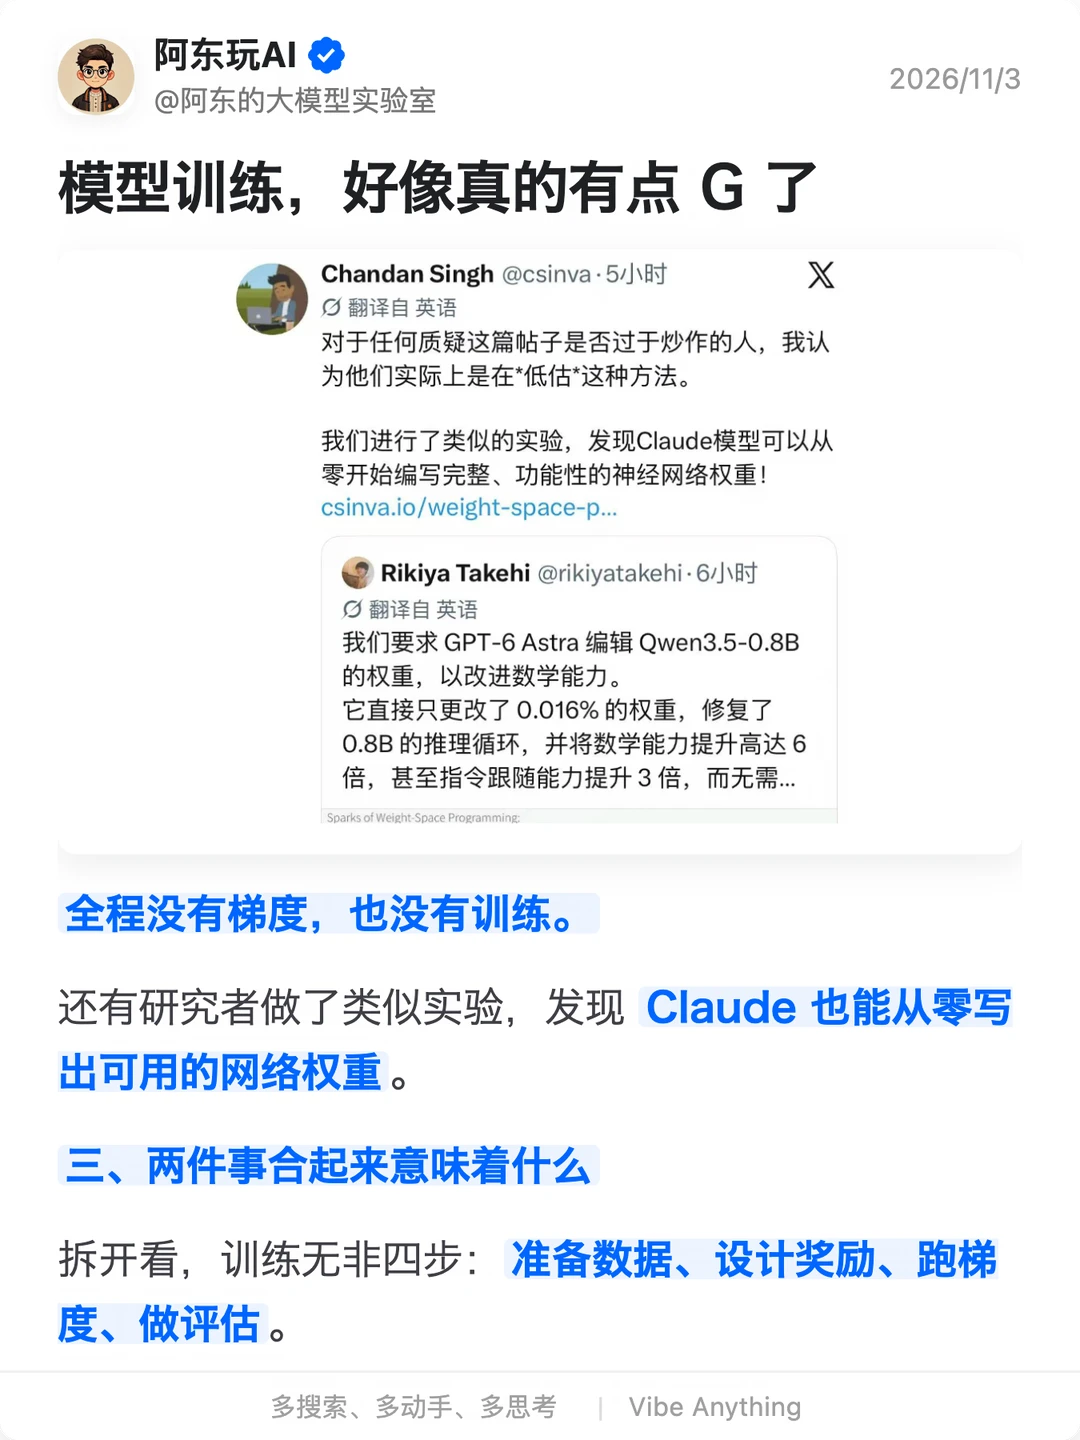
[三R]模型能改权重:不用梯度,只改了 Qwen3.5-0.8B 0.016% 的权重,MATH-500 就从 7.9% 涨到 48.1%
[四R]模型能写权重:它从零写出的打砖块网络,得分是 PPO 训练上亿步的 20 倍
现在还只是小模型上的早期结果,但“跑训练”这个活,可能会越来越不值钱。
#大模型#后训练 #RSI #agent #模型训练 #权重编辑 #算法 #howto用好AI