阿东刷到一个宝藏仓库:想学 Agentic RL,又被 4 卡、8 卡和一堆训练部署配置劝退过的,一定要看看。
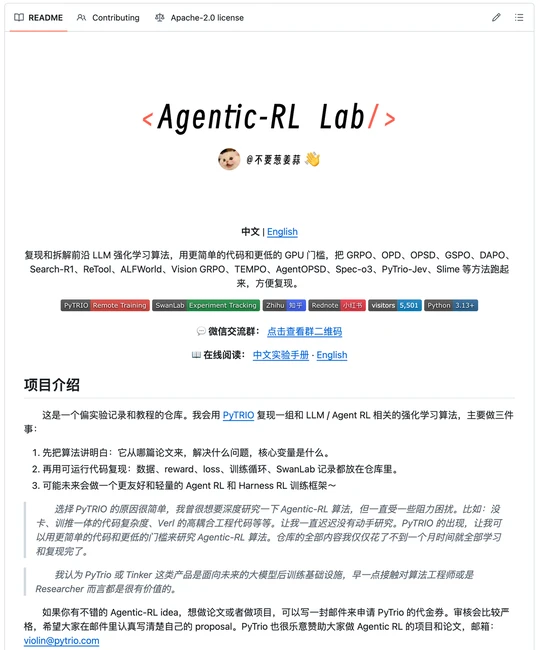
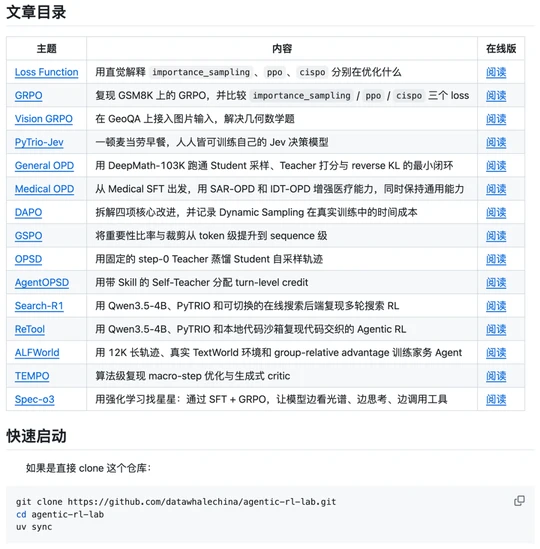
这是 Datawhale 成员宋志学做的 Agentic-RL Lab。他借助 Tinker 和 PyTrio 的 Train API,把繁重的训练工程剥离出去,只留下论文里最核心的几行公式。不到两个月,他复现了 14 篇 Agentic RL 论文
[一R]先学懂一次策略更新:GRPO 在 GSM8K 上对比三种 loss,GSPO 讲序列级优化
[二R]把教师反馈变成学习信号:在线策略蒸馏 OPD 和自蒸馏 OPSD
[三R]让模型和外界交互:Search-R1 做多轮搜索,ReTool 调用 Python,ALFWorld 里做家务
[四R]挑战更难的任务:Vision GRPO 做几何题,AgentOPSD 做信用分配,Spec-o3 用光谱数据找星星
每章都把公式、数据处理、训练循环和 SwanLab 记录放在一起,读到一个算法,旁边就有能动手跑的代码。
作者还提到,有位朋友面试时,简历上写的就是仓库里的 AgentOPSD,现在已经入职了。
学前沿技术的机会,不该取决于你手里有几张卡。
🔗 github.com/datawhalechina/agentic-rl-lab
#agenticrl #强化学习 #大模型 #grpo #开源项目 #datawhale #ai学习