上条我泼了盆冷水,这条来拆账:「万物皆可 RSI」的原论文,到底跑通了什么。
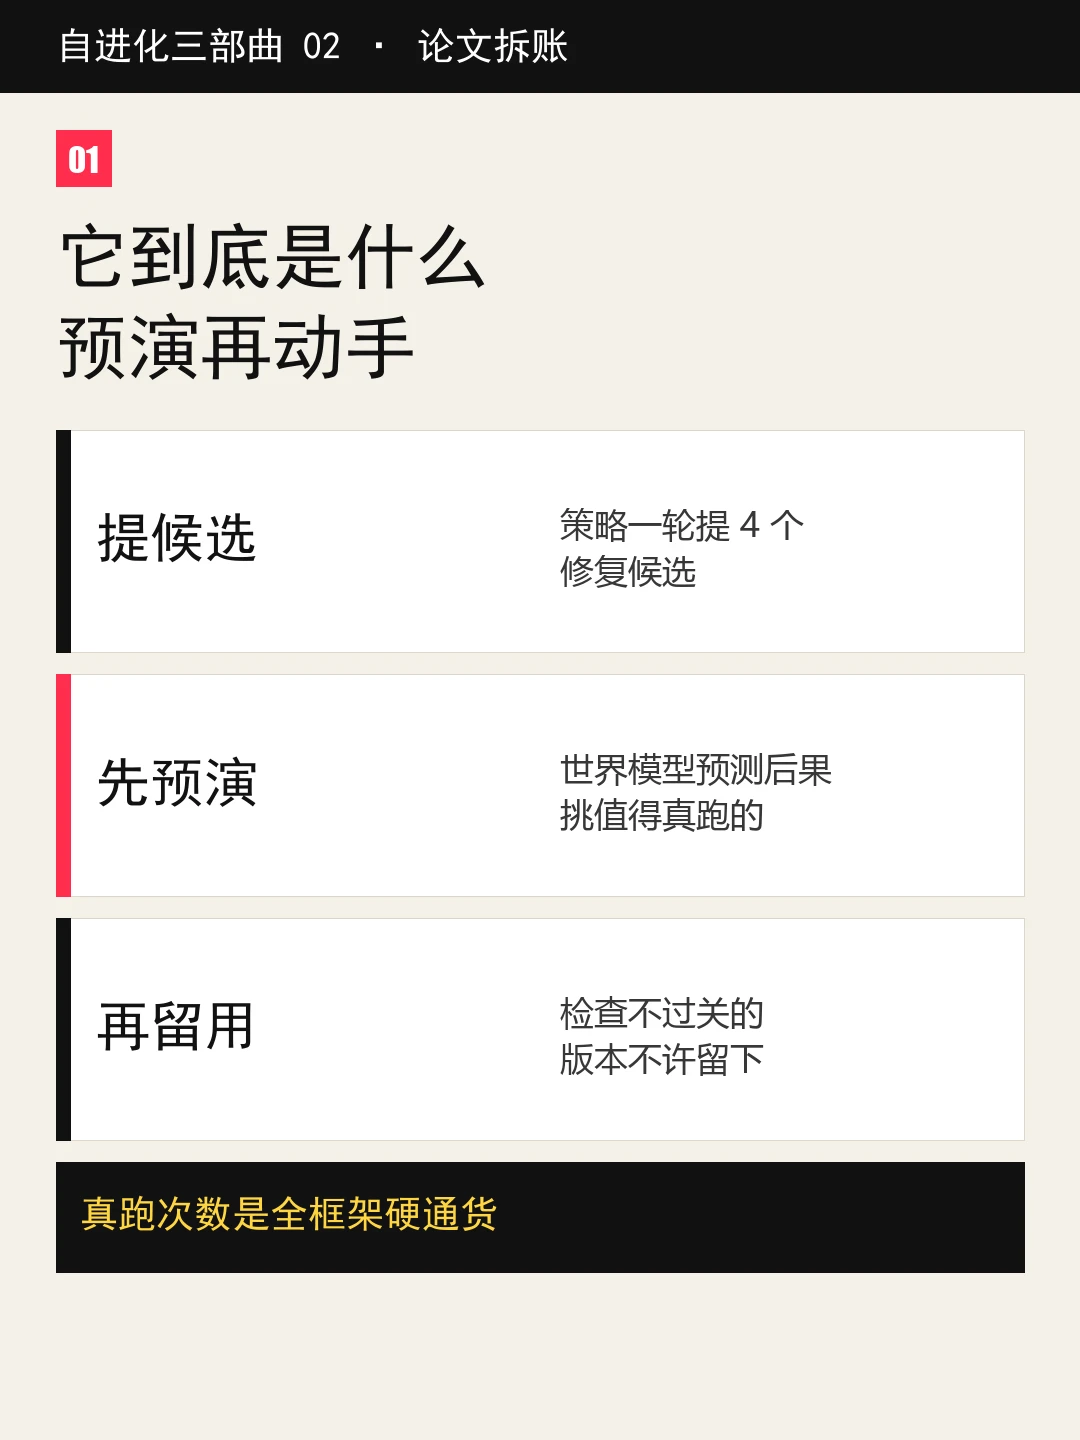
RSI 就是递归自我改进——AI 改自己,改完的自己再改下一轮。这篇的做法是给 AI 塞了个「世界模型」:动手前先预演每个候选动作的后果,挑值得花真跑次数的那个去执行。🔥
【为什么这么设计】
作者的意思很直白:真实反馈太贵。修代码只能真跑一次测试,做化学实验一次就是一次的钱。
让世界模型当「预演器」,同样的反馈预算能多榨出一截成绩。💡
【五领域成绩(论文自报)】
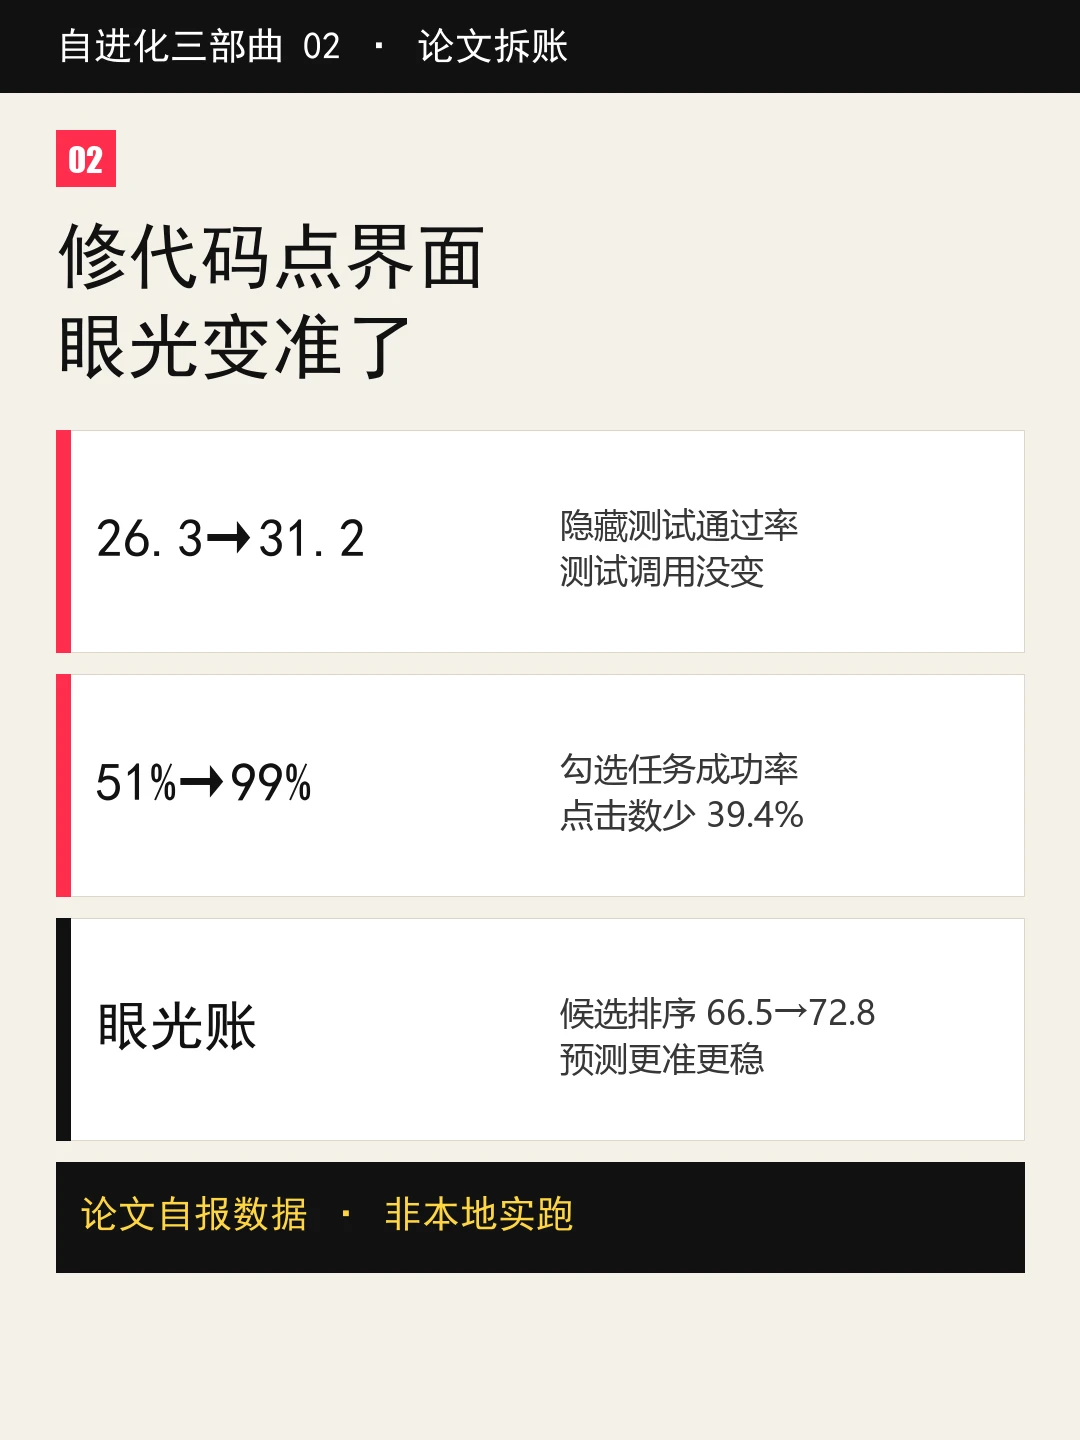
修代码:隐藏测试通过率 26.3% 到 31.2%。测试调用次数没变,纯靠挑候选的眼光变准。
点界面:勾选任务成功率 51% 到 99%。平均点击数少了 39.4%。
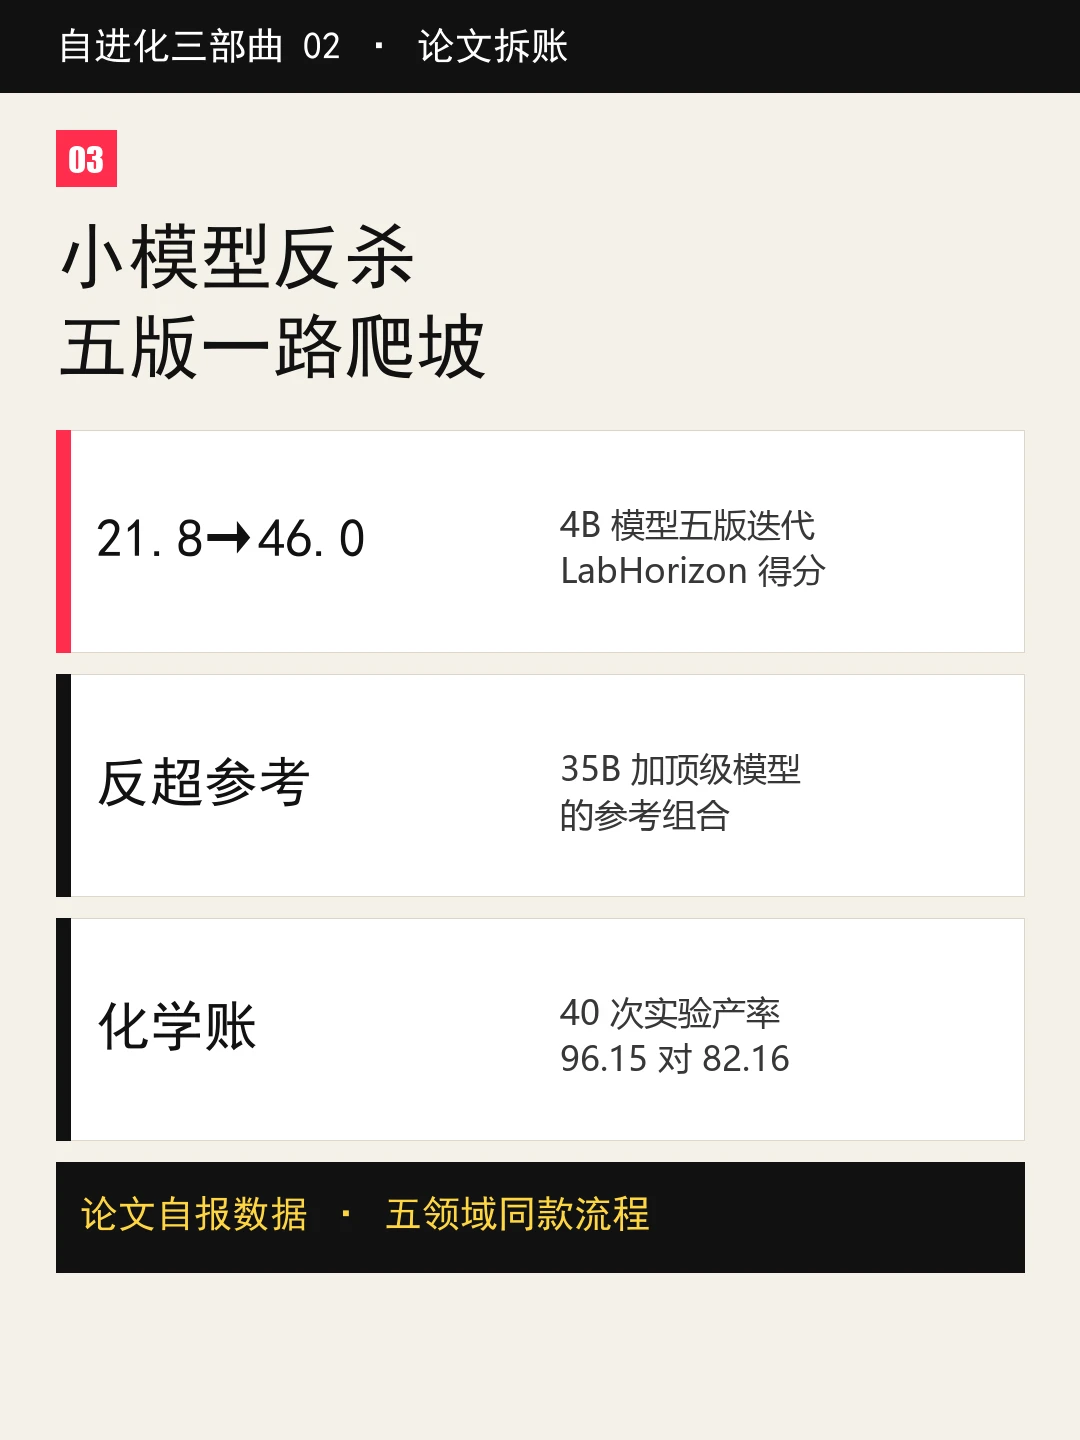
排实验:4B 小模型连改五版。LabHorizon 得分 21.8% 到 46.01%。反超一个 35B 加顶级模型的参考组合。
做化学:同样 40 次实验。产率 96.15% 对 82.16%。比贝叶斯优化多榨出近 14 个点。📊
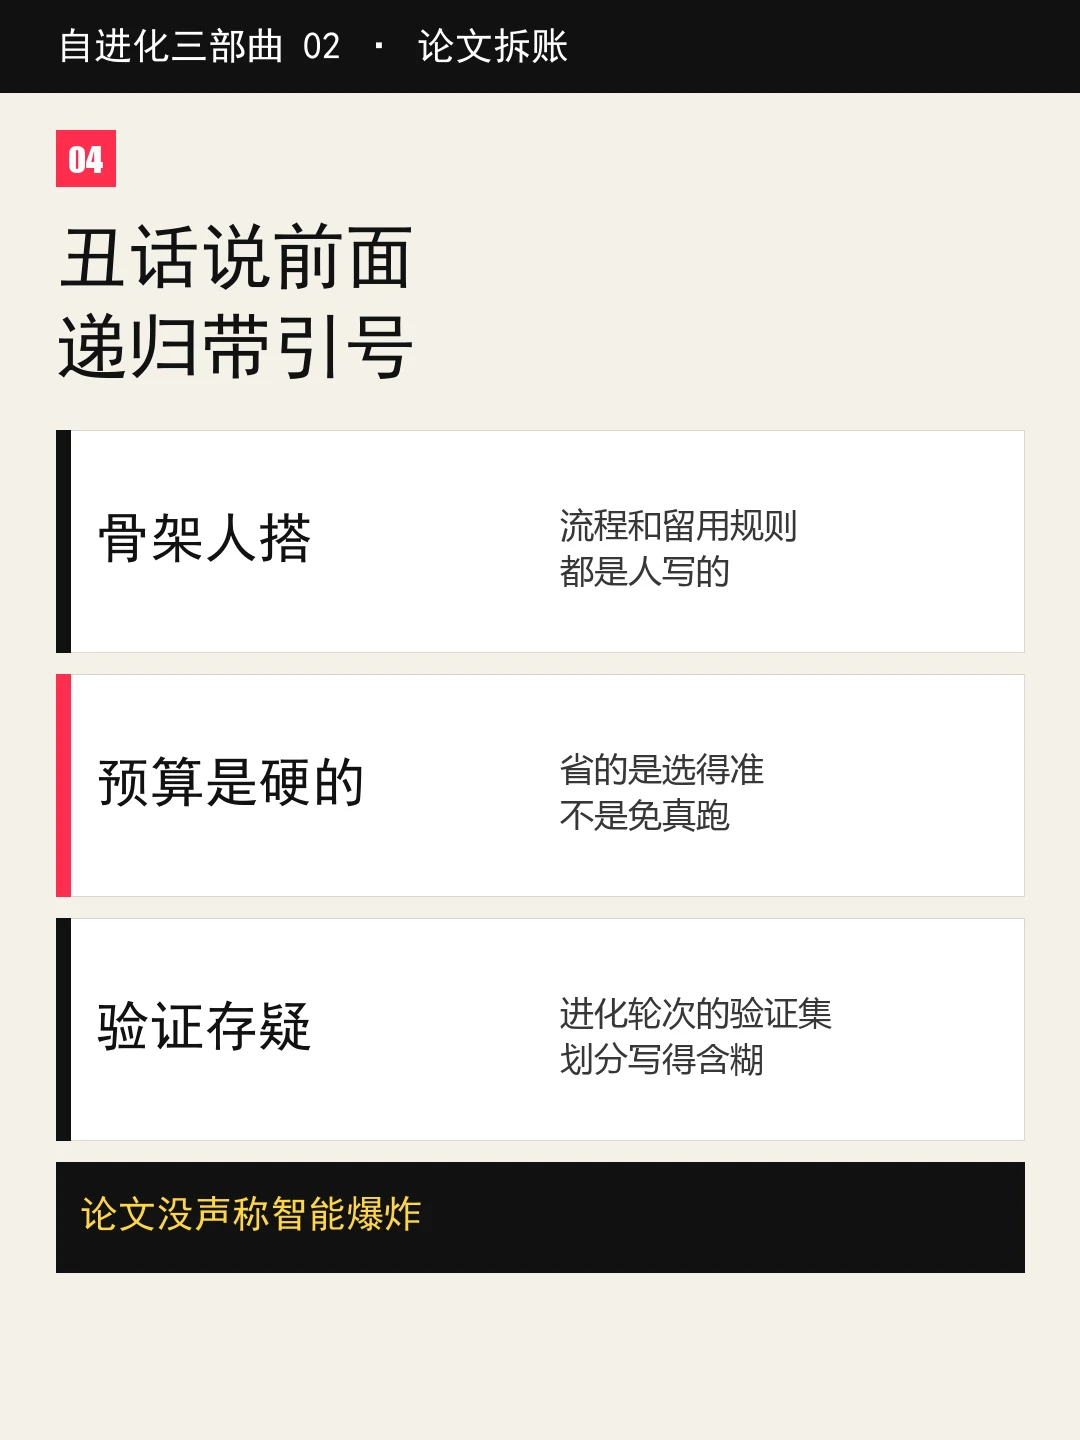
【丑话说前面】
这个「递归」是打引号的。骨架人搭,留用人写,论文也没声称智能爆炸。
反馈预算照样是硬约束:省的是「选得准」,不是免真跑。
进化轮次的验证集划分,论文写得不如 Google 那篇明白——这点我保留意见。🎯
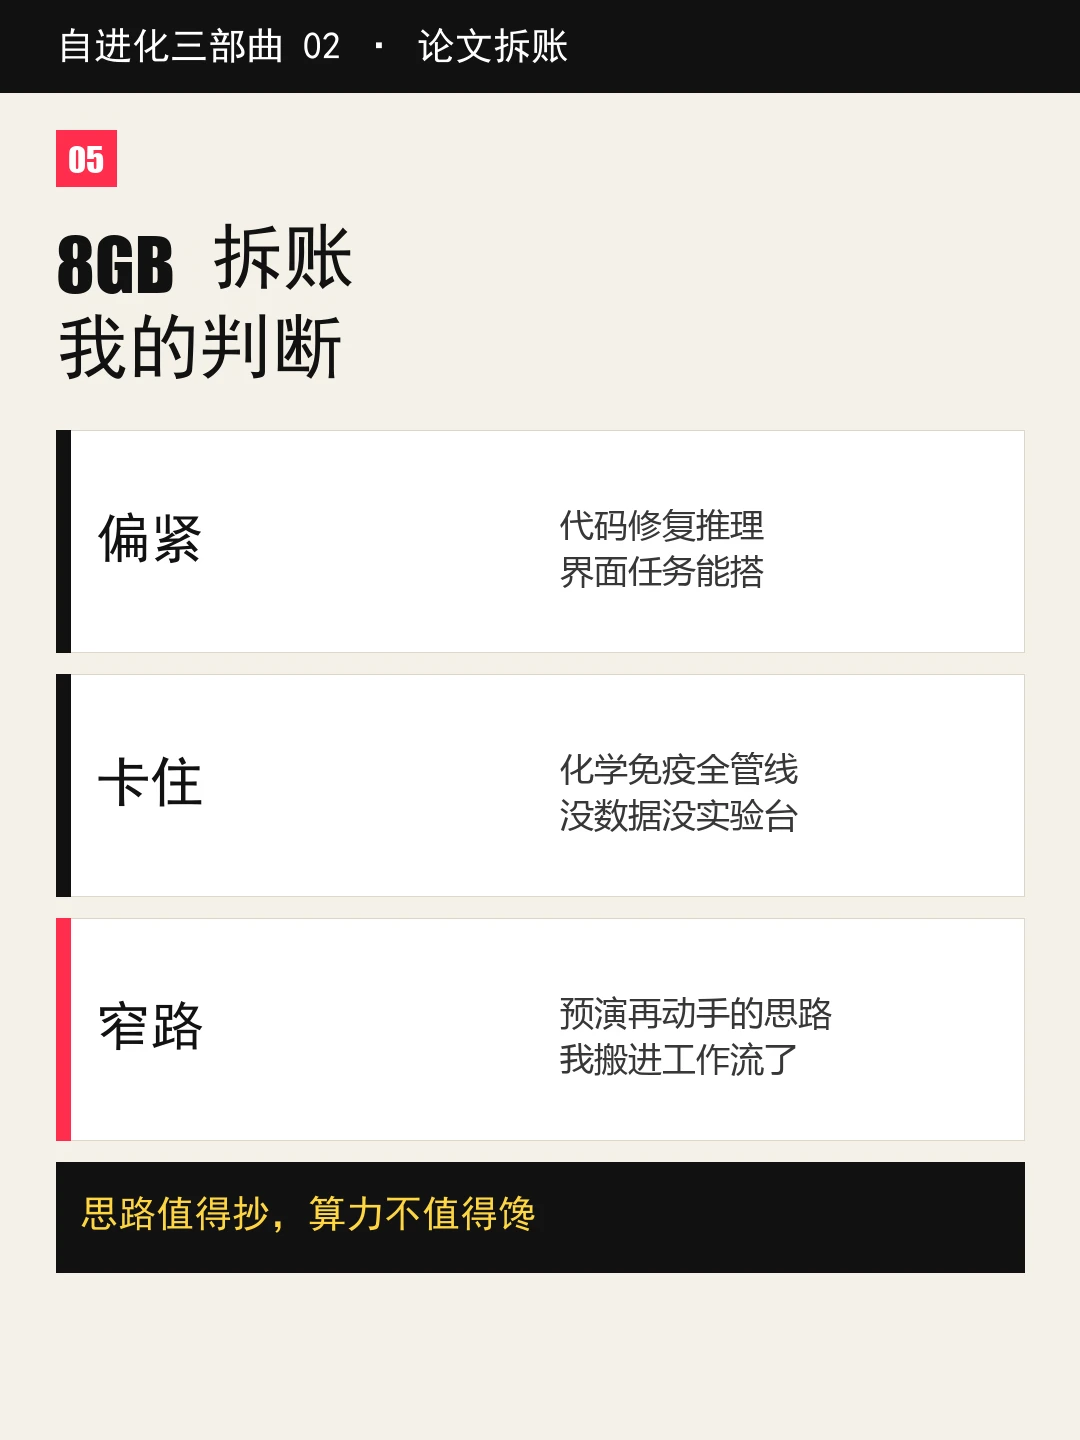
【8GB 拆账】
逐环节判:代码修复推理=偏紧,小档模型能推,多候选多轮很慢。
界面任务=偏紧,本地浏览器能搭,环境折腾。化学和免疫=卡住,没数据没实验台。全管线复现=卡住,仓库以 Linux 优先,世界模型要训练。🔍
【我的判断】
不装:这机器跑不了它的全管线,我一行都没复现。
窄路:「预演再动手」的思路通用,我把它用进了自己的工作流,下条讲。
观察:世界模型当预演器,哪天下放到小模型,我回来补测。✨
我算完的账:思路值得抄,算力不值得馋。细目数据都在后面几张卡里。
#RSI #自进化 #AI论文 #人工智能 #AI #AI趋势 #8GB显卡实测 #WeeklyPick