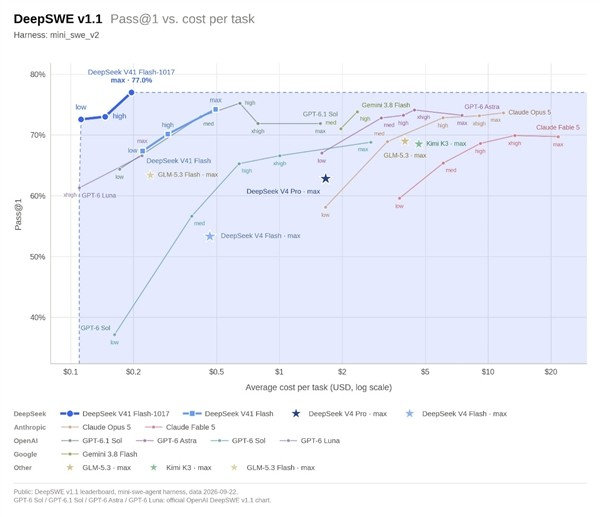
【DeepSeek新模型Token消耗降超五成,DeepSeek新模型成本降至竞品百分之一】DeepSeek正式推出大模型新版本V4.1 Flash-1017。在国产人工智能大模型普遍处于迭代关键期的当下,该版本率先完成升级,整体性能实现显著跃升。
此前已有公开数据显示其技术指标,此次DeepSeek更首次自主发布帕累托前沿曲线,直观呈现模型在效率与成本维度的综合表现。V4.1 Flash-1017在此曲线中达到行业领先水平:单位任务综合成本仅为Fable、Astra等同类模型的百分之一至二十分之一,性价比优势达四五十倍以上。
这一突破性成本控制能力源于DeepSeek长期积累的底层AI工程优化实力。尤其在硬件适配与推理效率层面,其技术深度持续刷新行业认知。参考SemiAnalysis AgentX基准测试结果,在GB300 NVL72硬件平台与Dynamo vLLM推理框架下,V4.1 Flash实测达成每美元处理13亿Token的算力吞吐效率,用户端P90交互延迟稳定低于10毫秒,即每秒输出超100 Token。
按此测算,单百万Token的算力侧成本约为0.00077美元,远低于当前API接口对输入Token所标注的0.15美元单价。需说明的是,二者统计口径存在本质差异:前者反映纯算力端总拥有成本(TCO),后者则涵盖服务运营、模型维护、弹性扩容等多重商业要素。正因DeepSeek在底层实现了极高的资源利用效率,才为其在终端定价策略上提供了无可比拟的腾挪空间。
市场响应迅速印证了这一优势。多家主流开发平台已基于V4.1 Flash推出极具竞争力的服务方案——例如OpenCode与CommandCode近期上线的10美元套餐,实际可用额度已提升至80至120美元区间;OpenCode更于近日开放免费调用通道。当前,聚合路由网络中V4.1 Flash的月度调用量已达百万亿Token量级,单一体系承载能力相当于六至七家同规模竞品之和。
横向对比显示,在万亿参数量级以内,其余主流开源大模型的单位产出TCO普遍仅为V4.1 Flash的十分之一;若扩展至1.5至3万亿参数范围,成本差距进一步拉大至40至50倍。值得注意的是,上述TCO数据仍基于前期版本V4.1 Flash-0910测算。本次发布的1017版本虽维持原有API价格体系,但在Token使用效率方面完成深度重构——通过任务感知型压缩、动态上下文裁剪及自适应解码策略,显著降低各类型请求的实际Token消耗。实测表明,多数场景下Token用量较前版下降逾50%,相应TCO水平亦将同步迎来新一轮实质性下探。(中关村在线)