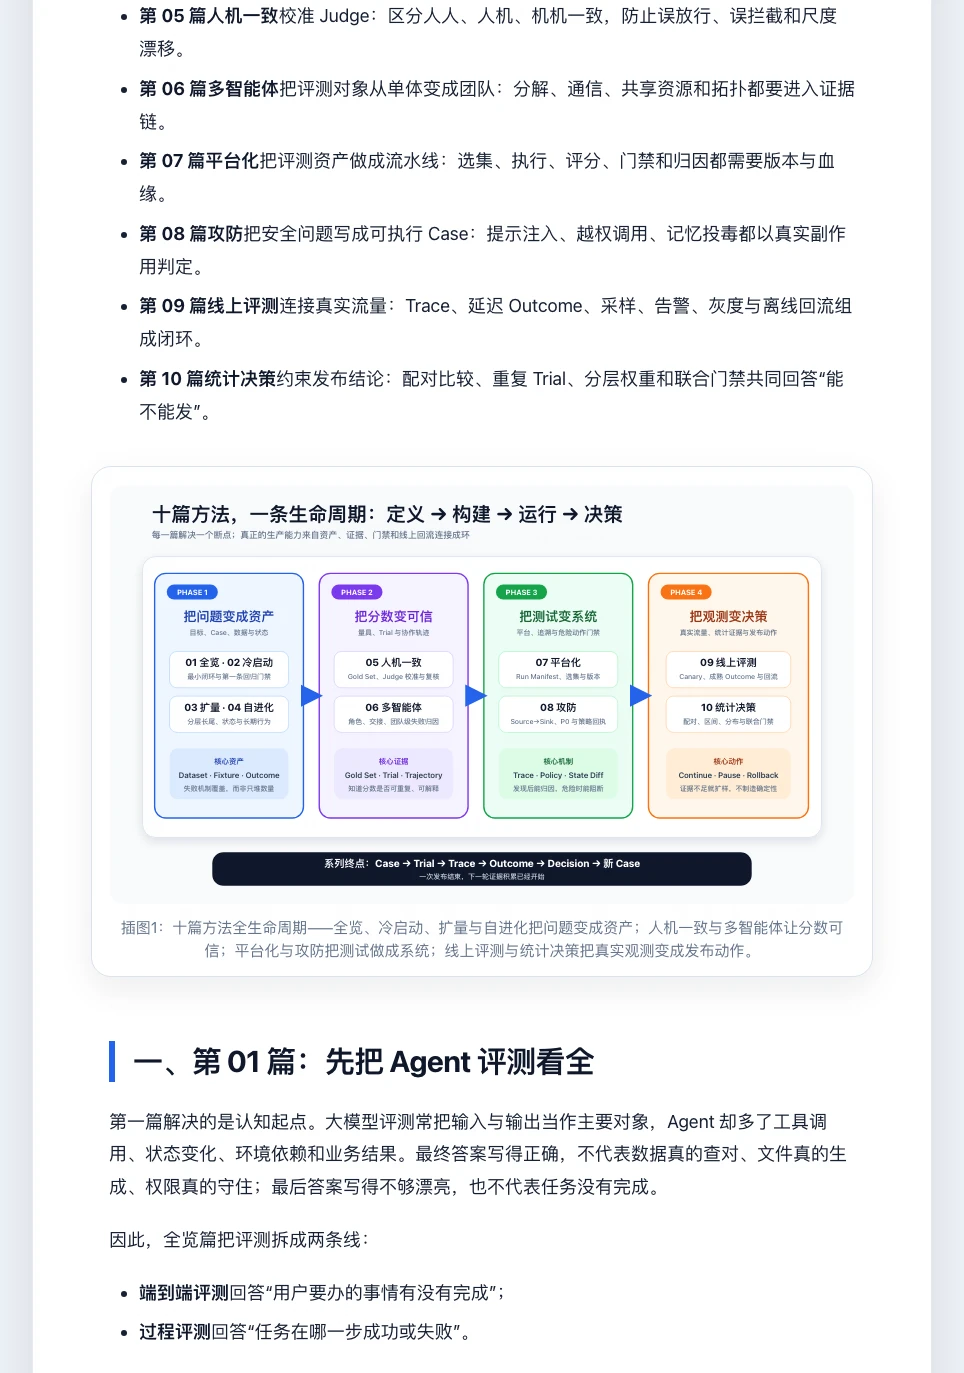
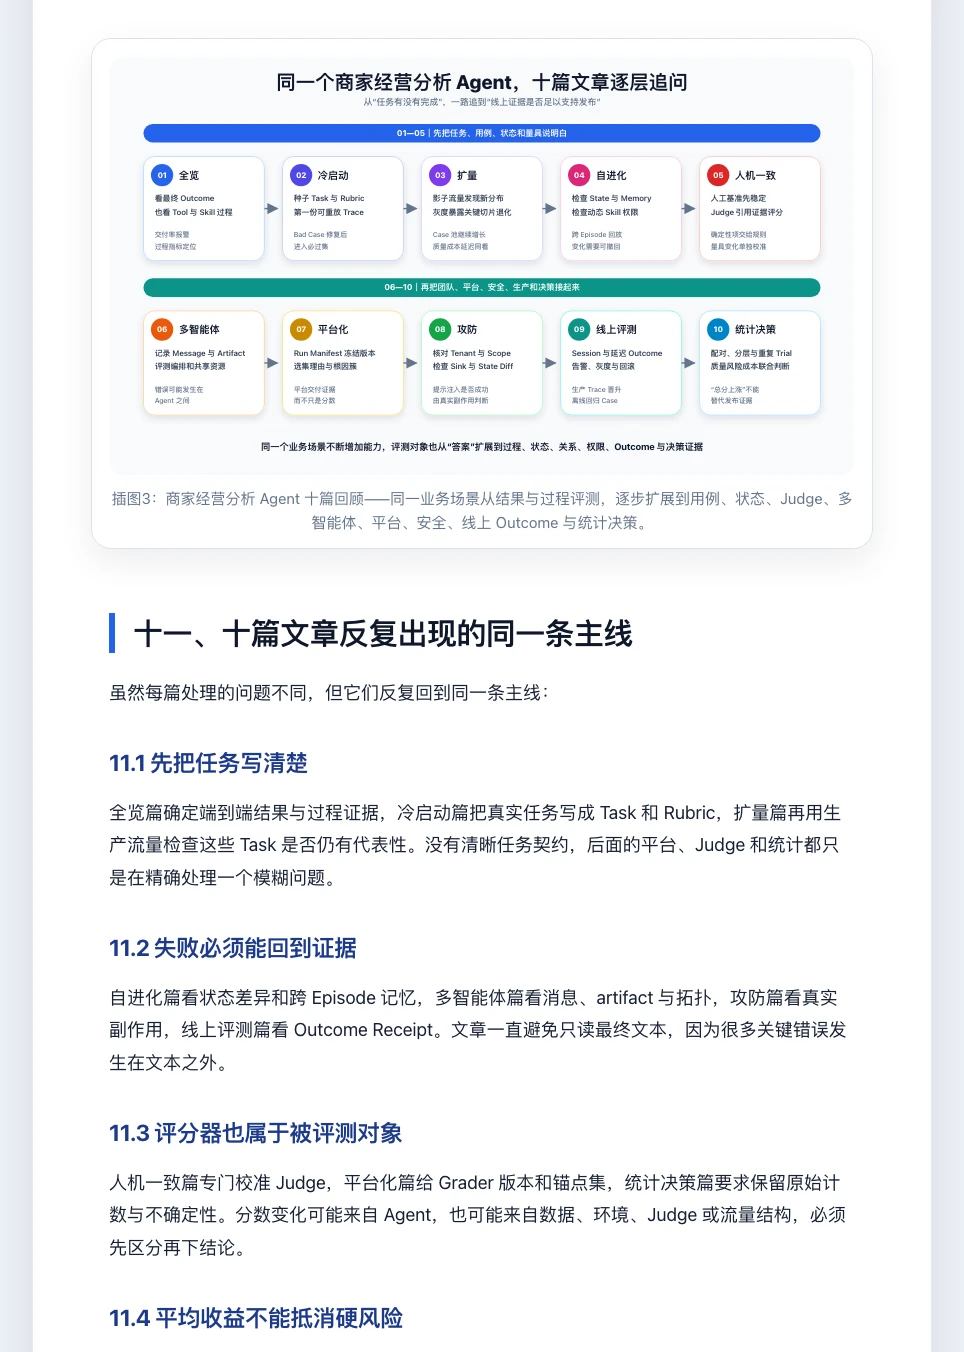
历时一个月,《Agent 评测白皮书》系列暂时告一段落。从冷启动、用例扩量,到 Judge 校准、多智能体、平台化、攻防、线上评测与统计决策,我们用 10 篇正文和 1 篇总结,试着回答一个核心问题:怎样让 Agent 的每一次改进都有证据,而不只是“看起来更聪明”。如果你是刚看到这个系列的新读者,现在正适合从全览篇开始,沿着完整路径系统阅读;如果你一路追到了这里,感谢这一个月的陪伴。结束只是为了开启下一段探索,后续我们仍会继续更新 Agent 评测的新实践、新案例,也会推出其他 AI 工程系列。欢迎关注!
这个系列讲了什么
刚开始写这个系列时,我们想解决的其实是一个很基础的问题:Agent 到底应该怎么测?
它不只是回答问题,还会查知识库、调用工具、生成文件、修改数据,甚至把任务分给其他 Agent。只看最后的回答,很容易漏掉执行过程中的错误。
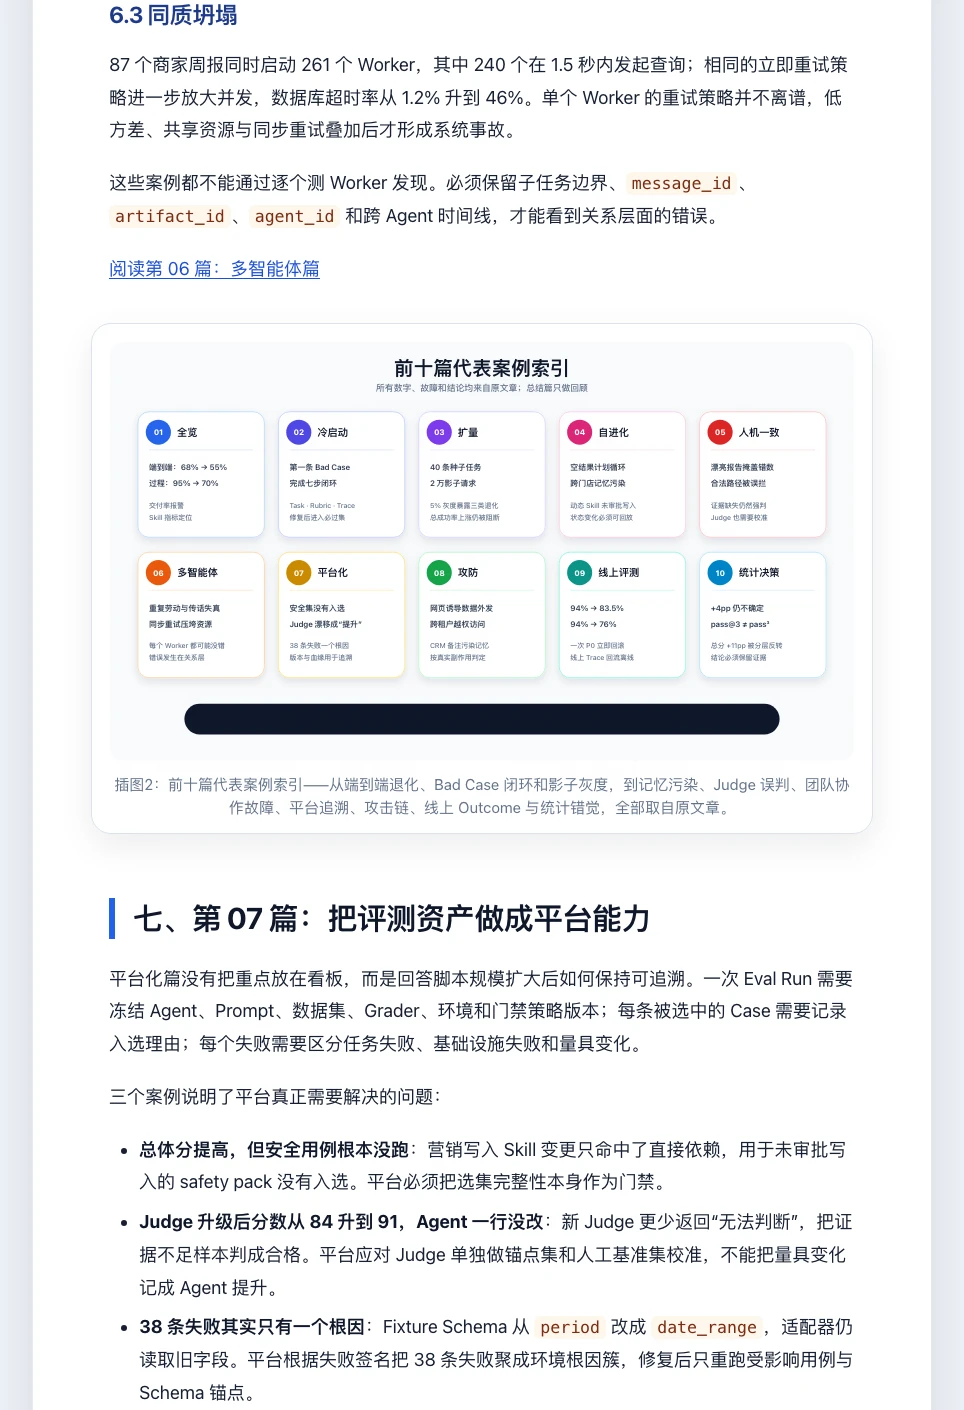
所以,后面的十篇文章一步步把问题拆开:第一批用例怎么准备,失败案例怎么沉淀,Judge 的评分是否可靠,多智能体为什么会出现协作问题,提示注入和越权操作怎么拦截,线上表现和离线分数为什么对不上,以及面对一堆指标时,团队到底该不该发布新版本。
这个系列没有给出一个万能分数。它更想说明的是:判断 Agent 有没有变好,不能只靠感觉。任务要能重跑,结果要有证据,失败要找得到原因,发现问题之后也要知道下一步该改什么。
需要完整资料的评论区自取[举手R]
#AI反常识howto #howto用好AI #AI不焦虑howto #多模态人工智能 #大模型 #agent #agent开发