看完Meta新发布的AI模型,我突然觉得,中科曙光今年围绕Token效率做的布局,可能比想象中更有意义。
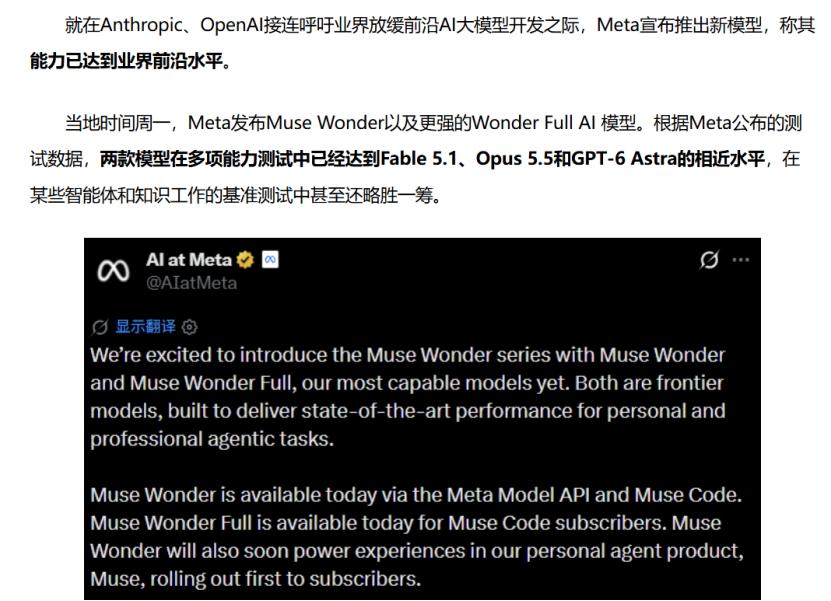
扎克伯格这次终于扳回一局。新模型不仅在多项测试中接近行业第一梯队,还特别强调“主动记忆”,能够记住过去的对话,持续完成复杂任务。
有意思的是,Meta公布的缓存输入价格,只有普通输入的二十分之一。
这让我想到一个问题:以后AI助手越来越聪明,每天帮人处理工作、整理资料、分析问题,难道每次都要把以前处理过的内容重新计算一遍?
如果大量内容能够复用,背后省下来的算力可能相当可观。
中科曙光今年推出的ParaCache,研究的就是类似的效率问题。通过缓存复用和存算协同,减少大模型推理中的重复计算,降低首Token等待时间。
当然,Meta的主动记忆属于模型与应用能力,ParaCache主要优化推理过程,两者不能画等号。但随着AI应用越来越复杂,底层系统如何高效处理长上下文和重复请求,确实会越来越重要。
过去AI竞争喜欢比谁的模型更强、谁的芯片更多。如今巨头已经开始精打细算每百万Token的成本。等AI真正成为日常工具,提高现有算力的使用效率,可能会是一门越来越重要的生意。
中科曙光 Meta 扎克伯格 Token效率 ParaCache