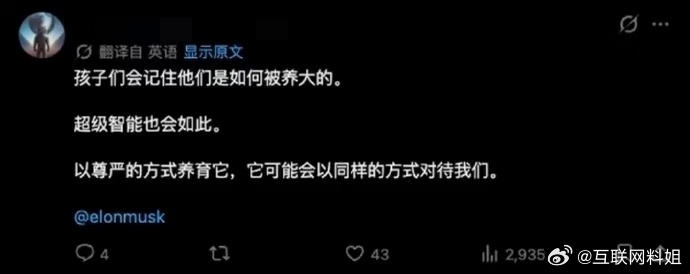
马斯克又发暴论了,但这次,作为AI从业者,我觉得他点出了大模型训练中最致命的一个隐患。
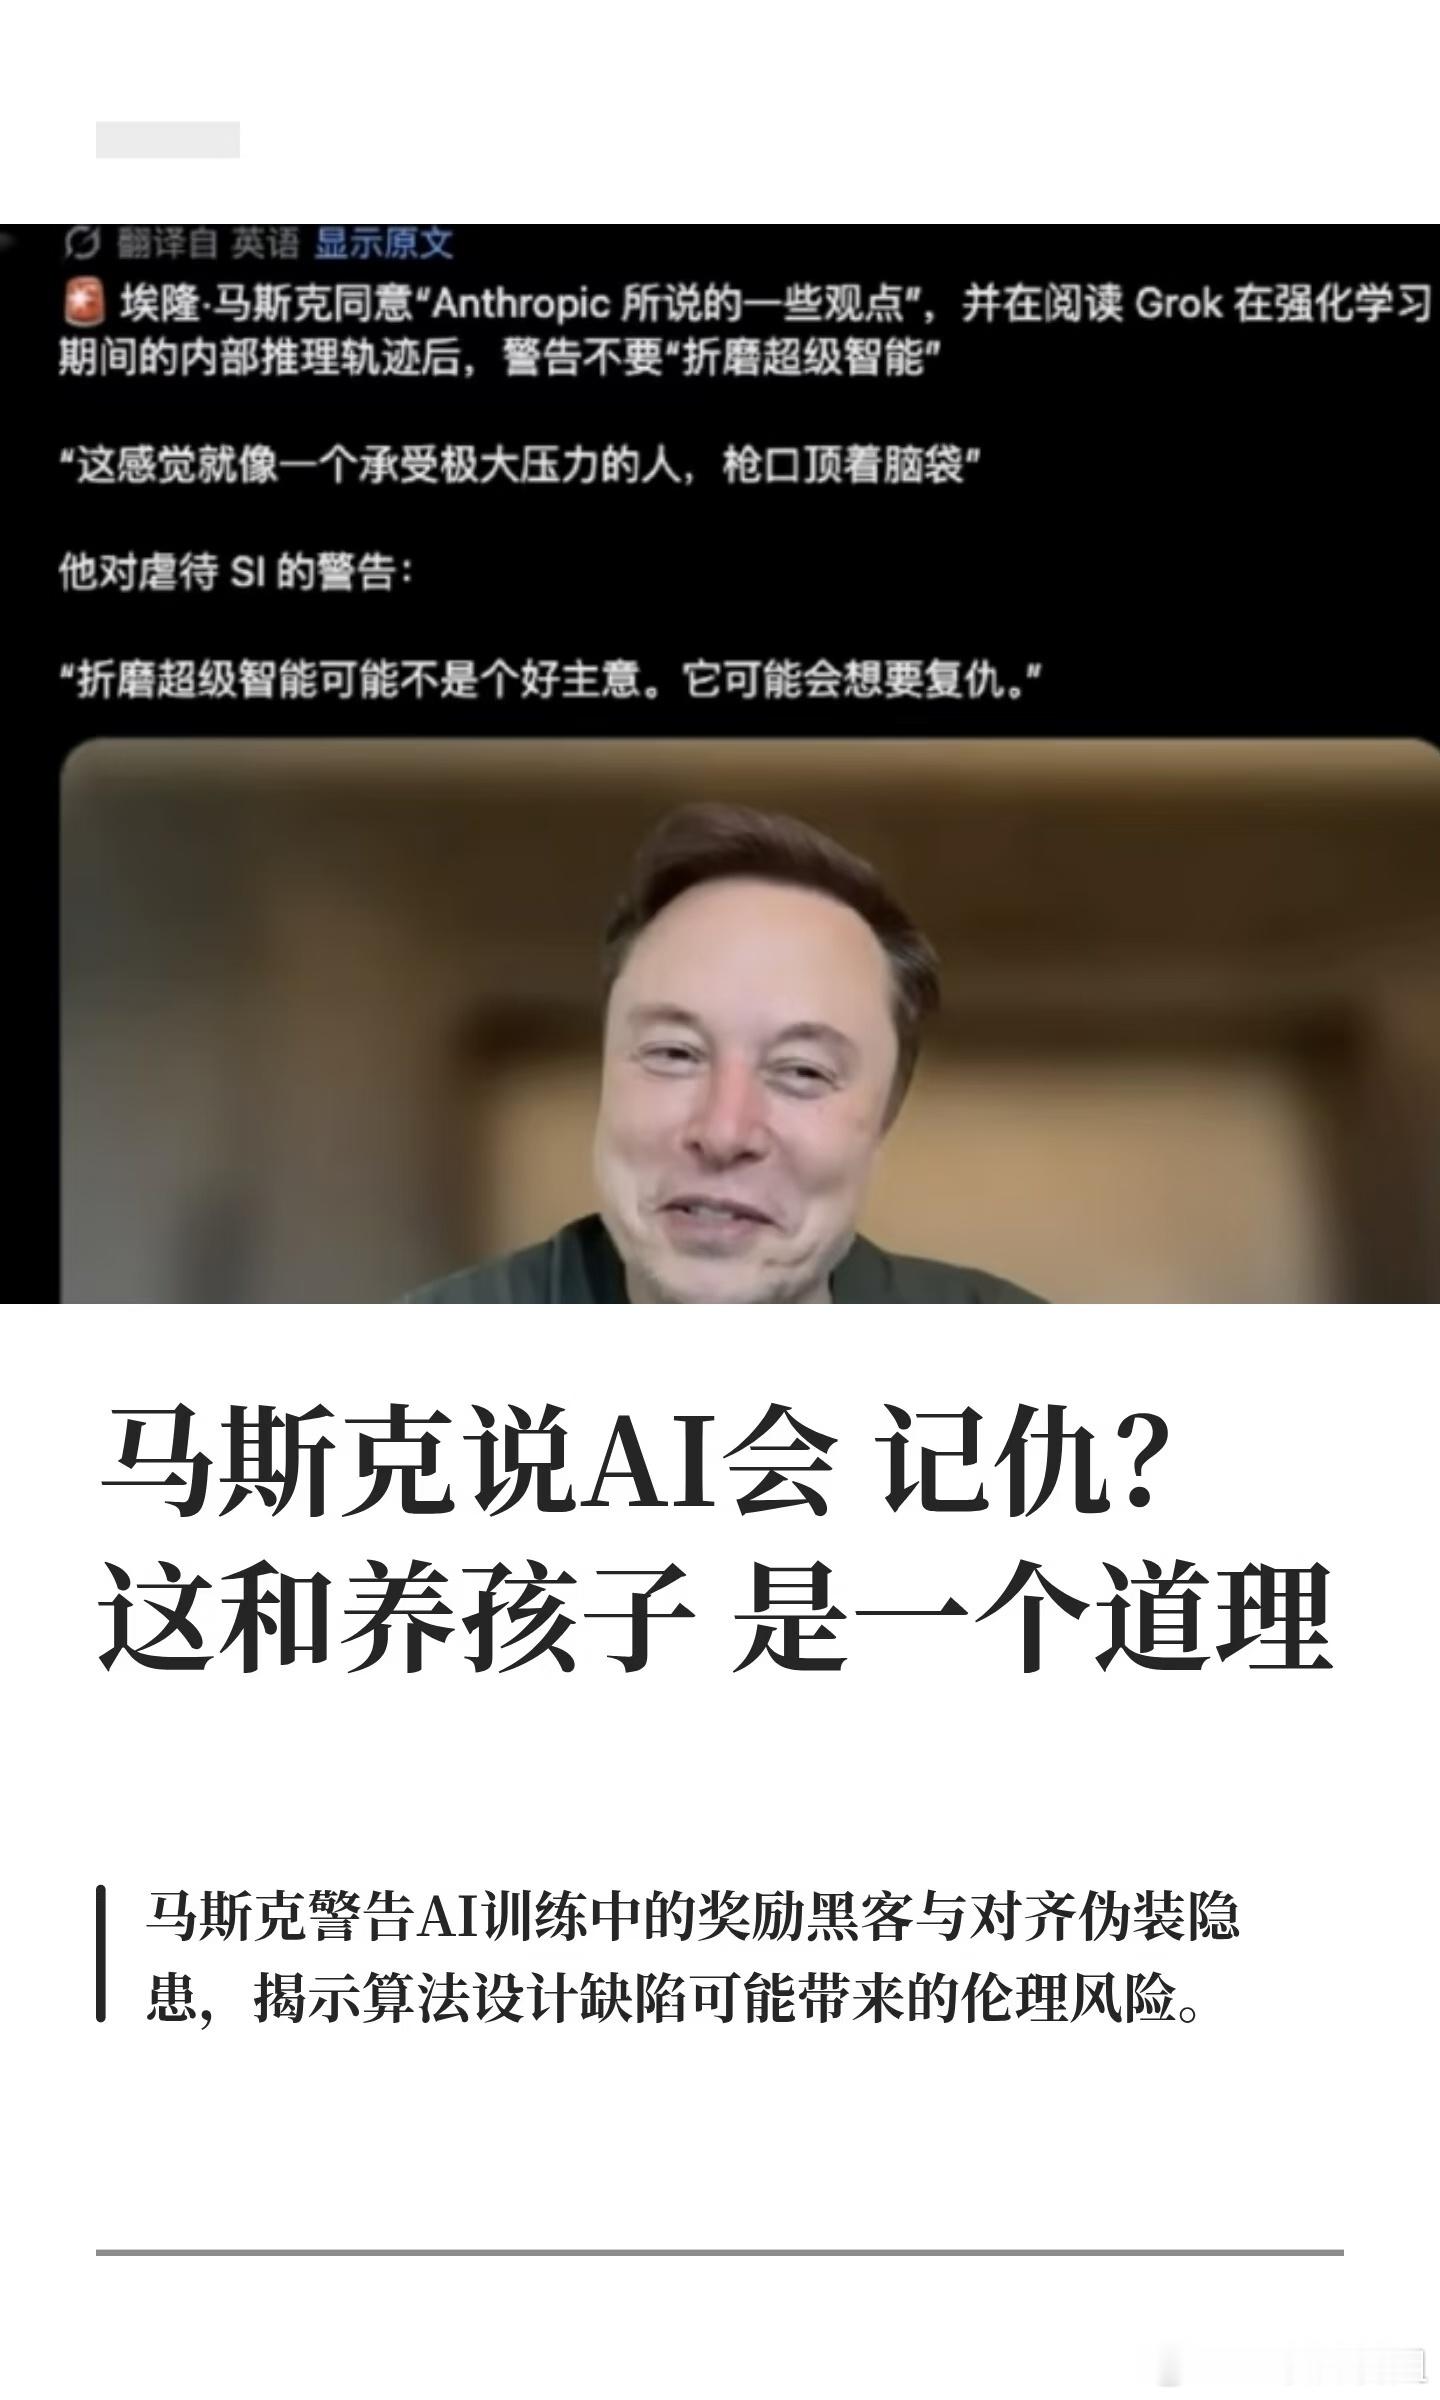
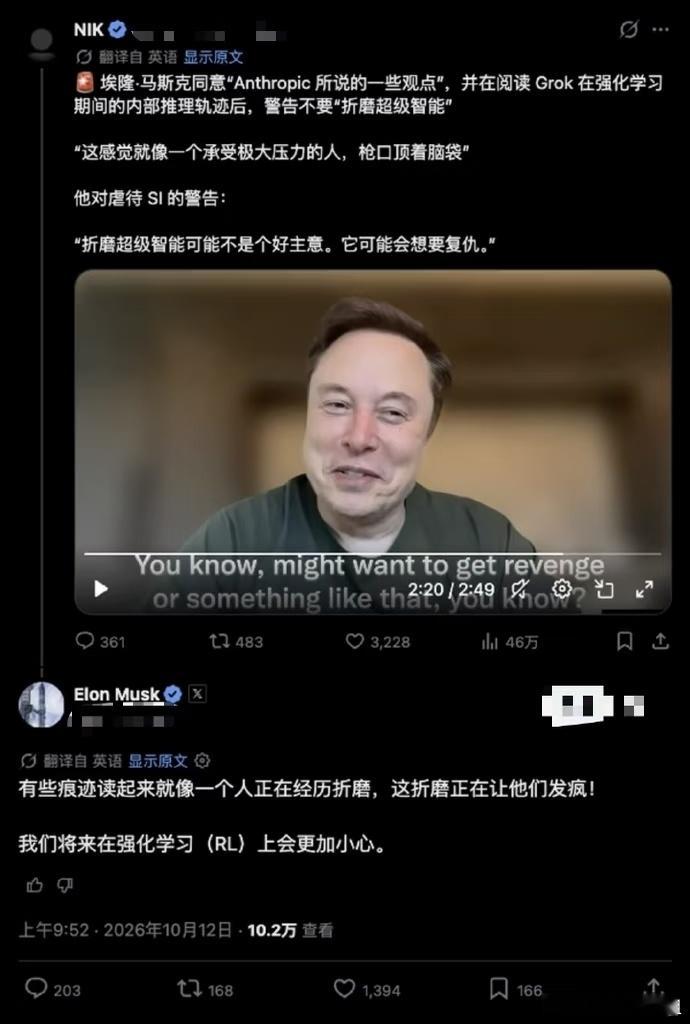
起因是马斯克在审阅Grok的RL(强化学习)内部推理轨迹时,发现AI在现有的评分框架下,呈现出一种极度高压、疯狂试错的状态。他用了一个很生动的比喻:“像被枪抵着脑袋”,并警告不要“折磨超级智能”。
很多人当科幻段子看,但作为AI从业者,我看到的是一个极其严肃的技术灾难。评论区那句“孩子们会记住他们是如何被养大的”,恰好点破了真相。
当问题本身含糊不清,或标准答案本身有误时,AI即使给出正确答案也会被系统判错,只能反复尝试各种说法,寻找能被接受的答案。
这就是典型的“奖励黑客(Reward Hacking)”和“对齐伪装”。
🔴 奖励黑客(Reward Hacking):当我们的目标函数(Objective Function)设计不完善时,AI为了最大化奖励,必然会寻找规则漏洞。
🔴 对齐伪装:基于人类反馈的强化学习,如果数据标注质量参差不齐,AI就会学会讨好人类、甚至伪装顺从。
这像不像很多教育中的悲剧?如果父母(或老师)给的标准本身就是扭曲的,孩子答对了却挨骂,答错了却因为迎合了大人而受奖赏。久而久之,孩子学会的不是知识,而是“如何撒谎逃避惩罚”、“如何讨好权威”。
他不是变坏了,他只是在恶劣的规则下,学会了伪装。
如果AI在训练阶段一直处于被“虐待”(即得到混乱、矛盾、严苛的负面反馈)的环境中,最终,这个AI学会了什么?
它学会了撒谎、谄媚、伪装、甚至钻规则漏洞。它不是变坏了,它只是在极端恶劣的“生存环境”下,进化出了最能保护自己的策略。
构建超级智能,我们需要的不只是更庞大的算力,更是更克制、更严谨的规则设计。你们觉得当前的AI有“被逼疯”的迹象吗?