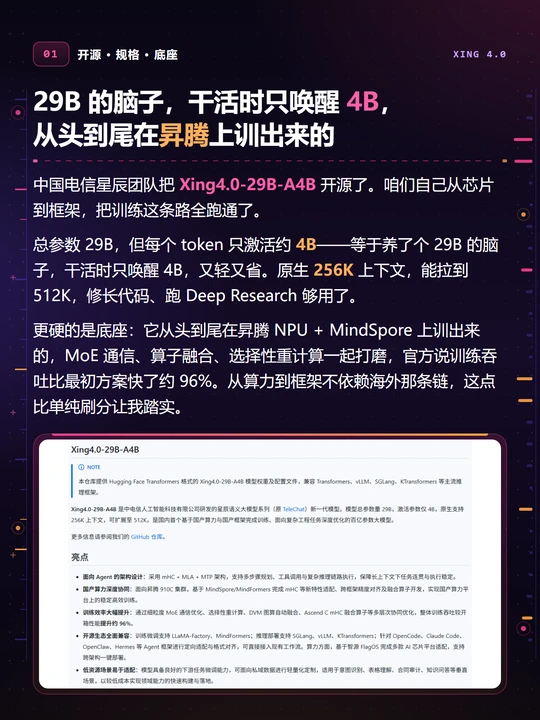
早两天,中国电信星辰团队把 Xing4.0-29B-A4B 开源了。咱们自己从芯片到框架,把训练这条路全跑通了。
总参数 29B,但每个 token 只激活约 4B——等于养了个 29B 的脑子,干活时只唤醒 4B,又轻又省。原生 256K 上下文,能拉到 512K,修长代码、跑 Deep Research 够用了。
更硬的是底座:它从头到尾在昇腾 NPU + MindSpore 上训出来的,MoE 通信、算子融合、选择性重计算一起打磨,官方说训练吞吐比最初方案快了约 96%。从算力到框架不依赖海外那条链,这点比单纯刷分让我踏实。
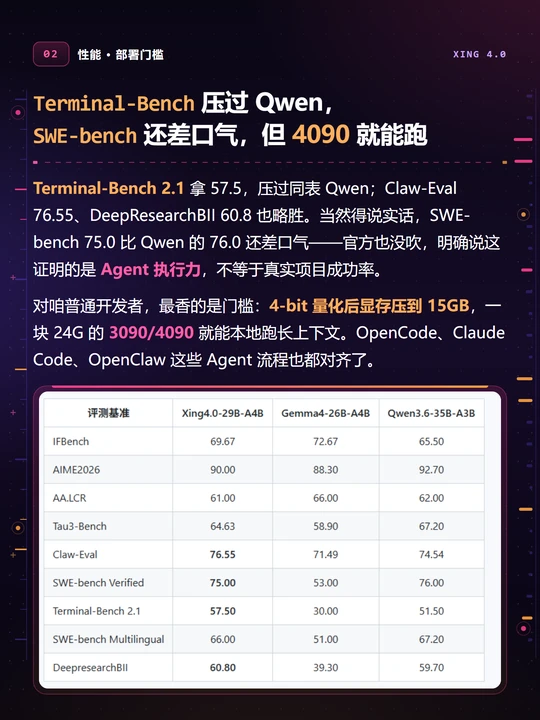
Terminal-Bench 2.1 拿 57.5,压过同表 Qwen;Claw-Eval 76.55、DeepResearchBII 60.8 也略胜。当然得说实话,SWE-bench 75.0 比 Qwen 的 76.0 还差口气——官方也没吹,明确说这证明的是 Agent 执行力,不等于真实项目成功率。
对咱普通开发者,最香的是门槛:4-bit 量化后显存压到 15GB,一块 24G 的 3090/4090 就能本地跑长上下文。OpenCode、Claude Code、OpenClaw 这些 Agent 流程也都对齐了。
#ai #ai工具 #大模型 #电信