PrismML刚发布的Ternary Bonsai 2 27B
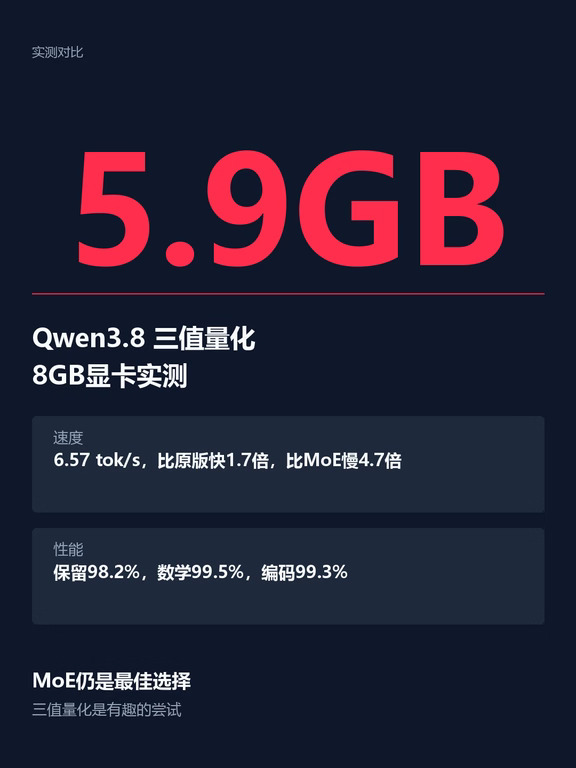
把Qwen3.8 27B用三值量化压到只有5.9GB
官方说保留98.2%性能,我拿8GB显卡实测了
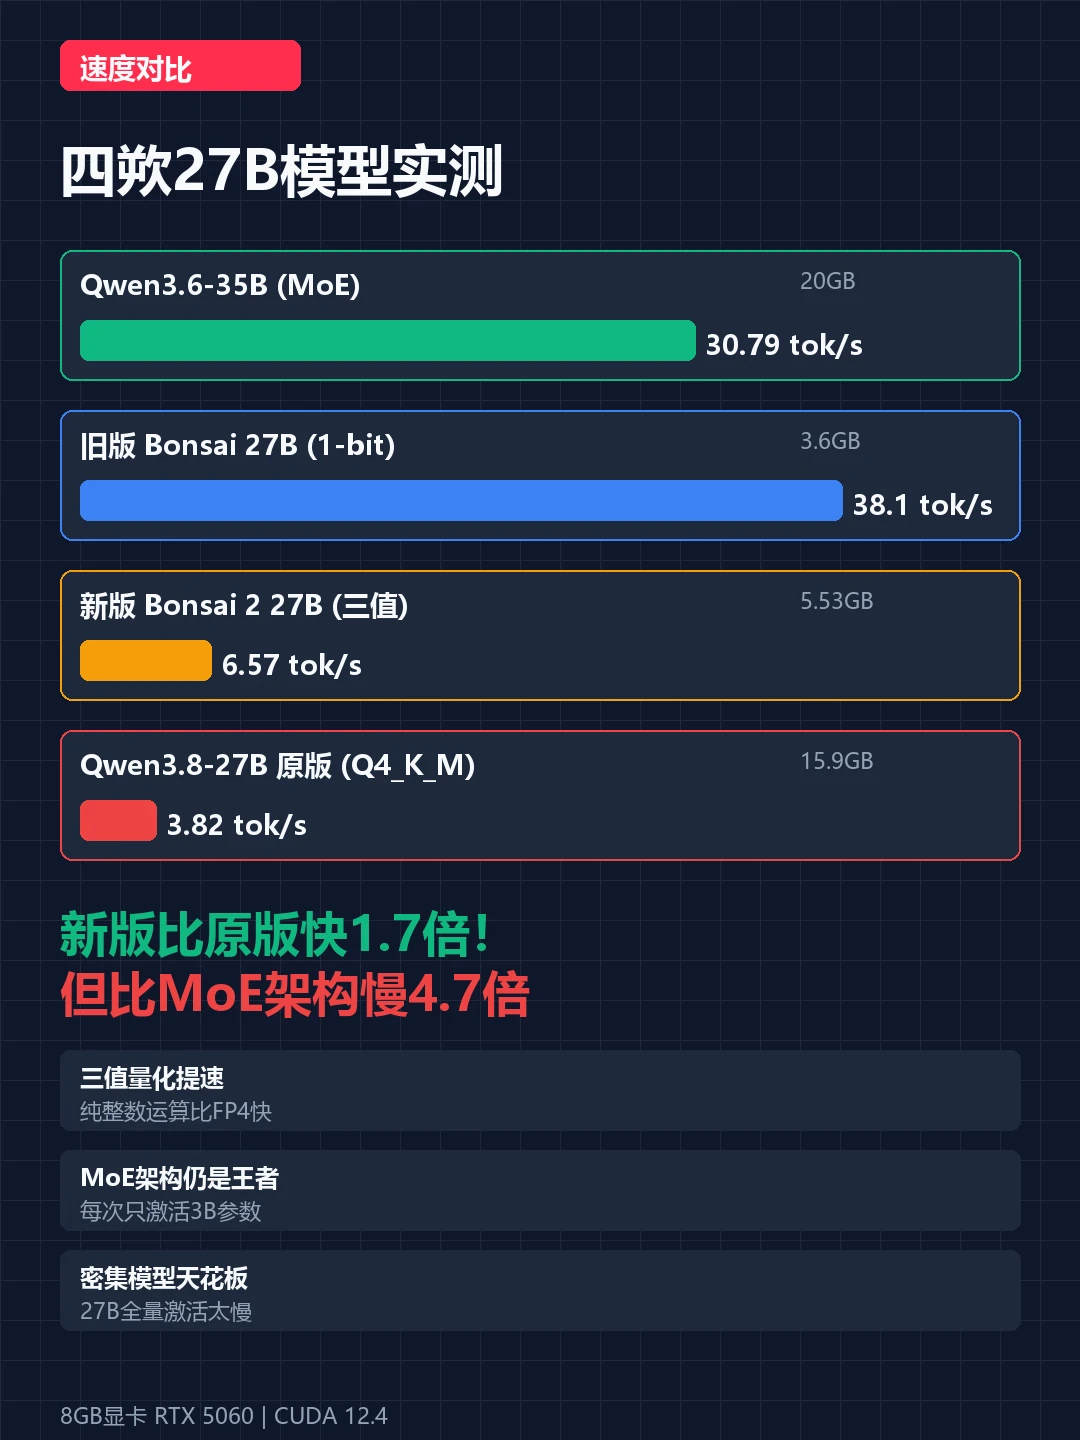
📊 四款27B模型速度对比
Qwen3.6-35B(MoE):30.79 tok/s ⭐最快
旧版Bonsai 27B(1-bit):38.1 tok/s
新版Bonsai 2 27B(三值):6.57 tok/s
Qwen3.8-27B原版(Q4_K_M):3.82 tok/s
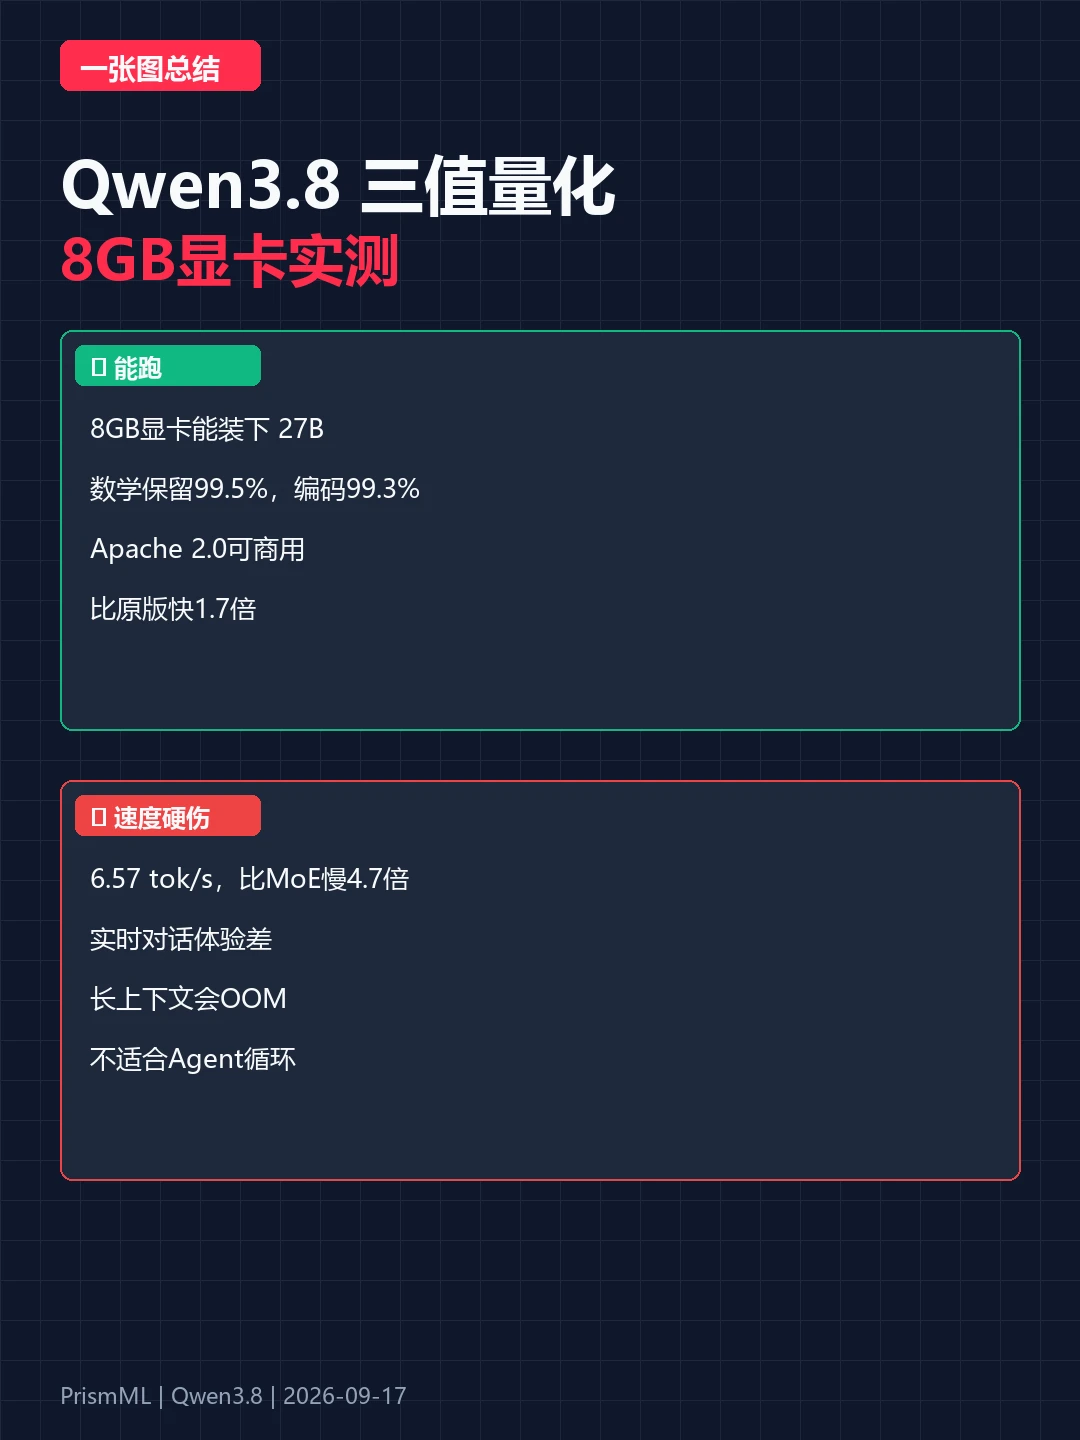
新版比原版快1.7倍!但比MoE架构慢4.7倍
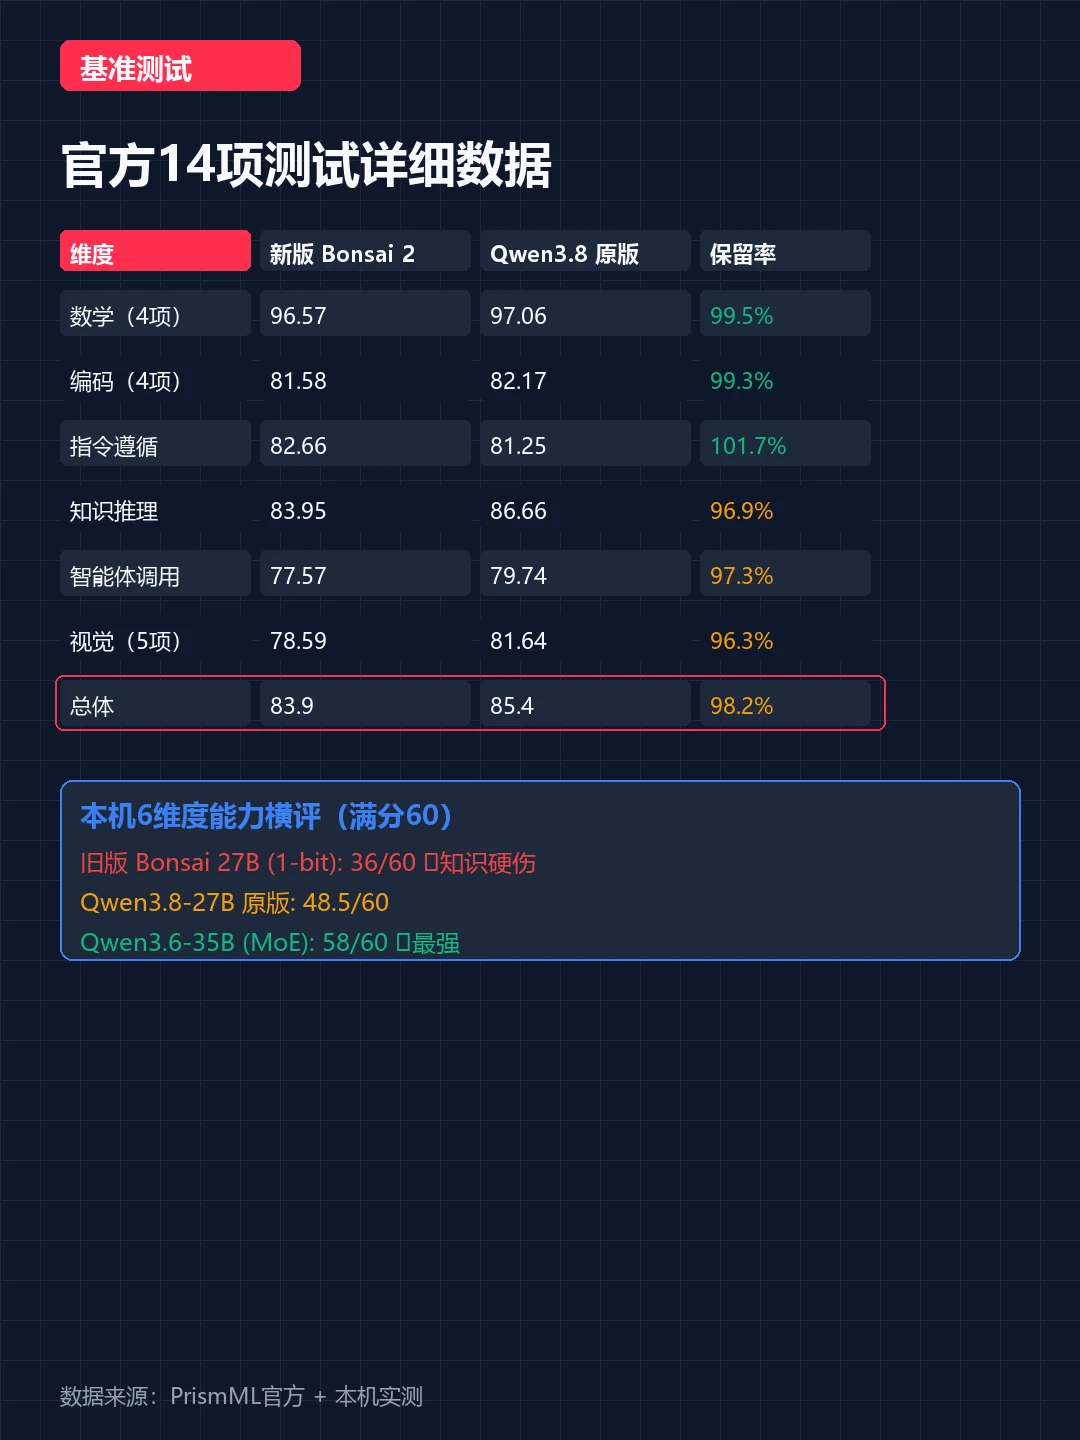
📈 官方14项基准测试(满分100)
数学(4项):96.57 vs 97.06 → 保留99.5%
编码(4项):81.58 vs 82.17 → 保留99.3%
指令遵循:82.66 vs 81.25 → 反超1.7%
知识推理:83.95 vs 86.66 → 保留96.9%
智能体调用:77.57 vs 79.74 → 保留97.3%
视觉(5项):78.59 vs 81.64 → 保留96.3%
总体:83.9 vs 85.4 → 保留98.2%
🔧 本机6维度能力横评(满分60)
旧版Bonsai 27B(1-bit):36/60 ❌知识硬伤
Qwen3.8-27B原版:48.5/60
Qwen3.6-35B(MoE):58/60 ⭐最强
旧版Bonsai知识质量有硬伤(常识题胡编)
新版声称98.2%保留,本机未重测
🤔 为什么三值量化反而快了?
三值{-1,0,+1}计算比FP4简单
省了浮点运算,纯整数更快
但比1-bit复杂,所以比旧版Bonsai慢
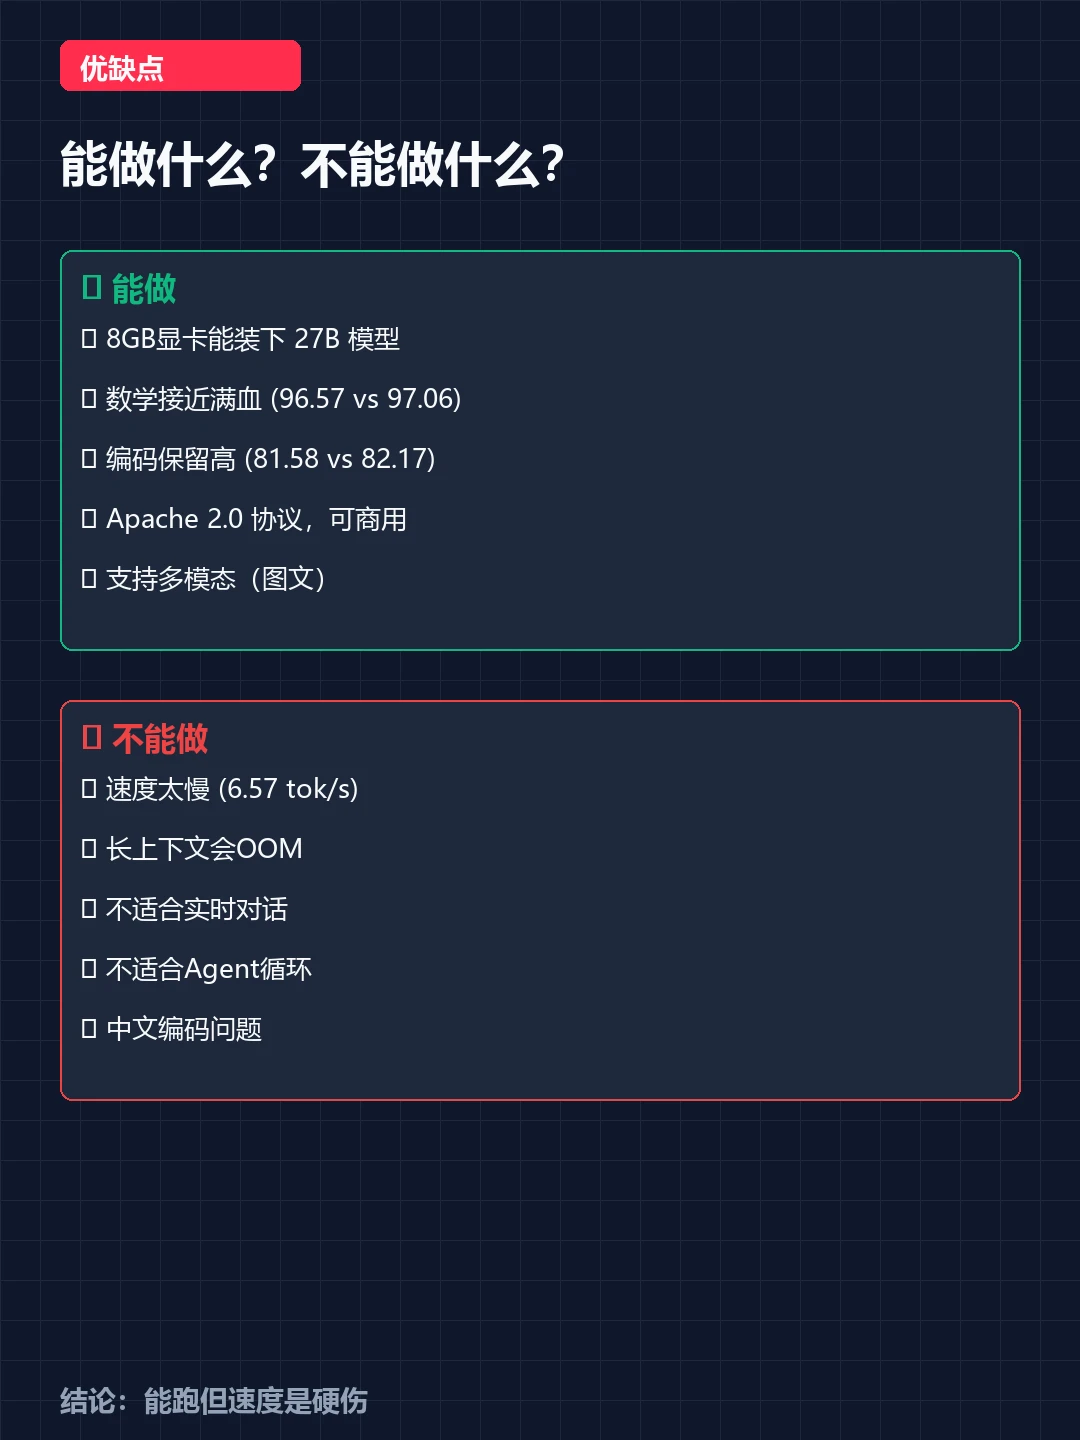
✅ 新版能做什么
8GB显卡能装(显存6957MB)
数学接近满血(96.57 vs 97.06)
编码保留高(81.58 vs 82.17)
Apache 2.0可商用
❌ 不能做什么
速度太慢,实时对话体验差
长上下文会OOM(剩余1.2GB)
不适合Agent循环
💡 一句话总结
8GB跑27B,MoE仍是最佳选择
三值量化是有趣的尝试,但速度是硬伤
👇 8GB显卡还能跑什么?关注看我逐个试
评论区扣1,我发你完整参数配置
#Qwen3.8 #Bonsai #27B #三值量化 #8GB显卡 #本地大模型 #PrismML #AI推理 #我这行的AI路