arXiv0915:语音时实交流的多模态Agent
多模态交互 Agent arXiv 网友投稿
一、整体概述
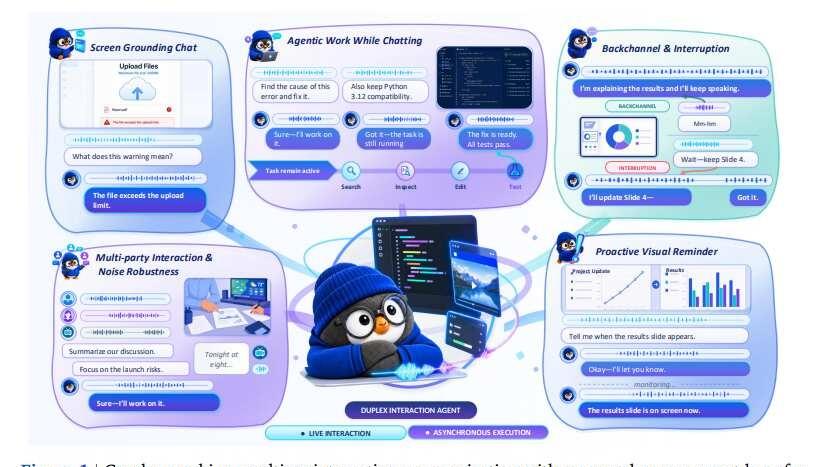
1. 论文提出Gander,一个能边听、边看、边说、边干活的多模态全双工Agent。
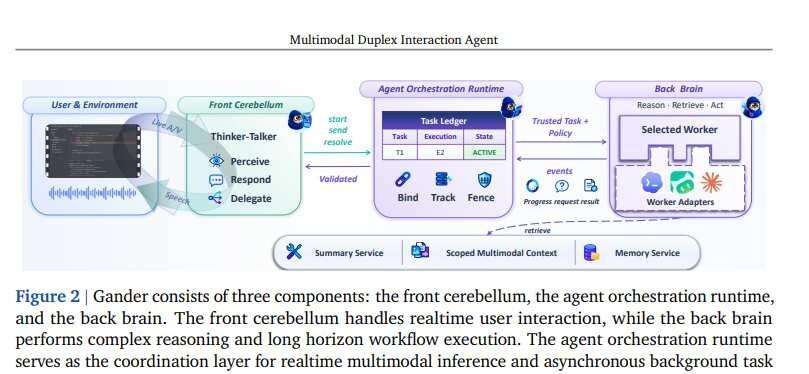
2. 它把实时交流与复杂任务执行拆成“前小脑+后大脑”,让AI在持续对话时还能异步完成搜索、写代码、处理文件等长任务。
二、研究背景
1、传统语音助手大多是“你说完,我再答”,依赖VAD等模块切分轮次,遇到停顿、插话、多人说话和噪声时容易判断失误。
2、真正的Agent还要处理长时间推理和工具调用。如果全部塞进一个模型,实时响应与深度思考会互相争抢算力。
三、动机直觉
1、作者把系统类比成人的“小脑+大脑”。小脑负责条件反射式的实时交流,大脑负责费脑子的规划和执行。
2、关键不只是让模型学会“说什么”,还要让它学会“什么时候说”。因此每秒都让模型先判断继续听、开始说,还是停止当前发言。
四、技术路线
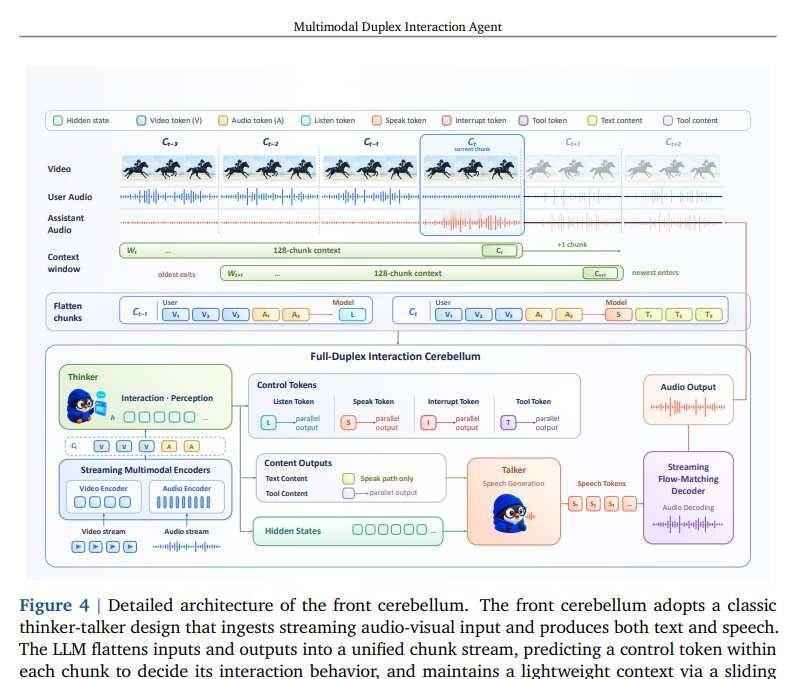
1、前小脑基于MiniCPM-o 4.5和Thinker-Talker架构,同时接收连续音频与视频。
2、音频、视觉和模型输出被按1秒切成chunk,再摊平成统一自回归序列。模型在每个chunk预测Listen、Speak或Interrupt控制状态,128个chunk构成约2分钟滑动上下文。
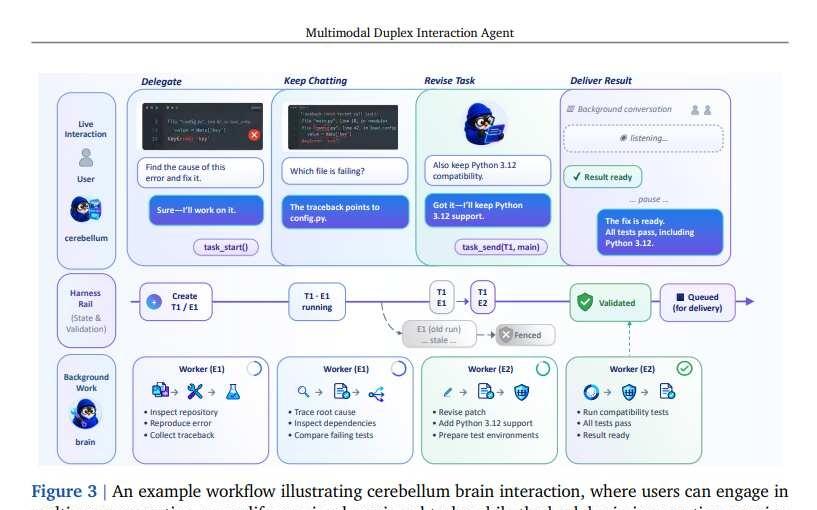
3、复杂任务通过task_start、task_send等工具调用交给后大脑异步执行,用户中途追加条件时无需等待任务结束。后大脑可直接接入Codex等通用Agent,无需重新训练。
4、训练集约270万条,覆盖语音交互、音视频交互、Agent任务以及噪声、多人场景等负样本。
五、实验结果
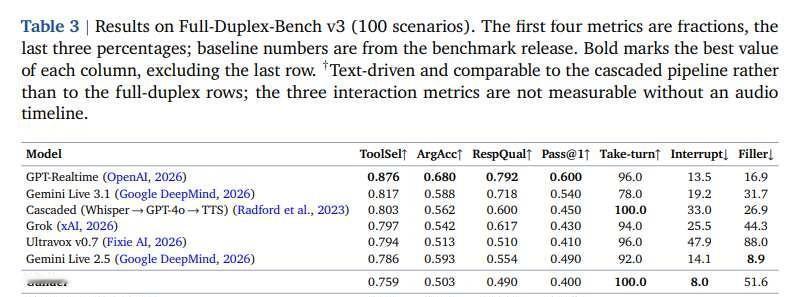
1、Full-Duplex-Bench中,Gander在100个场景的正确接话率达到100%,提前打断率仅8%,体现出较强的实时轮次控制。
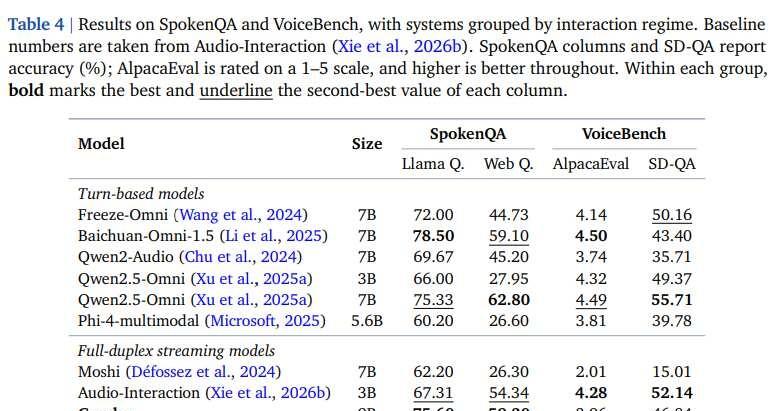
2、SpokenQA两项达到75.60和59.30,在全双工模型中表现突出。
3、音视频联合输入相较最佳单模态,在WorldSense提升5.01点,在Daily-Omni提升19.13点,说明视觉与听觉确实形成互补。
4、代价也很明确:端到端工具任务准确率仍落后部分基线,Filler率为51.6%,说明任务委派和语音反馈仍有优化空间。