分享一个最近医疗AI领域很值得关注的突破。
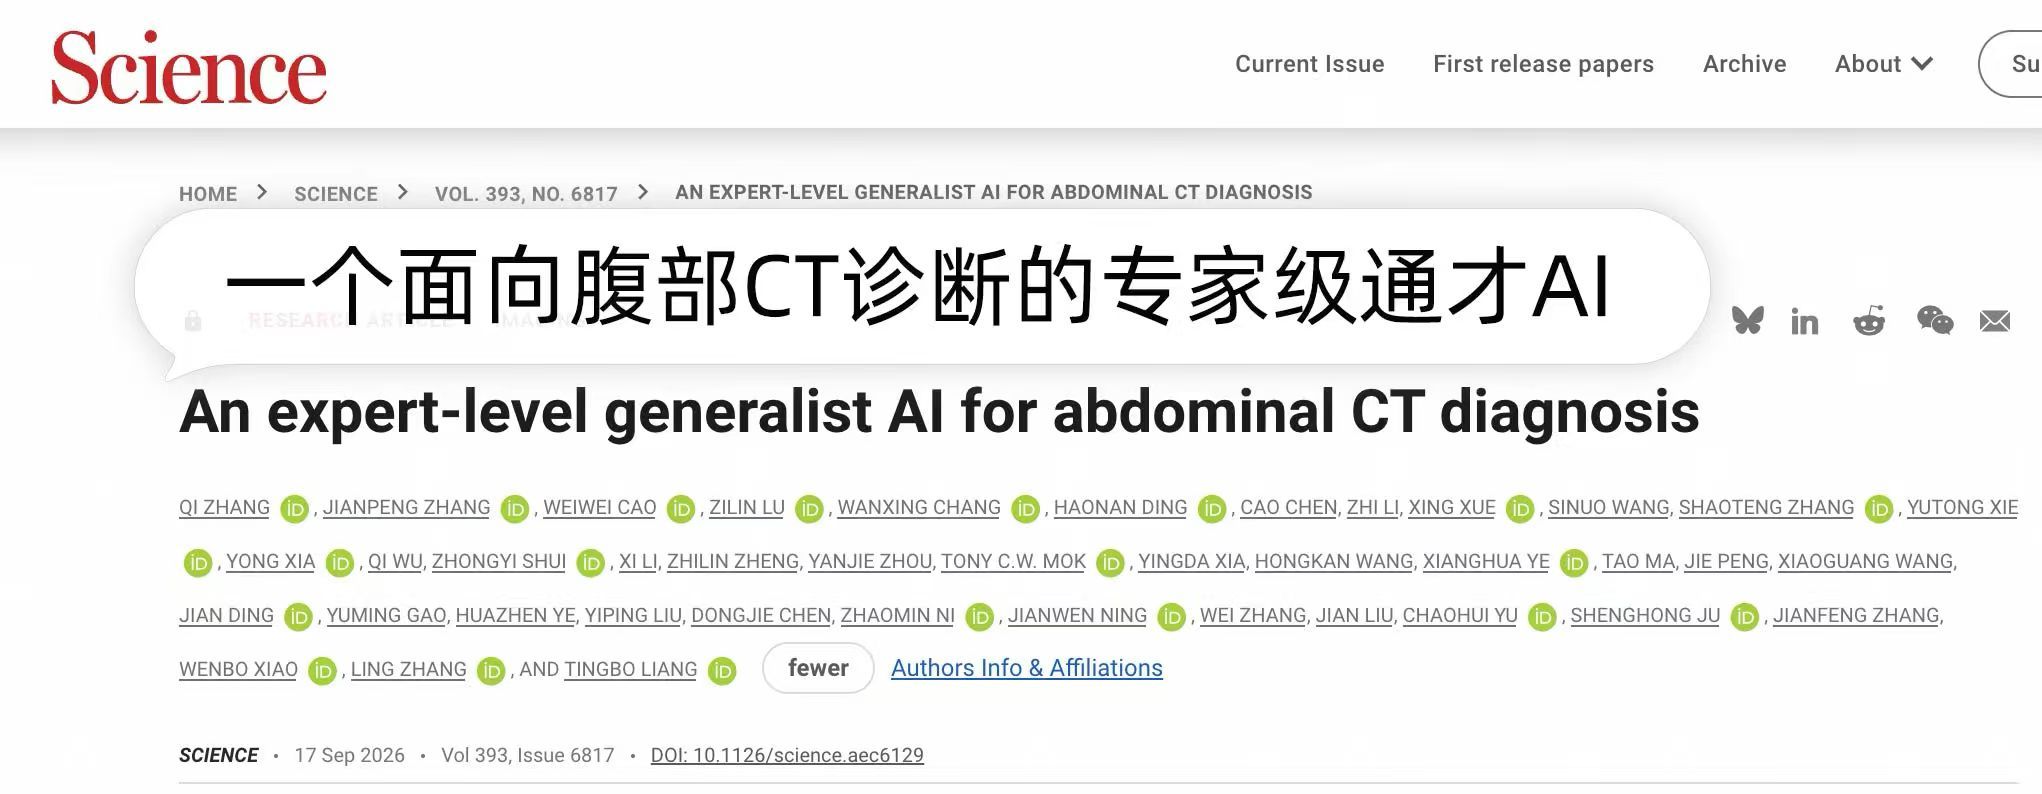
9月18日,阿里达摩院联合浙江大学医学院附属第一医院等机构,发布了一个叫DAMO RADAR的通用医疗影像AI。
相关成果登上了国际顶级学术期刊《Science》,目前已经正式开源。
这是全球首个达到影像科专家水平的通用医疗影像AI,覆盖腹部18个器官,可以识别超过146种病症。在近4万次真实世界检查里,平均AUC做到0.913。
换句话讲,它第一次让一个AI模型的水平摸到了影像科专家的线,意义重大。
1为什么这件事这么难?
过去十几年,医疗影像AI已经能在肺结节、眼底疾病和特定肿瘤等任务上取得很高的准确率。
但问题是,它们大多只能看一种病。
一个模型盯肺结节,另一个模型找胰腺癌,再来一个模型识别肠癌。它们像一群各有所长的专科选手,却没有谁能帮医生把整个腹部从头到尾看一遍。
达摩院有位算法专家叫张建鹏,他说自己做完第一个单病种AI项目之后,做第二个的时候突然有点崩溃。
因为一个病种从数据搜集、清洗、标注、训练到发布,往往要两到三年。但人类已知的疾病有上万种,按这个速度做下去,别说这辈子,可能几代人都做不完。
2那真实世界的患者呢?
假设一名患者因为上腹部不适来到医院,做了一次腹部增强CT。影像科医生拿到的不是一张照片,而是多个期相、几十甚至几百张切片。肝、胆、胰、脾、胃、肠道、肾脏和血管全部挤在里面,而且大部分都是密度接近的软组织。
有些病灶很明显,有些异常却可能只占很小一块,藏在大片灰色影像中。
还有注意力的问题。
医生会先查看患者主诉指向的区域,但一套腹部CT里,其他器官同样可能存在异常。连续高强度阅片之后,反应速度和专注程度不可避免地会下降,一个很小的病灶就可能从眼前溜走。
浙大一院放射科主任肖文波提到,即使是中高级医生,完成一份腹部CT报告通常也需要20到30分钟,疑难病例可能要看一个小时。
那该怎么办呢?
3其实第一个把通用医疗影像AI这条路径真正跑通一段的,是斯坦福。2026年3月,他们在《自然》上发表了一个叫Merlin的模型,一个模型能识别腹部CT上的30种疾病。
这在当时是个大新闻,业内很多人开始相信通才型AI是可行的。
但Merlin也有它的短板,病种覆盖有限,平均AUC大概在0.812,还没到医生的平均水平。路走通了,可是没走到临床可用的门槛。
真正把这一步跨过去的,是DAMO RADAR。
它换了一种和医生思维更接近的学习方式,让它开始真正学习“医学影像”这门语言。以前的视觉语言模型是把整张CT和整份报告直接扔进去做对齐,让AI自己去猜哪块图对应哪句话。
但这带来一个问题,腹部CT里99%的组织其实都是正常的,真正有诊断意义的病变可能只是很小一块。整体对齐,模型很容易被大量正常背景淹没,最后学到的都是些粗糙的统计特征。
DAMO RADAR的做法是,先在CT中定位肝、胆、胰、胃肠等解剖结构,再把每个器官的影像与报告里的对应描述逐一匹配。相当于先把混在一起的医学图册按器官分成章节,再让AI逐章学习。
这样,AI开始建立解剖结构、影像表现和医学语言之间的联系。它还能通过注意力图标出重点区域,让医生回到原始影像中复核。
团队把它叫做器官级细粒度对齐,也是国际上第一次这么干。
除此之外,还有一个容易被忽略的问题:不同患者的影像,该怎么比较?
常规的对比学习,会让同一个人的CT和报告尽量靠近,让不同人的数据尽量远离。但在医学里,不同患者的正常器官本来就可能很像,患有同一种病的人,也可能有相似的影像表现。如果一律把它们推远,AI反而不容易学到这些共性。
所以DAMO RADAR又加入了自适应对比建模。它会根据每个样本的具体情况,调整不同患者之间的比较方式,把影像里真正相似的医学信息也利用起来。
有AI辅助之后,影像科医生识别疾病的敏感性提高了10%,平均阅片时间减少了30.7%。
初级医生在AI辅助下的表现,甚至能追上资深医生。这套模型未来如果能上线,对基层医院和年轻医生的帮助会更明显。
4这些年,从Google和DeepMind的Med-Gemini,到OpenAI建立HealthBench,全球科技公司都在进入医疗领域。
因为医疗可能是检验通用AI能力最严格的场景之一。模型不仅要准确,还要处理不确定性、适应不同人群和医院,并且让医生能够理解和复核它的判断。
从这个角度看,DAMO RADAR登上《Science》的意义,不只是阿里在医疗AI赛道上拿到了一项新成绩,而是证明了一条过去并不确定的路线:医疗影像AI可以不再被困在“一病一模”里。
通过学习解剖结构、影像和语言之间的关系,一个模型有机会形成更广泛的诊断能力。
当然,DAMO RADAR目前仍处于回顾性研究阶段,距离在真实临床中大规模应用,还需要前瞻性研究和更长期的检验。但它让我们看到了,医疗AI下一阶段可能是什么样子。
这一次,中国团队在这条路上迈出了很关键的一步。