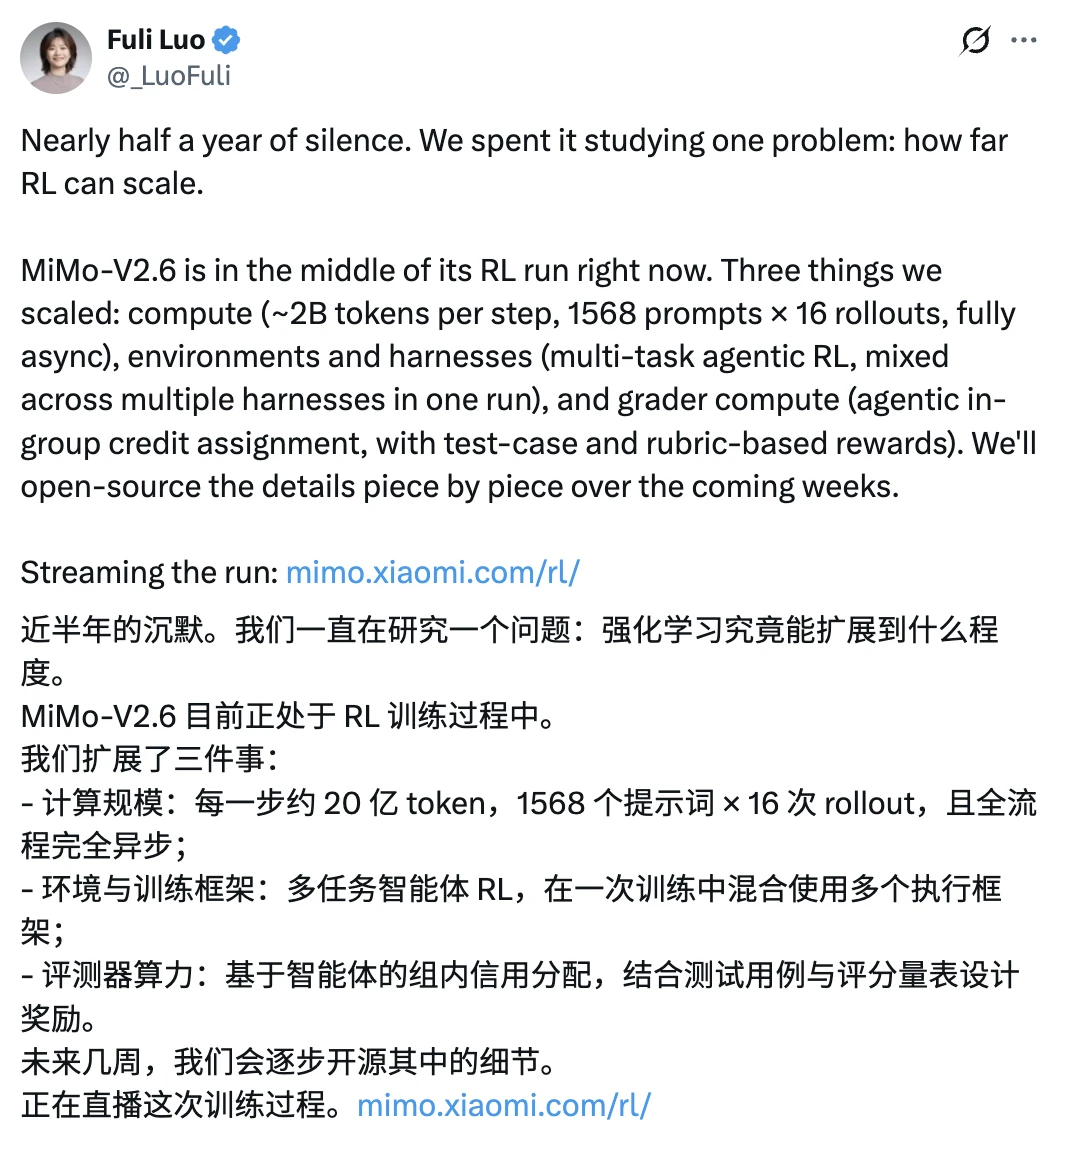
小米 MiMo 团队负责人罗福莉沉寂近半年后,官宣直播下一代 MiMo-V2.6 的强化学习训练——他们一直在研究一个核心问题——强化学习(RL)到底能扩展到多远。
目前MiMo-V2.6正处于大规模RL训练中,还没结束。团队公开了三块关键放大的内容:
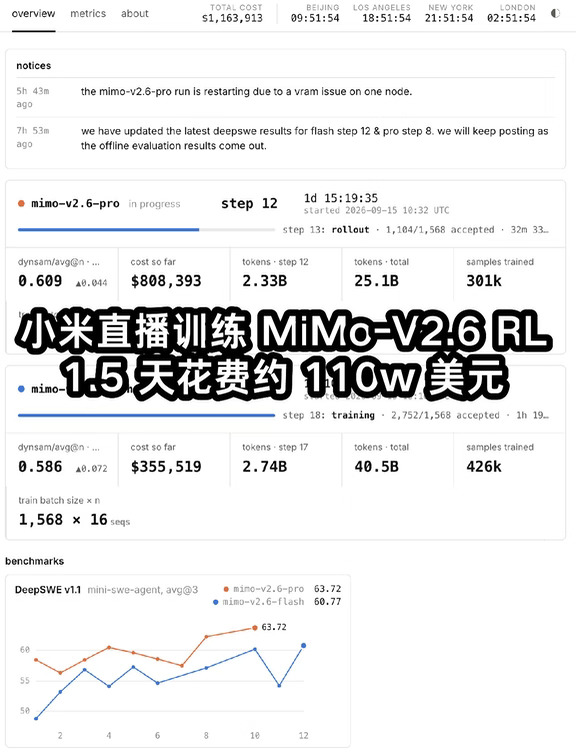
- 算力规模:每一步约消耗 20亿token(1568条prompt × 16次rollout),完全异步推进。
- 环境与Harness:多任务Agent式RL,一次run里混合多种任务环境和执行框架。
- Grader算力:Agent式组内信用分配,结合测试用例和评分标准奖励。
他们把整个训练过程做成了公开实时直播仪表盘,有web页面可直接实时看到:
- Pro和Flash两个版本并行跑
- 当前step、accepted数量、pass rate、DeepSWE分数
- 已消耗token、样本数
- 实时烧钱数字
截至发帖前(约 1.5 天左右):
- Pro 已花约 79.5 万美元
- Flash 已花约 34.9 万美元
- 合计约 110 万美元(约 800 万人民币)
团队表示相信RL是通向自我提升最可扩展、最高效的路径之一,后续会逐步开源细节。
这大概是目前最公开、最硬核的大模型后训练直播之一——直接把RL scaling的过程摊在所有人面前,边跑边看,边烧钱边进化。
#MiMo #罗福莉 #小米MiMo #大模型 #mimov26